Service Level Agreement — поддержка и сопровождение

Целевые значения и процессы для инцидентов, дефектов и уязвимостей. Документ применяется к заказной разработке на инфраструктуре клиента; обязывающие условия фиксируются в SOW. Каждый раздел — короткие тезисы и сводные таблицы для быстрой оценки отделом закупок, CTO и службой безопасности.
Тикет — единый канал учёта
CET/CEST · 24×7 по плану
S1 · первая реакция ~20 мин
S1 · восстановление до 4 ч
Уведомление об инциденте безопасности до 48 ч
EN · RU · DE
Главное

Ключевые факты

SLA описывает целевые значения для инцидентов, дефектов и уязвимостей. По умолчанию — рабочие часы CET/CEST; круглосуточное дежурство (24×7) — по тарифу. Для критичных инцидентов восстановление сервиса приоритетнее глубокого анализа первопричины (RCA).

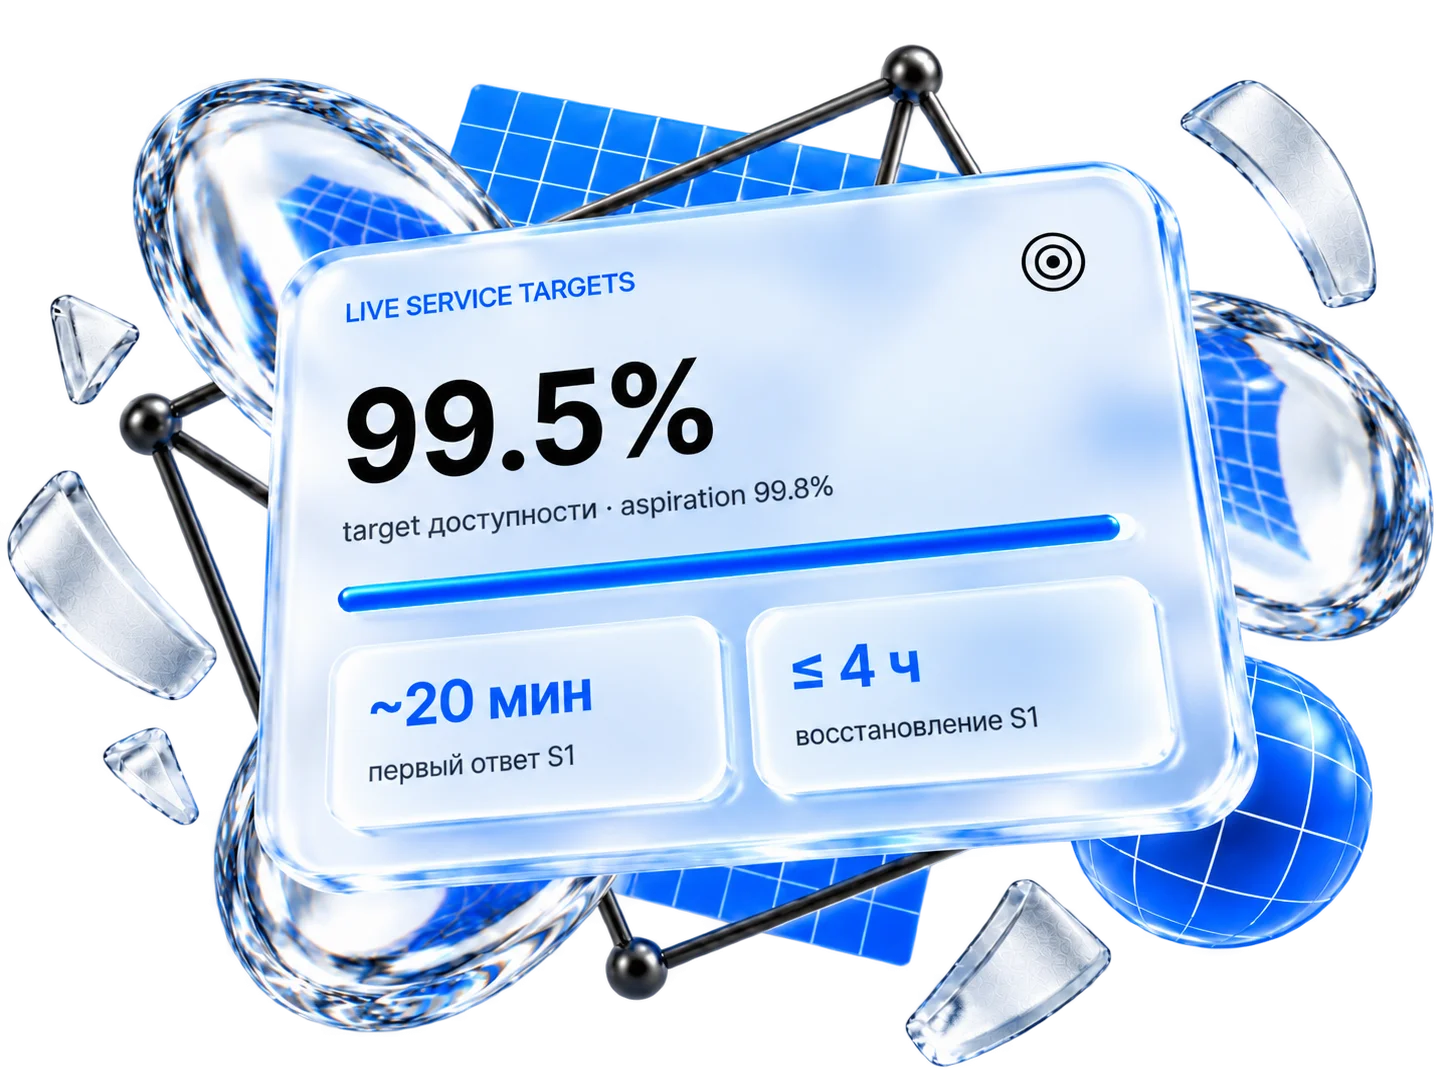
~20 мин

первая реакция на S1 в рабочие часы

≤ 4 ч

восстановление S1 (в зоне нашего контроля)

99.5%

целевая доступность (ориентир 99.8%)

3

плана: Basic · Extended · Enterprise

Канал

Тикет — единый канал учёта по SLA

Обращения из чатов могут фиксироваться в тикетах для учёта и отчётности.

Покрытие

CET/CEST по умолчанию

Расширенные часы и круглосуточное дежурство — по плану. Структурное преимущество для клиентов из США.

Подход

Сначала восстановление

Для S1/S2 минимальное восстановление сервиса приоритетнее полного устранения первопричины.

Онбординг

Обязателен для реалистичных показателей

Без онбординга точные целевые значения SLA не устанавливаются — особенно для унаследованных систем.

Языки

EN · RU · DE

Полная поддержка EN/RU. DE — доступно. Прочие — по согласованию. Перевод с помощью ИИ — опционально.

Контракт

Условия — в SOW

Сервис-кредиты, RPO/RTO, матрица эскалации, уведомление об инцидентах безопасности, QBR — в приложении к договору.

Правовая информация

Правовая оговорка / Отказ от ответственности SLA

Настоящий документ описывает целевые показатели и процессы и не является гарантией в значении §§ 443, 633 Гражданского уложения Германии (BGB). Обязательные обязательства по оказанию услуг, ответственность, гарантийные обязательства и сервисные компенсации возникают исключительно из индивидуально заключённого договора / SOW.

Рамки соглашения

Область действия SLA: что покрыто, исключения, границы ответственности

SLA покрывает заказную разработку на инфраструктуре клиента. Действует модель разделённой ответственности: код и развёртывание — наша зона; инфраструктура и сторонние сервисы — зона клиента. Если первопричина вне нашего контроля, обеспечиваем диагностику и координацию.

В области действия

Инциденты в продуктивной среде — доступность и ключевые процессы

Исправление ошибок в критичных процессах: оформление заказа, платежи, вход в аккаунт

Уязвимости и инциденты безопасности (высокий приоритет)

Координация со сторонними поставщиками (по плану)

Исключения

Отказы дата-центров и инфраструктуры вне нашего управления

Отказы сторонних сервисов (платёжные системы, API, сервисы email-рассылок)

Подсистемы, не разработанные нашей командой (только диагностика)

Случаи, когда не предоставлен необходимый доступ

Модель разделённой ответственности

Уровень
Наша ответственность
Ответственность клиента
Приложение
Код, бизнес-логика, развёртывание и релизы, диагностика инцидентов, мониторинг в согласованном объёме
Бизнес-решения о принятии мер по снижению влияния, приоритизация изменений
Инфраструктура
Конфигурация компонентов под нашим управлением
Серверы, сеть, DNS, балансировщики нагрузки, выдача доступов и управление учётными данными
Сторонние сервисы
Диагностика, подтверждающие данные, координация с поставщиком (по плану)
Договоры с поставщиками (платежи, email, CDN)
Совместно
CI/CD, администрирование БД, практики безопасности (уровень приложения и уровень инфраструктуры) — границы определяются на онбординге и фиксируются в SOW

Когда первопричина вне нашего контроля, мы определяем проблемную зависимость, предоставляем технический контекст и логи, выступаем посредником в коммуникации с поставщиком (если включено в план), фиксируем выводы в тикете и предлагаем меры по снижению влияния на нашей стороне.

Глоссарий

Определения: тикет, инцидент, дефект, запрос на изменение, первая реакция

Тикет — базовая единица учёта по SLA. Инцидент — сбой в продуктивной среде. Дефект — некорректное поведение существующей функции. Запрос на изменение — плановая работа, а не инцидент. Срочные изменения с внешними сроками могут быть приоритизированы вне очереди.

Тип
Определение
Примеры
Тикет
Основной объект для учёта, сортировки обращений, эскалации и отчётности
Учёт по SLA ведётся по тикетам
Инцидент
Сбой, влияющий на доступность или ключевую функциональность в продуктивной среде
Полная или частичная недоступность, HTTP 500, отказ развёртывания или инфраструктуры
Дефект
Некорректное поведение существующей функции
Товар не добавляется в корзину, ошибки оплаты, сбой личного кабинета
Запрос на изменение
Плановое изменение или улучшение — оценивается и планируется
Новый интерфейс, новая функция, новая бизнес-логика
Срочное изменение
Изменение с внешним сроком — приоритизируется вне обычной очереди
Регуляторное требование, кампания с жёсткими сроками

Первая реакция · Восстановление · Полное устранение

Первая реакция

Подтверждение и начало работ

Тикет принят, команда подтвердила получение и начала работу. Эскалация — если нужны другие роли.

Временное устранение

Минимальное восстановление

Возврат сервиса к рабочему состоянию, даже в режиме ограниченной функциональности. Подход по умолчанию для критичных инцидентов.

Полное устранение

Устранение первопричины

Полное исправление первопричины. В сложных случаях — после восстановления сервиса.

График работы

Часы поддержки, часовые пояса, праздники, языки

Покрытие по умолчанию — рабочие часы CET/CEST. Расширенное покрытие включает реакцию в нерабочее время, дежурного инженера с перекрытием по часовому поясу клиента и планирование релизов в удобные окна. Календарь праздников согласуется с местом оказания услуг и фиксируется в SOW.

Базовое покрытие
CET / CEST
рабочие часы
Extended
Нерабочее время · дежурство
по плану
Enterprise
Дежурство 24×7
по плану
Преимущество для США
Ночь в США = день у нас
без доплат за дежурство
Календари праздников
MD · DE · US
фиксируется в SOW
Часовые пояса СНГ
По договорённости

Поддерживаемые языки

Английский — полностью Русский — полностью
Немецкий — доступен Другие — по согласованию Перевод с помощью ИИ — опционально
Как обратиться

Каналы приёма заявок и обязательные данные

Официальный канал учёта по SLA — тикет-система. Запрос должен содержать описание, временное окно, место (страница / маршрут / API), влияние на бизнес и, по возможности, скриншоты, логи, идентификаторы трассировки (trace ID). Без необходимого доступа поддержка может быть ограничена изменениями на уровне репозитория.

Минимальные поля в запросе
01

Что произошло — короткое описание

02

Когда — временное окно

03

Где — страница / маршрут / API / окружение

04

Влияние на бизнес — что заблокировано, кто затронут

05

Критичность — оценка от клиента (по возможности)

06

Материалы — скриншоты, логи, trace ID, сообщения об ошибках

Доступ и операционные ограничения

Без доступа к продуктивной среде поддержка ограничена изменениями на уровне репозитория

Сбои инфраструктуры (CI/CD, среда выполнения) не решаются без доступа к соответствующему уровню

Требования к доступу устанавливаются на онбординге

Чаты можно использовать, но обращения обязательно фиксируются в тикетах для учёта по SLA

Уровни срочности

Модель приоритетов: критичность S1–S4 и соответствие P0–P4

Четырёхуровневая модель критичности, совместимая с принятой в корпоративной практике шкалой приоритетов P0–P4. S1/P0 — полная или частичная недоступность. S2/P1 — серьёзное ухудшение работы при наличии обходного решения. S3–S4 — ограниченное влияние, плановая очередь.

Критичность / приоритет
Влияние на бизнес
Типичные примеры
S1 / P0 · Критический
Блокирует бизнес — недоступность сервиса, ключевой процесс заблокирован, инцидент безопасности с риском утечки данных
Сервис недоступен, заблокированы платежи, оформление заказа или вход, утечка данных, подмена содержимого сайта
S2 / P1 · Высокий
Высокое влияние — серьёзное ухудшение работы, есть обходное решение
Проблемы с индексацией в поисковых системах, важные страницы не работают, второстепенный процесс работает со сбоями
S3 / P2 · Средний
Среднее влияние — функциональные дефекты с ограниченным влиянием
Ошибка в отчёте, редкий сценарий в форме, некорректные подписи полей
S4 / P3–P4 · Низкий
Очередь задач — косметические недочёты, мелкие правки интерфейса
Цвет кнопки, тексты, мелкие правки вёрстки
Срочное изменение
Внешний срок — приоритет может быть повышен из-за внешнего срока
Регуляторное требование, кампания с жёсткими сроками, событие
Сроки реакции

Целевые показатели: реакция, восстановление, коммуникация

Финальные целевые значения зависят от плана и фиксируются в SOW. Типовая первая реакция на S1 в рабочие часы — ~20 мин. Цель восстановления для S1 — до 4 ч (когда причина в нашей зоне контроля). Частота обновлений статуса — от каждых 30 мин (Enterprise) до каждых 4 ч (Basic).

Восстановление и полное устранение

Цель
S1 · Критический
S2 · Высокий
Примечание
Первая реакция
~20 мин
по плану
Рабочие часы; быстрее на старших планах
Восстановление сервиса (временное устранение)
до 4 ч
до 8 ч
Когда причина в нашей зоне контроля
Полное устранение (исправление первопричины)
по мере возможности
по мере возможности
Зависит от сложности; фиксированный срок не гарантируется

Частота обновлений по тарифу

План Basic (Start)
S1 · активный инцидент каждые 4 ч
S2 на ключевых этапах
Каналы тикет
План Extended (Pro)
S1 · активный инцидент каждые 2 ч
S2 ежедневно
Каналы тикет
План Enterprise
S1 · активный инцидент каждые 30 мин
S2 каждые 4 ч
Каналы тикет + чат + email

Этапы коммуникации

Шаг 01

Принято

обращение принято, работа начата

Шаг 02

Диагностика

зона отказа локализована

Шаг 03

Восстановлено

временное устранение применено

Шаг 04

Устранено

полное исправление выпущено

Шаг 05

Рекомендации

RCA-разбор и дальнейшие шаги

Пауза

Заблокировано

нет доступа или данных от клиента

Если прогресс заблокирован отсутствием доступа или данных от клиента, работа может быть приостановлена. Время ожидания засчитывается, если не согласовано иное, поскольку инцидент невозможно устранить без необходимых условий.

Подключение руководства

Эскалация: роли, уровни, подключение руководства

Трёхуровневая схема: дежурный инженер → техлид / руководитель проекта → CTO / архитектор. Эскалация запускается немедленно, если не хватает знаний предметной области или доступа. Для Enterprise временные пороги фиксируются в SOW.

Уровни эскалации

L1

Дежурный / назначенный инженер — первым берёт инцидент в работу

L2

Руководитель проекта / техлид — отвечает за предметную область

L3

CTO / архитектор — сложные и критичные случаи

L4

CEO — финансовые потери, репутационный риск

Временные пороги (S1, Enterprise)

Время без начала работ
Уведомляется
4 часа
Техлид проекта
8 часов
CTO
12 часов
CEO

Когда происходит эскалация

Немедленно

Не хватает знаний предметной области

У первого ответственного нет экспертизы в платежах или инфраструктуре либо нужного доступа.

По ходу работ

Расследование уходит вглубь

Расследование затрагивает подсистему, к которой у нас нет доступа, или требует другой экспертизы.

Руководство

Прямые потери / безопасность

Финансовые потери, репутационный инцидент, инцидент безопасности — нужно быстрое сдерживание.

Реагирование на сбои

Управление инцидентами · RCA · мониторинг

Для S1/S2 сначала восстанавливаем сервис, потом проводим глубокий анализ. Меры по снижению влияния — отключение функции, блокировка маршрута, срочное исправление. RCA-разбор — после стабилизации, в сжатом формате. Мониторинг по плану: синтетические проверки доступности, контроль срока действия сертификатов, проверки содержимого страниц, метрики инфраструктуры.

Меры по снижению влияния

A

Отключить или ограничить функцию

Временное отключение проблемного блока, чтобы не допустить каскадных сбоев.

B

Заблокировать маршрут или адрес API

Изоляция перегруженного маршрута, чтобы остановить распространение нагрузки.

C

Экстренное снижение нагрузки

Снижение нагрузки на инфраструктуру до диагностики приложения.

D

Точечное срочное исправление

Узкое исправление конкретной проблемы, когда причина ясна.

E

Экстренный откат

Откат недавнего изменения при подозрении на регрессию.

F

Ограниченный режим

Работа с ограниченной функциональностью, пока продолжается полное восстановление.

RCA-разбор инцидента

Этап
Что включает
Во время инцидента
Краткое операционное объяснение по наблюдаемым симптомам и ранней диагностике
После стабилизации
Структурированный RCA-разбор: что произошло → почему → что сделано → рекомендации по предотвращению
Формат
Практичный, обобщённый; подробная хронология — только по запросу

Мониторинг по плану

Уровень
Возможности
Доступно для
Базовый
Синтетические проверки доступности; оповещения, если адрес недоступен или отвечает ошибкой
Все планы
Контроль сроков
Сертификаты, домены, оповещения об истечении срока
Все планы
Расширенный
Проверки содержимого (HTML-маркеры); метрики инфраструктуры и нагрузки
Extended · Enterprise
Оповещения 24×7
Круглосуточные оповещения с реакцией дежурного инженера
Enterprise
Уведомления
Проактивные уведомления о критичных инцидентах; о мелких, быстро устранённых проблемах можно не уведомлять — настраивается
По плану
Информационная безопасность

Уязвимости и инциденты безопасности

Уязвимости и инциденты безопасности — высокий приоритет: сдерживание, сокращение окна уязвимости, привлечение старших технических специалистов. Для Enterprise срок уведомления о подтверждённом инциденте — до 48 часов (до 24 часов по отдельному соглашению). Клиента уведомляют и о найденных уязвимостях высокого риска до подтверждения их эксплуатации.

Принцип 1

Сначала сдерживание

Быстрые меры, чтобы закрыть окно уязвимости до глубокого анализа.

Принцип 2

Проверка

Подтверждение, что уязвимость заблокирована или находится под контролем.

Принцип 3

Участие старших специалистов

Привлечение старших технических ролей при необходимости.

Уведомление клиента

Сценарий
Действие
Срок (Enterprise)
Инцидент в продуктивной среде / внешнее сообщение о проблеме
Клиент уведомлён и получает информацию по ходу работ
немедленно при подтверждении
Подтверждённая утечка данных / несанкционированный доступ
Формальное уведомление по договору
до 48 ч · 24 ч по отдельному соглашению
Уязвимость высокого риска, найденная нами
Клиент уведомлён, чтобы подготовить юридические, операционные и коммуникационные меры
до подтверждения эксплуатации
Уязвимость низкого риска, быстро исправленная
Уведомление может не отправляться, чтобы не создавать лишний шум

Практики безопасной разработки

Ревью кода Контроль зависимостей Ролевой доступ · минимальные права Логирование и мониторинг Управление секретами Обновление фреймворков SAST / DAST — по SOW Тестирование на проникновение — по SOW Моделирование угроз — по SOW

Сертификация. SOC 2 / ISO 27001 на текущий момент не оформлены; получение запланировано в горизонте 12–15 месяцев. Опросник по безопасности с описанием применяемых мер контроля — по запросу.

Инженерные стандарты

Данные, доступы, качество кода и тестов

По умолчанию данные обрабатываются на инфраструктуре клиента. Тестовая среда у Webdelo — только для некритичных проектов или при отсутствии доступа к продуктивным данным (с тестовыми данными). При расторжении договора доступы отзываются контролируемо. Целевое автоматизированное тестовое покрытие — не менее 90%, для критичных бизнес-путей — 100%.

Модель работы с данными

Сценарий
Как работаем
По умолчанию
Данные на инфраструктуре клиента; доступ через VPN, SSH или промежуточные узлы (bastion) по согласованию
Тестовая среда для некритичных проектов
Размещение у Webdelo допустимо; в работе — тестовые или анонимизированные данные
Продуктивные данные в тестовой среде
Только с явного согласия клиента и с дополнительными мерами безопасности
Чувствительные данные
Клиент сообщает о таких системах; сужается круг доступа и исполнителей, при необходимости — отдельные соглашения с членами команды; работа только на инфраструктуре клиента без локальных копий
Расторжение договора
Контролируемый отзыв доступов; проверка, что на стороне Webdelo не осталось копий (если временные копии были разрешены)

Качество кода и тестовое покрытие

Стандарт
≥ 90% автоматизированных тестов

Модульные и интеграционные тесты; типы и глубина — по проекту в SOW.

Критичные бизнес-пути
100% — без исключений

Платежи, данные клиентов, ключевая бизнес-логика, аутентификация — полное покрытие.

Ревью кода
Все изменения продуктивного кода

Статический анализ в CI/CD; SAST/DAST — по SOW.

Если клиент решает сократить тестовое покрытие для оптимизации бюджета, решение фиксируется письменно (тикет, email, дополнение к SOW). Клиент принимает связанные риски: рост вероятности регрессий, увеличение времени диагностики и стоимости будущих изменений; решение и его влияние фиксируются в реестре рисков проекта.

Релизный процесс

Управление изменениями: согласование, окна, откат, экстренные изменения

Изменения проходят структурированный процесс согласования через тикет. Для Enterprise возможна интеграция с процессом клиента (спринты, комитет по изменениям). План отката обязателен для критичных изменений. Экстренные изменения при полном отказе могут применяться без предварительного согласования; клиент уведомляется сразу после.

Тип
Процесс
Откат
Стандартное
Тикет → оценка → планирование → развёртывание после подтверждения клиента
Готовность к откату как стандартная инженерная практика
Enterprise / интегрированный процесс
Координация через процесс клиента: планирование спринтов, комитет по изменениям, этапы согласования
Фиксируется в SOW
Критичное
Изменения ключевых процессов, миграции БД, изменения инфраструктуры
Обязательный план отката, описанный в тикете до развёртывания
Экстренное
Полный отказ из-за недавнего изменения → немедленный откат или срочное исправление без предварительного согласования
Возвращает рабочее состояние; клиент уведомляется сразу после

Что считается изменением

Развёртывание кода (новые функции, исправления, рефакторинг)

Обновление зависимостей и фреймворков

Конфигурация (переменные окружения, маршрутизация, правила доступа)

Изменения инфраструктуры в зоне нашего управления

Окна обслуживания

Небольшие проекты — развёртывание в рабочие часы без формального окна

Enterprise и критичные системы — окно фиксируется в SOW

Расписание под рабочие часы клиента (ночь / раннее утро)

Лица, уполномоченные согласовывать изменения, фиксируются в SOW

Пакеты услуг

Тарифные планы поддержки: Basic · Extended · Enterprise

Три плана с растущим уровнем покрытия и обязательств. Цены не публикуются: стоимость зависит от стека, числа интеграций, требуемого грейда инженеров, требований к коммуникации, отчётности и обработке данных. Все условия фиксируются в SOW.

Параметр
Basic (Start)
Extended (Pro)
Enterprise
Часы покрытия
рабочие часы CET/CEST
+ расширения по выбору
круглосуточное дежурство 24×7
Первая реакция
по мере возможности
быстрее по плану
наивысший приоритет
Мониторинг
базовый
+ расширенные проверки
настраиваемые метрики + 24×7
Участие старших специалистов
стандартная эскалация
техлид
эскалация до CTO / CEO
Частота обновлений по S1
каждые 4 ч
каждые 2 ч
каждые 30 мин
Сервис-кредиты
SOW · до 30%
Матрица эскалации
SOW · 4/8/12 ч
RPO/RTO
SOW · после аудита
Уведомление об инцидентах безопасности
SOW · до 48 ч
Сервис-ревью (QBR)
SOW · ежеквартально
Целевая доступность
по плану
SOW · 99.5% (ориентир 99.8%)
Тикет-система
портал
Jira
+ интеграция (Jira Service Management, ServiceNow, PagerDuty)

Доступность 99.5%: где она применима

99.5% (ориентир 99.8%)

— для систем, где у нас полный доступ к уровню приложения и процессу развёртывания, а инфраструктура стабильна и под достаточным контролем. Не публикуется как безусловная гарантия: зависит от хостинг-провайдера, сторонних сервисов, своевременности доступов от клиента и зрелости архитектуры. Цели для конкретного проекта фиксируются в SOW после аудита.

Почему цен нет на странице

Стек

Сложность технологий

Микросервисы на Go, Laravel, Symfony, унаследованные системы, смешанные среды.

Интеграции

Третьи стороны

Платежи, внешние API, поставщики данных — каждая интеграция увеличивает сложность.

Грейд инженеров

Ведущие инженеры или стандартная команда

Состав команды зависит от критичности и сложности системы.

Коммуникация

Частота и каналы

Частота обновлений, режим 24×7, число каналов напрямую влияют на стоимость.

Отчётность

Инструменты и интеграции

Jira, ServiceNow, доступ к дашбордам, индивидуальные отчёты.

Безопасность

Глубина практик

Аудиты, тестирование на проникновение, ограничения на ИИ и обработку данных.

Договорные обязательства

Enterprise · договорные приложения (SOW)

Шесть областей договорных обязательств в Enterprise-плане: сервис-кредиты, матрица эскалации, частота обновлений статуса, RPO/RTO, уведомление об инцидентах безопасности, сервис-ревью (QBR). Все условия фиксируются в SOW и могут адаптироваться с пересчётом стоимости поддержки.

Сервис-кредиты

Основание

Работы по S1 не начаты в пределах целевого времени первой реакции

Размер

от 2% месячной стоимости поддержки за инцидент

Лимит

не более 30% месячной стоимости поддержки за период

Форма

Сервис-кредит — скидка на следующий расчётный период

Применение

Только ко времени первой реакции, не к сроку полного устранения

Адаптация

Проценты, лимиты, метрики настраиваются с пересчётом стоимости поддержки

Аварийное восстановление: RPO / RTO и бэкапы

RPO / RTO

Определяются для каждой системы после аудита

Состав

БД, файловые хранилища, кеши, очереди и пр.

Метод

полный / инкрементальный / дифференциальный

Хранение

Срок хранения — в SOW

Согласованность

MySQL + Redis + MongoDB и иные комбинации

Тест восстановления

Рекомендация — не реже 1 раза в месяц для продуктивных систем

Тестирование аварийного восстановления

Частота

Ежемесячно — рекомендация

Для критичных систем — раз в две недели или еженедельно, если клиент готов выделить бюджет.

Охват

Файловая система + все БД

Файловая система и все базы (реляционные, NoSQL, кеши, очереди).

Тестовые маркеры

Маркеры в данных

Записи-маркеры готовятся заранее — так проверяется восстановление и старых, и новых данных.

Сервис-ревью · QBR

Частота Ежеквартально · входит в Enterprise
Исходные данные

Отчёт по тикетам, основные инциденты, риски стабильности

Результат

План действий, улучшения мониторинга, рекомендации по стабилизации и рефакторингу

Частота Ежемесячно · опционально, оплачивается отдельно
Исходные данные

То же + углублённый анализ трендов

Результат

Расширенные рекомендации

Передача проекта

Онбординг · унаследованные системы · непрерывность

Онбординг обязателен для реалистичных целевых значений: настройка доступа, обзор архитектуры и зависимостей, выявление критичных бизнес-процессов, анализ истории инцидентов, согласование мониторинга. Для унаследованных систем этот этап дольше, а тот же уровень гарантий, что для систем собственной разработки, обеспечить нельзя. Непрерывность обеспечивается документацией, регламентами и снижением зависимости от отдельных специалистов.

Онбординг · сроки

Тип системы
Срок
Замечание
Стандартное веб-приложение
от 1 недели
Готовность к базовым целевым значениям SLA
Сложная DevOps-среда (Kubernetes, CI/CD)
дольше
Требует практической проверки
Крупная корпоративная система
до нескольких месяцев
Онбординг и стабилизация

Онбординг нового члена команды

Уровень
Срок
Условия
Минимум
от 2 недель
Хорошо задокументированные проекты, ограниченный объём
В среднем
3–4 недели
Проекты средней сложности
Сложные / унаследованные
дольше
Зависит от документации, тестов, разрешения на ИИ-инструменты и объёма сервисов

Унаследованные системы — принципы

01

Не препятствие

Унаследованный код — не повод отказаться от проекта.

02

Честные ожидания

Мы не можем обеспечить тот же уровень гарантий, что для систем собственной разработки.

03

Онбординг критичен

Обследование архитектуры, карта зависимостей, оценка рисков.

04

Постепенное улучшение

Сначала стабилизация, затем плановый рефакторинг как отдельное направление работ.

05

Бюджет на обследование

Начальная оценка определяет реалистичные цели SLA.

06

Тесты + документация

Самый быстрый путь к более высокому уровню сервиса.

Непрерывность и управление знаниями

Практика
Что обеспечивает
Архитектурная документация
Обязательна для проектов с активной поддержкой; для унаследованных систем на онбординге выделяется отдельное время
Регламенты · чек-листы
Для повторяемых операционных задач
Зависимость от ключевых людей
Минимум 2 специалиста с пересекающимися знаниями для критичных проектов
Анализ с помощью ИИ (опционально)
Анализ кода, логов, интеграций и истории инцидентов при участии специалиста; ускорение рутинных задач в 5–20 раз (ориентир по внутреннему опыту, не гарантия)
Внешние ИИ-сервисы
Только с явного согласия клиента; варианты — локальные модели или полный запрет
Завершение сотрудничества
Документация, регламенты, список доступов, отчёт о рисках; объём зависит от тарифа

FAQ: быстрые ответы для проверки закупками и инженерией

Ответы на ключевые вопросы: официальный канал — тикет-система, покрытие — CET/CEST с опцией 24×7, модель критичности S1–S4 (P0–P4), первая реакция ~20 минут (критические), ориентир восстановления S1 — до 4 часов (в нашей зоне ответственности), целевая доступность 99,5% (SOW), сервис-кредиты для Enterprise (SOW), эскалация с порогами 4/8/12ч, обновления статуса от 30 минут (Enterprise S1) до 2 часов (Extended S1), управление изменениями с планами отката, данные на инфраструктуре заказчика, сертификация не получена (план 12–15 месяцев), ИИ-поддержка опционально, русский/английский/немецкий, цены — в SOW.

Какой официальный канал поддержки?
Официальный канал для учёта по SLA — тикет-система. Обращения из чатов следует фиксировать в тикетах.
В каком часовом поясе вы работаете?
Покрытие по умолчанию — CET/CEST. Расширенное покрытие для других часовых поясов доступно по плану.
Есть ли поддержка 24×7?
Круглосуточное дежурство (on-call) доступно для выбранных планов (обычно корпоративных).
Чем отличается первая реакция от восстановления?
Первая реакция подтверждает получение и начало работ. Восстановление направлено на быстрое возвращение минимально достаточной работоспособности до полного устранения причины.
Приостанавливаете ли вы SLA-время, если заказчик не предоставляет доступ?
Прогресс может быть заблокирован без доступа. Время ожидания включается, если не согласовано иное, поскольку устранение невозможно без предпосылок.
Как вы классифицируете критичность инцидентов?
Используются уровни критичности S1–S4 (Severity), сопоставимые с приоритетами P0–P4 (Priority), на основе влияния на бизнес и нарушения работы сервиса.
Предоставляете ли вы RCA / разбор инцидента?
Предварительное объяснение предоставляется в ходе обработки инцидента. Для крупных инцидентов после устранения может быть подготовлен структурированный RCA-разбор.
Как вы обрабатываете уязвимости безопасности?
Проблемы безопасности маркируются и приоритизируются как инциденты безопасности. Реакция фокусируется на сдерживании и быстром временном устранении риска с эскалацией при необходимости.
Есть ли у вас проактивный мониторинг?
Мониторинг доступен по плану. Базовые проверки включают доступность и контроль сроков. Расширенные проверки могут включать валидацию содержимого и метрики инфраструктуры/ресурсов.
Помогаете ли вы при сбоях внешних сервисов (оплаты, email-провайдеры)?
Мы не можем исправить внешние сервисы, но можем диагностировать, предоставить подтверждения, координировать с поставщиками и предложить меры снижения влияния в рамках оплачиваемого объёма поддержки.
Предусмотрены ли сервис-кредиты за нарушение SLA?
Для Enterprise-плана в SOW могут быть зафиксированы сервис-кредиты за нарушение целевого времени первой реакции по инцидентам S1. Сервис-кредиты применяются к времени начала работ, но не к срокам полного устранения.
Как работает эскалация при длительном инциденте?
Для Enterprise-плана в SOW фиксируется матрица эскалации с временными порогами: при отсутствии начала работ по S1 последовательно уведомляются Техлид, CTO, CEO.
Как часто предоставляются обновления статуса во время инцидента?
Частота обновлений зависит от плана: для Enterprise (S1) — каждые 30 минут, для остальных планов (S1) — каждые 4 часа. Подробности — в разделе «Enterprise-условия и договорные приложения».
Предоставляете ли вы RPO/RTO?
RPO/RTO фиксируются в SOW только если бэкапы и аварийное восстановление входят в согласованный объём услуг. Значения определяются после аудита архитектуры и данных.
Каков срок уведомления об инциденте безопасности?
Для Enterprise-плана срок уведомления — до 48 часов с момента подтверждения инцидента безопасности. Более строгие сроки могут быть согласованы отдельно.
Проводятся ли регулярные сервис-ревью?
Для Enterprise-плана доступны ежеквартальные сервис-ревью (QBR) с анализом инцидентов, трендов и рекомендациями. Ежемесячные ревью доступны как опция с отдельной оплатой.
Есть ли у вас гарантия доступности (uptime)?
Для систем, к которым у нас есть полный доступ на уровне приложения и инфраструктура стабильна, операционный целевой показатель доступности — 99,5% (ориентир 99,8%). Это применимо к системам, которые мы разработали или существенно сопровождаем. Показатели фиксируются в SOW; безусловных гарантий мы не публикуем, поскольку доступность зависит от инфраструктуры, сторонних сервисов и доступов — факторов, которые не всегда под нашим контролем.
Каков ориентир восстановления для критических инцидентов?
Типичный ориентир восстановления для S1 — до 4 часов, когда первопричина находится в нашей зоне ответственности. Финальные показатели фиксируются в SOW для каждого проекта и зависят от стека, уровня доступа и объёма инфраструктуры.
Как устроен процесс управления изменениями?
Изменения проходят через структурированный процесс согласования через тикеты. Для Enterprise возможна интеграция с процессом заказчика. План отката обязателен для критичных изменений. Экстренные изменения при полном отказе могут применяться без предварительного согласования; заказчик уведомляется немедленно после.
Как вы обеспечиваете безопасность данных и доступов?
Данные заказчика обрабатываются на инфраструктуре заказчика по умолчанию. При отсутствии доступа к продуктивным данным используются тестовые данные. Для систем с чувствительными данными контроль доступов ужесточается и фиксируется в SOW. При завершении договора все доступы отзываются.
Есть ли у вас сертификация (SOC 2, ISO 27001)?
Формальная сертификация на данный момент отсутствует. Практики безопасной разработки (ревью кода, управление зависимостями, контроль доступов, управление секретами) применяются ко всем проектам. Движение к сертификации запланировано в горизонте 12–15 месяцев. Опросник по безопасности доступен по запросу.
Используете ли вы ИИ в поддержке?
Анализ с помощью ИИ доступен как опция (код, логи, интеграции, история инцидентов) при участии специалиста. Внешние ИИ-сервисы используются только с согласия заказчика. Возможны локальные модели или полный запрет ИИ — детали фиксируются в SOW.
Какие языки вы поддерживаете?
Русский и английский — полная поддержка. Немецкий — доступен. Другие языки — по согласованию. Перевод с помощью ИИ доступен как опция с учётом политики заказчика.
Что происходит при завершении договора?
По соглашению: предоставляются проектная документация, регламенты, списки доступов, отчёт о рисках. Отключение доступов контролируется и подтверждается. Для базовых планов структурированное завершение может согласовываться отдельно.
Каковы ваши стандарты качества кода и тестового покрытия?
Наш ориентир — не менее 90% автоматизированного тестового покрытия, с покрытием 100% для критичных бизнес-путей (платежи, данные клиентов, ключевая бизнес-логика). Если заказчик решает сократить тестовое покрытие для оптимизации бюджета, это решение должно быть подтверждено письменно, и заказчик принимает связанные риски. Статический анализ и ревью кода — часть стандартного процесса.
Работаете ли вы с унаследованными (legacy) системами?
Да. Мы готовы принимать legacy-системы на поддержку и развитие. Однако для унаследованных систем мы не можем обеспечить тот же уровень гарантий, что и для систем собственной разработки. Онбординг для legacy-систем длиннее и включает обследование архитектуры и оценку рисков. Мы рекомендуем поэтапный подход: сначала стабилизация, затем плановый рефакторинг.
Сколько времени занимает онбординг нового члена команды?
Зависит от сложности проекта, качества документации, тестового покрытия, разрешения на ИИ-инструменты и объёма сервисов. Типичный диапазон: от 2 недель (хорошо задокументированный проект, ограниченный объём) до 3–4 недель (проекты средней сложности). Для сложных или legacy-систем может потребоваться больше времени. Новый специалист работает под руководством в период онбординга.
Как часто вы тестируете аварийное восстановление?
Мы рекомендуем тестирование восстановления не реже 1 раза в месяц для продуктивных систем, с охватом файловой системы и баз данных. Тестовые маркеры данных готовятся заранее для проверки восстановления как старых, так и недавних данных. Для критичных систем интервал может быть сокращён по согласованию.
Почему на этой странице нет цен?
Стоимость поддержки зависит от проектных факторов: стек, количество интеграций, грейд инженеров, требования к реакции и коммуникации, отчётности и инструментам, глубине процессов безопасности, ограничениям по данным. Все условия фиксируются в SOW.
cookies Мы используем Cookie

Мы используем файлы Cookie для улучшения работы сайта, персонализации контента и анализа трафика. Вы можете выбрать, какие категории Cookie разрешить. Подробнее читайте в нашей Политике Cookie. Вы можете изменить свой выбор в любое время.

Необходимые (обязательные)

Обеспечивают работу сайта (навигация, доступ к защищённым разделам). Всегда включены и могут быть изменены только в настройках браузера.

Аналитические

Помогают нам понять, как вы используете сайт, чтобы улучшать сервис. Не собирают личные данные. Для аналитики мы используем ряд инструментов.

Маркетинговые / Рекламные

Используются для показа персонализированной рекламы и измерения эффективности рекламных кампаний.