


Warum ein schneller Prototyp noch kein fertiges System ist
Seit 2006 entwickeln wir bei Webdelo komplexe B2B-Unternehmenssysteme, darunter FinTech-Lösungen, Handelsplattformen und ERP. Ich bin Andrey Popov, CTO von Webdelo. KI-Softwareentwicklung bedeutet für uns: Agenten schreiben den Code, Ingenieure steuern die Arbeit und nehmen das Ergebnis ab. Ein schneller Prototyp bedeutet noch nicht, dass man dem System Geld anvertrauen kann.
Auf unserer Plattform für algorithmischen Handel kann ein Fehler zum Verlust von Geld oder zu einer doppelten Order führen, also einem Kauf- oder Verkaufsauftrag. Deshalb sind unabhängige Code-Reviews und Tests Pflicht. Die Arbeitsprotokolle zeigten aber ein anderes Problem: 59 % der Eingabetoken verbrauchten die Agenten beim Warten.
Wenn ein Kunde mit uns über Web Entwicklung oder eine Webdesign Agentur für ein komplexes Produkt spricht, kläre ich zuerst, welche Vorgänge das System ausführen soll. In diesem Projekt lag das Hauptrisiko im Inneren: bei der Verbuchung von Geldern und der Verarbeitung von Handelsaufträgen.
Ein KI-Agent ist ein Programm, das ein Modell aufruft und Werkzeuge nutzt, um eine Aufgabe zu erledigen. Bei uns verteilte ein Koordinator-Agent die Arbeit auf drei bis vier Code-Autoren. Reviewer-Agenten prüften die Änderungen. Menschen trafen die Architekturentscheidungen und übernahmen die Abnahme.
Um die Zahlen zu verstehen, reichen drei Begriffe:
- Token - ein kleines Textstück, mit dem die Informationsmenge für das Modell gemessen wird.
- PR oder Pull Request - ein Paket von Änderungen, das zur Aufnahme in die Hauptversion des Codes vorgeschlagen wird. Ein zusammengeführter PR bedeutet, dass die Änderungen übernommen wurden.
- Review - die Prüfung von Änderungen durch einen anderen Beteiligten.
Wie viele Token AI Coding Agents verbrauchten und was sie lasen
Für den 5.-9. Oktober 2026 zählten wir 276 Codex-Sitzungen, 25.827 Modellanfragen und 3,25 Milliarden Eingabetoken. In dieser Zeit wurden 94 PRs in die Hauptversion des Codes übernommen. Dabei bestanden 97,4 % der Eingabe aus zwischengespeichertem Kontext: bereits übermittelten Informationen, die das Modell erneut verarbeitete.
Kontext ist der Arbeitsverlauf, der dem Modell zur Verfügung steht: Anweisungen, Nachrichten und Ergebnisse von Befehlen. In unserem Prozess enthielt eine Anfrage im Durchschnitt 126.000 Eingabetoken, eine Antwort etwa 600 Token. Der geschriebene Code und die Überlegungen des Modells machten zusammen weniger als ein Prozent des Eingabevolumens aus.
Wiederholter, zwischengespeicherter Kontext 97,4 %
Neue Informationen 2,6 %
Quelle: Webdelo-Protokolle. Das Diagramm zeigt nur die Eingabe des Modells, ohne seine Antworten.
Für mich ließ sich das auf eine einfache Formel reduzieren: Verbrauch an Eingabetoken = Anzahl der Anfragen × durchschnittliche Kontextgröße. Wer den Token-Verbrauch optimieren will, muss unnötige Aufrufe und den Umfang des mitgesendeten Verlaufs reduzieren.
Warum Agenten beim Agentic Coding warteten statt zu arbeiten
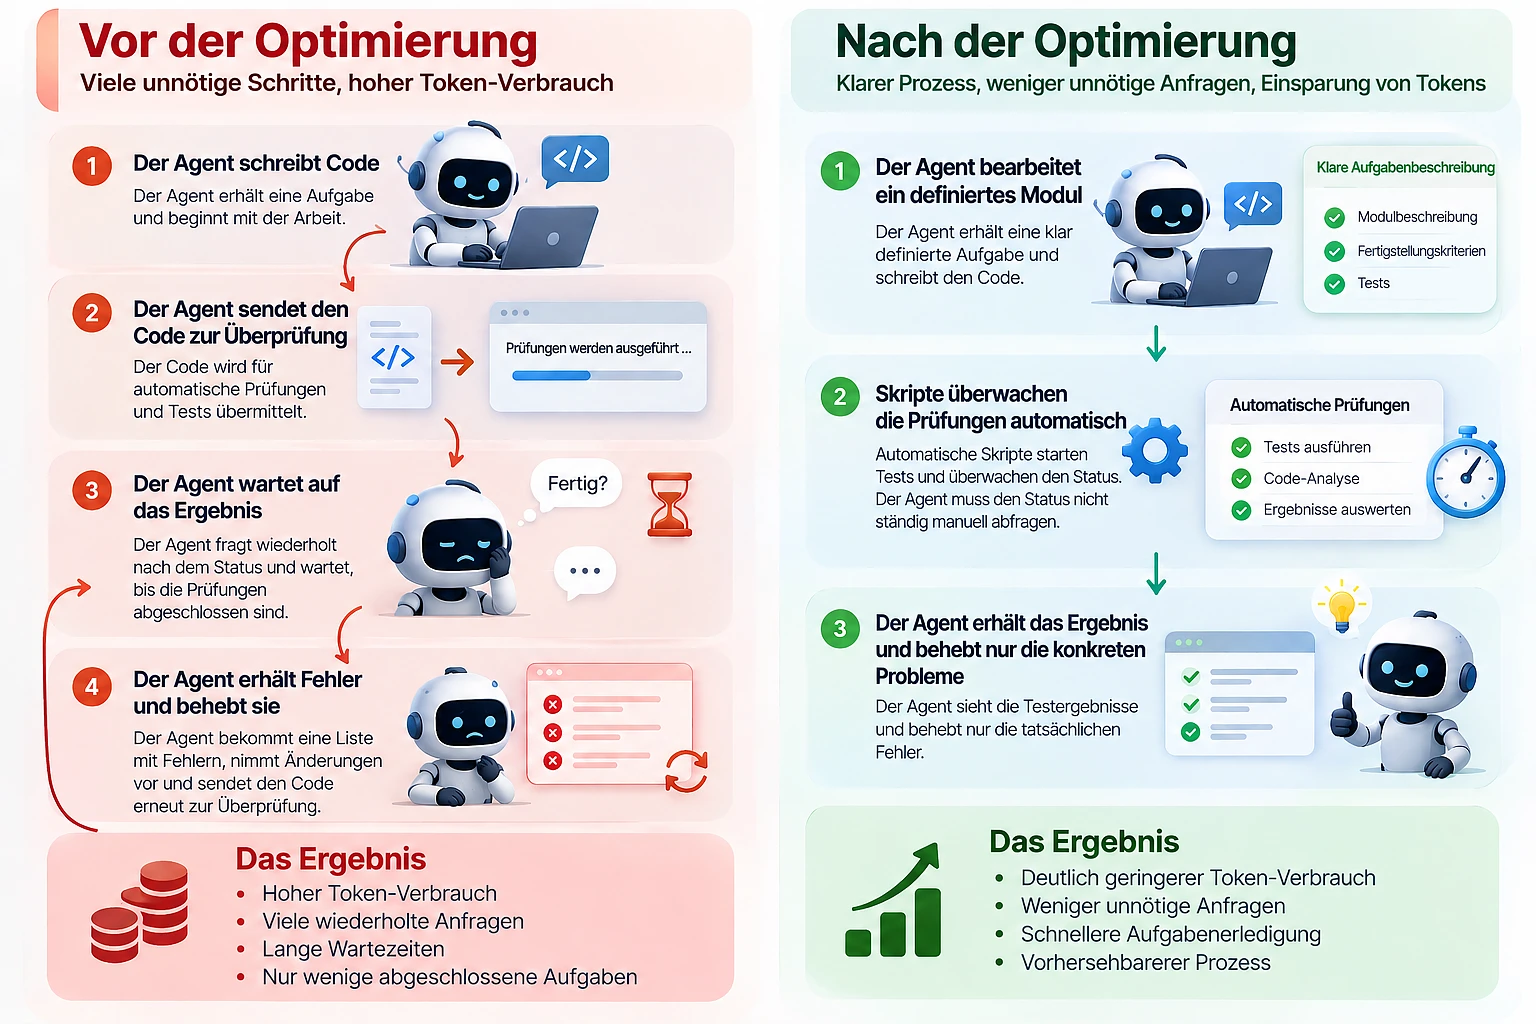
Etwa 1,9 Milliarden Eingabetoken, also 59 % der gesamten Eingabe, entfielen auf Warten und Statusabfragen. Der Agent fragte: "Sind die Tests schon durch?" oder "Hat der ausführende Agent geantwortet?" Jede solche Frage schickte den angesammelten Kontext erneut an das Modell.
In unserer Konfiguration gab das Werkzeug die Kontrolle spätestens nach 300 Sekunden an das Modell zurück. Eine vollständige Prüfung dauerte 15-23 Minuten. Während einer Prüfung wurde das Modell drei- bis fünfmal aktiv. Der Koordinator reagierte sogar auf die reine Statusmeldung "Ich bin noch aktiv" eines ausführenden Agenten.
Gleichzeitig entstanden lange Pausen zwischen sinnvollen Aktionen. Der Koordinator wartete mitunter eine halbe Stunde auf eine Erinnerung, obwohl der Reviewer nach 5-15 Minuten fertig war. Innerhalb eines Kontrollzeitraums von 24 Stunden zählten wir 11,6 Stunden solchen Leerlauf.
Koordinator Ausführende Agenten
5. Oktober 69 % / 57 %
6. Oktober 61 % / 59 %
7. Oktober 77 % / 60 %
8. Oktober 58 % / 45 %
9. Oktober 71 % / 51 %
Quelle: Webdelo-Protokolle. Hier werden Anfragen verglichen. Die oben genannten 59 % beziehen sich dagegen auf Eingabetoken.
Bei beiden Rollen entfiel ein erheblicher Teil der Aufrufe auf das Warten. Dazu gehörte auch das notwendige Warten auf eigene Tests. Problematisch waren die wiederholten Modellaufrufe, die nur den Status abfragten.
Weitere Verluste fanden wir in der Aufgabenorganisation. Der Plan war auf 550 kleine Punkte angewachsen, von denen innerhalb eines Tages drei abgeschlossen wurden. Es gab 43 Review-Sitzungen gegenüber 32 Entwicklungssitzungen. Für Korrekturen wurde häufig ein neuer Autor gestartet.
181 Millionen Token und keine abgeschlossene Aufgabe
Eine Sitzung lief acht Stunden, stellte 643 Anfragen und verbrauchte 98 Millionen Token. Eine parallel bearbeitete Aufgabe durchlief fünf Runden "Autor - Review - Korrektur" in zehn Sitzungen. Zusammen verbrauchten sie 181 Millionen Token, ohne eine einzige Aufgabe abzuschließen.
Ein Ingenieur stoppte diese Schleife. Wir sicherten die Branches mit den Änderungen und verschoben die Arbeit, bis der Hauptablauf fertig war. Der Agent traf diese Entscheidung nicht selbst.
Was wir an der AI Agent Orchestration geändert haben
Wir übergaben wiederkehrende Aktionen an Skripte und fassten Aufgaben zu prüfbaren Modulen zusammen. Ein Autor betreute nun ein Modul bis zur Zusammenführung. Ein Reviewer prüfte das Modul und die anschließenden Korrekturen. Die Modellstufe legten wir bei der Aufgabenvergabe ausdrücklich fest.
Die Aufteilung folgt einer einfachen Regel: Läuft eine Aktion nach festen Regeln ab und passt ihr Ergebnis in eine Zeile, übernimmt sie ein Skript. Dem Modell bleiben die Analyse der Aufgabe, das Schreiben von Code und die Suche nach Fehlerursachen. Den Speicher des Koordinators verlagerten wir aus einem langen Dialog in eine kompakte Tabelle in einer Datei.
Für das Warten genügte nun ein einzelner Skriptaufruf, der reine Statussignale herausfiltert. Bei Zwischenschritten prüfen wir die geänderten Dateien. Die vollständige Prüfung starten wir am fertigen Modul parallel zum Review. Dadurch entfallen 15-23 Minuten aufeinanderfolgender Wartezeit.
Vorher und nachher
| Arbeitsbereich | Vorher | Nachher |
|---|---|---|
| Koordination | Das Modell fragt ausführende Agenten ab und speichert den Stand im Dialog | Ein Skript wartet auf eine inhaltliche Nachricht, der Stand wird in einer Datei gespeichert |
| Aufgaben | Kleine Einzelpunkte, ein neuer Autor für die nächste Korrektur | Ein prüfbares Modul, ein Autor bis zur Zusammenführung |
| Skripte | Vergabe, Abgabe, Abnahme und Start der Prüfungen erfordern mehrere Modellaufrufe hintereinander | Jeder Vorgang startet mit einem einzigen Aufruf |
| Tests | Vollständige Codestilprüfung bei jedem Schritt, gemeinsame Warteschlange für Prüfungen | Zwischenprüfungen der Änderungen, vollständige Prüfung vor der Abgabe, Abbruch beim ersten Fehler |
| Review | Wiederholte Prüfungen des gesamten Moduls | Eine vollständige Prüfung, danach prüft derselbe Reviewer nur die Korrekturen |
| Modellmodus | Hohe Stufe für alle Autoren | Ausdrückliche Wahl der Stufe nach dem Risiko der Aufgabe, ohne maximalen Modus |
Statt 550 kleiner Aufgaben legten wir 20 Module fest, die sich jeweils starten und prüfen lassen. Bei einem Projekt mit CRM-Systemen könnte eine solche Aufgabe zum Beispiel den vollständigen Freigabeprozess eines Antrags umfassen. Bei der Entwicklung eines Online-Shops wäre es der Bestellabschluss mit Zahlungsprüfung.
Bei einer konkreten Änderung erledigte das Prüfskript des Autors die Arbeit in 49 Sekunden mit einem einzigen Aufruf. Zuvor hatten Start und Begleitung solcher Prüfungen 10-30 Modellaufrufe beansprucht. Das ist das Ergebnis eines bestimmten Durchlaufs, kein Zeitversprechen für jede Aufgabe.
Automatisierung hat ihren eigenen Aufwand. Die Skripte erforderten einen eigenen PR und 45 Tests. Sie müssen gepflegt werden. Beim Warten auf Nachrichten darf kein Fehler passieren: Das Skript könnte eine wichtige Antwort eines ausführenden Agenten verlieren.
Wie wir die Modellstufe festlegen
Medium und High bezeichnen die Tiefe der Überlegungen des Modells. Für Builds und die Einrichtung der Umgebung wählen wir Medium. Für Logik rund um Geld und die Wiederherstellung nach Ausfällen nutzen wir High beim Autor und beim vollständigen Review.
In unseren Protokollen lagen einzelne Verbrauchswerte und die Dauer einzelner Schritte auf High etwa 30-60 % höher. Das ist kein Anstieg um Größenordnungen. Weit mehr Token verbrauchten unnötige Aufrufe und wiederholte Prüfrunden.
Vollständiges Review auf High 4,1 Mio.
Vollständiges Review auf Medium 1,4 Mio.
Prüfung nur der Korrekturen 0,5 Mio.
Quelle: Webdelo-Protokolle. Gezeigt wird der Token-Verbrauch, nicht der Geldbetrag. Die Aufgaben auf High und Medium unterschieden sich.
Vollständiges Review auf High 29 Min.
Vollständiges Review auf Medium 3 Min.
Prüfung nur der Korrekturen 2 Min.
Quelle: Webdelo-Protokolle. Der Median liegt in der Mitte der Beobachtungen: Die Hälfte der Sitzungen war kürzer, die andere Hälfte länger.
Die Diagramme zeigen den Aufwand verschiedener Prüfarten in unserem Prozess. Sie belegen nicht, dass Medium dieselbe Arbeit schneller erledigt. Nur die Korrekturen erneut zu prüfen, dauert naturgemäß weniger lang als die vollständige Analyse eines Moduls.
Bei der Finanzlogik erwies sich High als nützlich: Innerhalb von zwei Tagen fanden die Reviews drei schwerwiegende Fehler. Einer davon hätte im Betrieb zu einer doppelten Order geführt. Diese Prüfungen behielten wir bei.
Eine Anweisung zur Wahl des Modus allein reichte nicht. Die Regel "normaler Code auf Medium" bestand bereits. Trotzdem startete der Koordinator alle zwölf Autoren auf High. Ein Ingenieur bemerkte das in den Protokollen: Der Agent erfasste seinen Verbrauch nicht selbst.
Was die Optimierung beim Programmieren mit KI gezeigt hat
Innerhalb von fünf Tagen sank der Verbrauch pro zusammengeführtem PR von 50,3 auf 22,6 Millionen Eingabetoken. In den Kontrollzeiträumen stieg die Rate der Zusammenführungen von 0,75 auf 1,6 PRs pro Stunde. Das sind Prozesskennzahlen, keine Kosten für den gleichen Arbeitsumfang: Nach den Änderungen waren die PRs größer.
5. Oktober 50,3
6. Oktober 37,6
7. Oktober 37,4
8. Oktober 35,1
9. Oktober 22,6
Quelle: Webdelo-Protokolle und PR-Verlauf. Für den 9. Oktober wurden Daten bis 11:40 Uhr UTC berücksichtigt. Die Größe der PRs änderte sich.
Das Diagramm zeigt einen stetigen Rückgang des Verbrauchs pro PR. Bei einem gesonderten Vergleich der Kontrollzeiträume vor und nach den Änderungen sank der Wert von 44 auf 25 Millionen Token, also um 43 %. Diese Prozentangabe bezieht sich auf die Kontrollzeiträume, nicht auf den ersten und letzten Punkt des Diagramms.
Nach dem Wechsel des Koordinators wurden in den ersten acht Stunden 45 Aufgaben aus der ursprünglichen Aufteilung abgeschlossen. In den vorherigen 24 Stunden waren es drei gewesen. Der gemessene Leerlauf des Koordinators sank von 11,6 Stunden auf null. In den neuen Zeiträumen gab es keine Pausen von mehr als zehn Minuten, die wir als Leerlauf erfassten.
Auch die Zusammensetzung der neuen Codezeilen änderte sich. Der Anteil der Platzhalter, also automatisch erzeugter Codegerüste, sank stark. Tests und Produktcode, der die Vorgänge des Systems ausführt, nahmen mehr Raum ein.
Platzhalter 39 %
Tests 34 %
Produktcode 19,5 %
Sonstiges 7,5 %
Quelle: Änderungen im Webdelo-Repository. Die Anteile beziehen sich auf 176.000 hinzugefügte Zeilen.
Platzhalter 3 %
Tests 47 %
Produktcode 42 %
Dokumentation und Sonstiges 8 %
Quelle: Änderungen im Webdelo-Repository. Die Anteile beziehen sich auf 28.700 hinzugefügte Zeilen.
Die Diagramme zeigen, dass sich die Arbeit von Codegerüsten hin zum Verhalten des Systems und dessen Prüfung verlagerte. Die Zahl der Zeilen allein misst keine Codequalität.
Das Warteproblem haben wir nicht vollständig gelöst. Am 9. Oktober entfielen wegen der Werkzeuggrenze von 300 Sekunden immer noch 71 % der Anfragen des Koordinators auf das Warten. Sein Anteil am Gesamtverbrauch blieb bei etwa 30 %: Der Prozess lieferte mehr Ergebnisse, aber die Verbrauchsstruktur änderte sich kaum.
Grenzen unserer Messungen
- Unterschiedlich große PRs. Vor den Änderungen schloss ein PR meist eine kleine Aufgabe ab, danach ein Modul mit 1.500-3.000 Zeilen.
- Medium und High erhielten unterschiedliche Aufgaben. Wir haben nicht dieselbe Arbeit auf beiden Stufen verglichen.
- Die Qualität nach der Zusammenführung wurde nicht gemessen. Wir haben spätere Fehler nicht gezählt und keine gleichwertige Qualität der verschiedenen Modi nachgewiesen.
- Die finanziellen Kosten wurden nicht berechnet. Wir arbeiteten innerhalb der Nutzungslimits eines Abonnements.
- Das Projekt ist nicht abgeschlossen. Am Ende der Beobachtung waren etwa 65 % der Sprintkriterien erfüllt. Der Abgleich der Geldbestände und Szenarien zur Wiederherstellung nach Ausfällen stehen noch aus.
Wie Token-Kosten die Entwicklung mit KI beeinflussen
Token hängen über das Abonnement und seine Nutzungslimits oder über die nutzungsabhängige Modellabrechnung mit realen Ausgaben zusammen. Wir arbeiteten innerhalb der Nutzungslimits eines Abonnements und haben deshalb keine Einsparung in Geld gemessen. Unnötige Anfragen führen dazu, dass das Kontingent früher erschöpft ist. Dann muss die Arbeit bis zur Erneuerung der Quote warten oder verursacht zusätzliche Kosten.
Je nach Dienst erfolgt die Abrechnung über:
- ein kostenpflichtiges Abonnement mit Nutzungslimits
- den Kauf zusätzlicher Pakete oder Kontingente
- eine API - einen programmatischen Zugang mit verbrauchsabhängiger Bezahlung
Zwischengespeicherte Eingaben können bei tokenbasierter Abrechnung günstiger sein als neue, sind aber nicht kostenlos. In unserer Erfassung belasteten sie ebenfalls die Nutzungslimits. Die Nutzungsbedingungen für Claude Code beschreibt die offizielle Anthropic-Hilfe zu Modellen und Nutzungslimits.
In unserem Prozess war es wichtiger, unnötige Aufrufe zu reduzieren, als die Modellstufe zu senken. Ich orientiere mich am Aufwand bis zum abgenommenen Ergebnis, einschließlich Wiederholungen und fehlgeschlagener Prüfungen. Diesen Ansatz zur Bewertung einer abgeschlossenen Aufgabe beschreibt auch ein Tutorial auf Habr zum Einsparen von Token.
Für das Produktbudget ist es sinnvoll, Entwicklung und Kundengewinnung zu trennen. Ist eine Unternehmenswebsite mit der Plattform verbunden, sollten ihre Anpassungen getrennt von den Ausgaben für Online Marketing erfasst werden.
Bei Google SEO und GEO SEO gelten eigene Ergebnisse und Messzeiträume. Weniger Token beim Schreiben von Code bedeuten nicht automatisch ein kleineres Gesamtbudget für das digitale Produkt.
Die Optimierung erforderte bei uns drei Protokollanalysen innerhalb von drei Tagen und drei Anweisungsdokumente mit jeweils 30-40 Zeilen. Ein Agent führte die Analysen im Auftrag eines Ingenieurs durch. Zusätzlich schrieb und prüfte das Team die Skripte. Die Dokumente bilden daher nicht den gesamten Arbeitsaufwand für die Änderungen ab.
Was nicht auf Kosten der Qualität optimiert werden darf
Die Entwicklung von Plattformen für algorithmischen Handel erfordert Prüfungen der Finanzlogik und der Wiederherstellung nach Ausfällen. Wir reduzierten wiederkehrende Arbeit rund um diese Prüfungen. Die Szenarien selbst, die einen möglichen Geldverlust aufdecken können, blieben Pflicht.
Drei Grenzen schlug der Koordinator als Antwort auf unsere Anweisungen selbst vor. Wir stimmten ihnen zu:
- Ein bestätigter Fehler darf nicht verborgen werden, nur um die Zahl der Korrekturrunden zu begrenzen.
- Prüfungen mit einer echten Datenbank, einem Notstopp und einem Abgleich der Finanzdaten sind verpflichtend.
- Das erste fehlgeschlagene Prüfergebnis wird archiviert. Es darf nicht durch einen erfolgreichen Wiederholungsdurchlauf ersetzt werden.
Welche Entscheidungen beim Ingenieur blieben
Für mich ist eine Aufgabe ein Modul, das sich starten und prüfen lässt. Beim bisherigen Tempo hätten die verbleibenden 343 kleinen Aufgaben etwa 114 Arbeitstage bedeutet. Das war eine lineare Hochrechnung des alten Prozesses. Sie zeigte das Problem in der Aufgabenaufteilung selbst.
Wir lehnten den Vorschlag ab, vorübergehend nur eine Börse an das neue Gateway anzubinden. Stattdessen entschieden wir uns für den vollständigen Ablauf für drei Börsen: Ein Übergangsbetrieb wird in einem Finanzsystem leicht zur Dauerlösung. Diese Entscheidung vergrößerte den aktuellen Arbeitsumfang.
Wir übertrugen die Strategie mit minimalen Änderungen und einem Vergleichslauf. Eine "sauberere" Neufassung hätte das Risiko erhöht, ihr Verhalten zu verändern. Hier war es wichtiger, bewährte Logik zu erhalten, als den neuen Code äußerlich aufzuräumen.
Ein Ingenieur muss regelmäßig die Protokolle lesen und die Regeln anpassen. In unserem Fall half die tägliche Kontrolle dabei, die Rückkehr unnötiger Aktionen zu erkennen. Eine Anweisung an den Agenten allein stellte nicht sicher, dass er den Prozess einhielt.
Wenn ich eine bestehende KI-Entwicklung optimiere, eine Unternehmensplattform entwickle oder die Betreuung komplexer Software organisiere, beginne ich bei Webdelo mit dem aktuellen Prozess und den Abnahmekriterien.
Was ich aus diesem Sprint mitnehme
Die größten Verluste entstanden in unserer Fallstudie durch die Organisation der Agentenarbeit. Die Protokolle halfen, unnötige Wartezeiten zu finden. Skripte und größere Aufgaben reduzierten wiederholte Modellaufrufe. Die Prüfungen finanzieller Risiken behielten wir bei.
Dasselbe Prinzip gilt für B2B-Plattformen, FinTech und ERP: zuerst den Prozess messen, dann Routinearbeit automatisieren und die Verantwortung für das Ergebnis klar zuordnen. Die Entwicklung von Unternehmenssoftware mit Agenten erfordert bei jedem dieser Schritte technische Entscheidungen durch Ingenieure.
Häufig gestellte Fragen
Was bedeutet KI-Softwareentwicklung nach dem AI-first-Prinzip in einfachen Worten?
Es ist ein Ansatz, bei dem KI-Agenten den Code schreiben, während Ingenieure die Arbeit steuern und das Ergebnis abnehmen. Bei Webdelo verteilte ein Koordinator-Agent die Aufgaben an drei bis vier Code-Autoren, Review-Agenten prüften die Änderungen, und Menschen trafen die Architekturentscheidungen. Ein schneller Prototyp ist noch kein zuverlässiges System: Wo Software mit Geld arbeitet, bleiben unabhängige Code-Prüfung und Tests Pflicht.
Warum verbrauchen AI Coding Agents so viele Token?
Der größte Verbrauch entsteht nicht beim Schreiben von Code, sondern beim erneuten Senden des angesammelten Arbeitsverlaufs. Im Fall von Webdelo fielen in fünf Tagen 3,25 Mrd. Eingabe-Token an, davon waren 97,4 % zwischengespeicherter Kontext, also bereits übermittelte Informationen. Rund 59 % der Eingabe-Token gingen für Warten drauf: Ein Agent fragte, ob die Tests fertig sind, und jede solche Frage schickte den gesamten Kontext erneut an das Modell. Die Formel ist einfach: Anzahl der Anfragen mal durchschnittliche Kontextgröße.
Wie lässt sich der Token-Verbrauch bei der Entwicklung mit KI-Agenten senken?
Webdelo hat wiederholbare Schritte an Skripte übergeben: das Warten, die Vergabe und Abgabe von Aufgaben sowie den Start der Prüfungen. Statt 550 kleiner Aufgaben gibt es nun 20 Module, die sich starten und prüfen lassen, jeweils mit einem Autor und einem Reviewer. Die Modellstufe wird nach dem Risiko der Aufgabe festgelegt. In fünf Tagen sank der Verbrauch pro gemergtem PR von 50,3 auf 22,6 Mio. Eingabe-Token, das Tempo stieg von 0,75 auf 1,6 PRs pro Stunde - die PRs wurden dabei aber größer, es sind also Prozesskennzahlen und kein Preis für gleiche Arbeit.
Wie beeinflussen Token-Kosten die Entwicklung mit KI?
Token werden über ein kostenpflichtiges Abonnement mit Nutzungsgrenzen, den Kauf zusätzlicher Pakete oder Kontingente oder eine verbrauchsabhängige API-Abrechnung zu echten Ausgaben. Überflüssige Anfragen bringen den Moment näher, in dem die Arbeit bis zur Erneuerung des Kontingents stoppt oder Zusatzkosten entstehen. Zwischengespeicherte Eingaben können günstiger sein als neue, kostenlos sind sie aber nicht. Webdelo arbeitete innerhalb der Abo-Grenzen und hat die Ersparnis in Dollar deshalb nicht gemessen.
Was darf bei der Optimierung der KI-Softwareentwicklung nicht gestrichen werden?
Prüfungen der Finanzlogik und der Wiederherstellung nach Ausfällen müssen bleiben. Webdelo hat die wiederholbare Arbeit rund um diese Prüfungen reduziert, doch die Prüfungen mit echter Datenbank, Notstopp und Finanzabgleich blieben Pflicht. Ein bestätigter Fehler darf nicht verschwiegen werden, um Korrekturrunden zu sparen, und das erste fehlgeschlagene Prüfergebnis bleibt im Archiv. In zwei Tagen fand ein solches Review drei schwere Fehler, einer davon hätte zu einer doppelten Order geführt.
Warum braucht man bei der Arbeit mit KI-Agenten weiterhin einen Ingenieur?
Ein Agent führt keine eigene Verbrauchsübersicht und hält sich nicht immer an Anweisungen. Im Fall von Webdelo verbrauchten zwei Aufgaben 181 Mio. Token, ohne abgeschlossen zu werden, und diese Schleife stoppte ein Ingenieur, nicht der Agent. Der Koordinator startete alle 12 Autoren auf der hohen Modellstufe, obwohl die Regel etwas anderes vorsah - auch das bemerkte ein Mensch in den Protokollen. Deshalb muss ein Ingenieur die Protokolle regelmäßig lesen, die Regeln anpassen und über Aufgabenzuschnitt und Architektur entscheiden.
Wie belastbar sind diese Zahlen und wo liegen ihre Grenzen?
Die Zahlen stammen aus den Agenten-Protokollen und der PR-Historie von fünf Tagen, die Messungen haben aber Grenzen. Die PRs waren unterschiedlich groß: Vor den Änderungen schloss ein PR eine kleine Aufgabe ab, danach ein Modul mit 1.500-3.000 Zeilen. Die Stufen Medium und High wurden nicht an derselben Aufgabe verglichen, Fehler nach dem Merge und Geldkosten wurden nicht erfasst. Das Projekt ist nicht abgeschlossen: Am Ende der Beobachtung waren rund 65 % der Sprint-Kriterien erfüllt.
