


Kurze Antwort: Im Jahr 2026 ist das Schwierige an Unternehmenssoftware nicht mehr das Programmieren. Schwierig ist die Koordination mehrerer KI-Agenten. Ihre Arbeit muss prüfbar, sicher und wartbar sein. Bei Webdelo laufen ein führender Agent und mehrere Arbeitsagenten in getrennten Umgebungen. Wir prüfen jedes Ergebnis im echten Browser. Für jede Übernahme in den Hauptzweig bleibt ein Mensch verantwortlich. Genau das verkauft ein Anbieter für KI-Softwareentwicklung heute: einen Prozess, keinen Modellnamen.
Einführung
Vor zwei Jahren hatte ein Entwickler bei uns ein Fenster offen. Eine Entwicklungsumgebung. Heute hat derselbe Entwickler ein Dutzend Agenten-Sitzungen laufen. Jede arbeitet an einem anderen Teil derselben Funktion. Niemand hat das geplant. Es kam Monat für Monat, und jetzt sieht Arbeit so aus.
Das ist die Leiter, die wir hochgestiegen sind. Stufe 1: Entwickler, Editor, Code. Die Arbeitseinheit ist eine Datei. Stufe 2: dasselbe, dazu ein KI-Assistent mit Autovervollständigung. Stufe 3: Der Entwickler jongliert Agent 1, Agent 2 und Agent 3 von Hand und kopiert den Kontext hin und her. Stufe 4, dorthin gehen die guten Werkzeuge: Ein Mensch nennt ein Ziel. Ein führender Agent zerlegt es. Spezialisierte Agenten setzen um. Etwas prüft das Ergebnis. Am Ende steht ein Pull Request. Die Arbeitseinheit ist jetzt eine Funktion.
Für einen Einkäufer im Unternehmen zählt das alles noch nichts. Erzeugte Codezeilen sind kein Ergebnis. Planbare Termine sind eines. Dazu prüfbare Ergebnisse, Sicherheit, Anbindung an Ihre vorhandenen Systeme und Wartbarkeit über fünf Jahre.
Sie erfahren hier: wie wir Werkzeuge auswählen, wie wir Agenten-Teams bei CRM- und ERP-Projekten einsetzen, was unabhängige Daten sagen, wo Agenten ein Team ausbremsen und welche Steuerung ein Unternehmen braucht. Wir nennen Grenzen, Alpha-Status und Lücken in den Produktplänen offen. Ein Anbieter, der nur die gute Hälfte zeigt, verkauft. Er baut nicht.
Hinweis zu Daten, Namen und Zahlen
Alle Angaben zu Preisen und Tarifen gelten zum 11. September 2026. Tarife ändern sich schnell. Am 10. September 2026 hat OpenAI neue Pro-Abos für 200 US-Dollar und Wechsel vorübergehend gestoppt. Das zeigt: Schon der Zugang ist ein bewegliches Ziel.
Zwei Dinge halten wir sauber getrennt, weil sie ständig vermischt werden. Modelle sind das eine: Astra und Fable 5.1 sind Modelle. Agenten-Umgebungen sind etwas anderes: Codex und Claude Code sind Umgebungen. Work und Cowork sind wieder eigene Produkte. Wenn ein Anbieter "20x" sagt, gehört diese Zahl zu seinem eigenen Tarif. OpenAI 20x und Anthropic 20x bedeuten nicht dieselbe Menge an Token.
Jeden Messwert, den ein Anbieter über sein eigenes Produkt veröffentlicht, kennzeichnen wir hier als Herstellerangabe. Werte aus verschiedenen Testverfahren sind nicht vergleichbar. Wir veröffentlichen keine internen Webdelo-Prozentwerte, denn wir haben keine kontrollierte interne Messung durchgeführt. Wo wir eine Zahl nennen, hat sie eine benannte externe Quelle.
Warum der Engpass vom Programmieren zur Koordination gewandert ist
Code zu erzeugen war irgendwann 2025 nicht mehr knapp. Knapp wurde die Koordination. Wenn drei Agenten an derselben Funktion arbeiten, ist das Teure eine andere Frage: Wer besitzt was? Wie bleibt der Kontext synchron? Wie löst man Änderungen auf, die sich widersprechen? Und wie beweist man, dass das Ergebnis läuft? Das ist ein Führungsproblem im Ingenieurskostüm.
Auf unseren eigenen Bildschirmen kam die Verschiebung langsam. 2024 war der KI-Anteil des Tages Autovervollständigung. Mitte 2026 hat ein Entwickler vielleicht einen Planungsagenten, zwei Umsetzungsagenten und einen Prüfagenten gleichzeitig laufen. Das Tippen wurde schneller. Das Entscheiden wurde schwerer. Erst war die Prüfkapazität die Wand. Dahinter stand die nächste Wand: die Koordination.
Mehr Agenten heißt nicht mehr Durchsatz. Jeder weitere Agent kostet Abstimmung. Er bringt mehr Konflikte beim Zusammenführen. Er bringt Doppelarbeit, wenn zwei Agenten dieselbe Sache verschieden lösen. Er kostet echtes Geld für Token und Rechenzeit. Und er erhöht die Prüflast für die Menschen am Ende.
Den nützlichsten unabhängigen Rahmen liefert der DORA-Bericht 2025 zur KI-gestützten Softwareentwicklung. Seine Hauptaussage: KI verstärkt das Entwicklungssystem, das Sie bereits haben. Architektur, kurze Rückmeldeschleifen und die Qualität der internen Plattform entscheiden, ob lokale Zeitgewinne im ganzen Unternehmen ankommen. Ist der Prozess schwach, kommt die Schwäche mit Agenten nur schneller an. Kleiner wird sie nicht.
Was wirklich schneller wurde und was nicht
Schneller: klar begrenzte Aufgaben mit einem klaren Abnahmetest. Einen Endpunkt ergänzen, eine Datenbankmigration schreiben, ein Modul mit Tests abdecken. Der Agent merkt selbst, wann er fertig ist, weil etwas von außen es ihm sagen kann.
Nicht schneller: Änderungen in großen, gewachsenen Systemen, die das Team sehr gut kennt. Der Entwickler trägt Jahre an Wissen im Kopf, das nie aufgeschrieben wurde. Es zu erklären kostet mehr als die Arbeit selbst. Diese Trennung entscheidet, ob wir für eine Aufgabe überhaupt Agenten einsetzen. Und sie führt zur nächsten Frage: Welche Umgebung führt mehrere Agenten ohne Chaos?
Was eine agentische Entwicklungsumgebung ist und wie sie sich von einer KI-gestützten IDE unterscheidet
Eine KI-gestützte IDE hilft einem Menschen beim Bearbeiten einer Datei. Eine agentische Entwicklungsumgebung führt und koordiniert die Arbeit mehrerer eigenständiger Agenten: getrennte Git-Arbeitskopien, parallele Sitzungen, gemeinsamer Kontext, Prüfung, Tests, Kontrolle im Browser, Pull Requests und Nachvollziehbarkeit. Der Unterschied liegt in der Arbeitseinheit. In der IDE ist es ein Editor-Reiter. In einer agentischen Entwicklungsumgebung ist es eine Funktion, ein Ticket oder eine Geschäftsaufgabe.
Den Begriff haben wir nicht erfunden. Er entstand, weil die alten Wörter die Sache nicht mehr beschrieben. Ein System, das acht Agenten über sechs Arbeitskopien führt, eine "IDE" zu nennen, ist wie ein Lager ein Regal zu nennen. Für eine Führungskraft ohne Entwicklerhintergrund: Eine IDE ist ein Texteditor mit gutem Werkzeug, gebaut für einen Menschen. Eine agentische Entwicklungsumgebung ist ein Arbeitsplatz für ein kleines Team von Software-Arbeitern, die zufällig Programme sind. Sie beantwortet die Fragen jeder Werkstatt. Wer hat welche Kopie der Arbeit? Wie bleiben alle synchron? Wer prüft das Ergebnis? Wer gibt es frei?
Eine echte agentische Entwicklungsumgebung liefert den größten Teil dieser Liste, in einer laufenden Fassung und nicht nur in der Werbung:
- getrennte Git-Arbeitskopien, meist Worktrees, damit zwei Agenten nie gleichzeitig dieselben Dateien ändern
- mehrere Agenten, die parallel laufen
- dauerhafte Sitzungen, die einen Neustart oder einen Verbindungsabbruch überleben
- Verwaltung von Aufgaben und Zuständen
- gemeinsamer Kontext, damit der zweite Agent weiß, was der erste entschieden hat
- eine Änderungsansicht, die ein Mensch schnell lesen kann
- Tests und CI, fest im Ablauf verankert
- Prüfung der laufenden Anwendung im Browser
- Pull Requests als Ausgabeformat
- Ausführung auf entfernten Servern
- Automatisierungen für die wiederkehrenden Teile
- API, Kommandozeile und MCP, damit andere Software die Umgebung steuern kann
- Rollenverteilung zwischen den Agenten
- Zugriffsrechte, Beobachtbarkeit und Protokolle
Eine KI-gestützte IDE ist ein besserer Stift. Eine agentische Entwicklungsumgebung ist eine kleine Werkshalle mit einem Meister. Beides ist nützlich. Beides konkurriert nicht um dieselbe Aufgabe.
Drei Ansätze nebeneinander
Der Assistent mit Autovervollständigung spart Tastenanschläge. Die agentische IDE optimiert eine Aufgabe in einer Sitzung: Repository lesen, Änderung planen, mehrere Dateien bearbeiten, einen Befehl ausführen. Die agentische Entwicklungsumgebung optimiert viele Aufgaben gleichzeitig, mit eingebauter Trennung und Prüfung.
Eine einfache agentische IDE ist öfter die richtige Antwort, als der Wirbel vermuten lässt. Kleines Team, ein Repository, eine Änderung nach der anderen, starke menschliche Prüfung. Orchestrierung bringt dort nur Zusatzaufwand und sonst nichts.
Wie wir agentische Umgebungen bei Webdelo bewerten: Isolation, Kontext, Orchestrierung, Verifikation, entfernte Laufzeit und Freigabe
Wir bewerten jede Umgebung auf sechs Achsen: Isolation, Kontext, Orchestrierung, Verifikation, entfernte Laufzeit und Freigabe. Diese Achsen stammen aus unserem eigenen Projektschmerz, nicht aus einer Vergleichstabelle eines Anbieters. Jede steht für einen Punkt, an dem bei uns mindestens einmal ein Projekt gekippt ist. Ein Werkzeug kann auf einer Achse glänzen und auf einer anderen unbrauchbar sein. Eine einzige Gesamtnote sagt deshalb nichts.
Isolation. Können Agenten arbeiten, ohne sich gegenseitig zu stören? Getrennte Arbeitskopien, getrennte Ports, getrennte Umgebungsvariablen. Die Testfrage: Was passiert, wenn zwei Agenten dasselbe Anmeldemodul anfassen? Lautet die Antwort "vermutlich Konflikte", dann ist es ein Werkzeug für einen Agenten mit ein paar Extraknöpfen.
Kontext. Versteht das Werkzeug das ganze Repository und die ganze Funktion? Das Kontextfenster sagt, wie viel Text ein Modell gleichzeitig im Blick hat. Ein Zwischenspeicher für Prompts sorgt dafür, dass die Umgebung nicht in jedem Zug den vollen Preis für denselben Hintergrund zahlt. Beides ist genauso eine Kostenfrage wie eine Qualitätsfrage.
Orchestrierung. Kann ein Agent andere führen? Ein führender Agent, spezialisierte Arbeiter, Nachrichten zwischen ihnen, Haltepunkte für Freigaben und ein fester Weg zur Eskalation an einen Menschen. Ohne das haben Sie Parallelität, aber keine Teamarbeit.
Verifikation. Lässt sich das Ergebnis beweisen und nicht nur übersetzen? Tests, CI, Prüfung im Browser und über die Bedienung des Betriebssystems, dazu Nachweise, die an der Änderung hängen. Hier sind die meisten Werkzeuge am schwächsten. Und genau hier ist der Unterschied für den Kunden am größten.
Entfernte Laufzeit. Können Repositories, Terminals und Agenten auf einem Server leben, während Laptop oder Telefon nur die Steuerung sind? Bei langlaufender Arbeit ist das keine Bequemlichkeit mehr, sondern Architektur.
Freigabe. Wie genehmigt ein Mensch eine Änderung? Qualität der Änderungsansicht, anbieterübergreifende Quellcode-Prüfung, Freigabepunkte, Protokoll. Wenn ein Prüfer die Änderung nicht in wenigen Minuten lesen kann, wird sie ungelesen freigegeben.
Eine Übersicht mit allen unten genannten Werkzeugen und diesen sechs Achsen folgt nach den Werkzeug-Abschnitten. Wir suchen nicht das beste Werkzeug. Wir suchen das Werkzeug, das auf der für das Projekt wichtigen Achse am wenigsten schlecht ist. Bei einem CRM-Portal gewinnt die Verifikation. Bei einer ERP-Änderung über mehrere Repositories gewinnen Isolation und Kontext.
Orca als unsere ausgewogene Basis im Tagesbetrieb
Orca setzen wir täglich ein. Nicht weil es eine einzelne Achse gewinnt, sondern weil es über alle sechs am ausgewogensten ist. Es bietet parallele Agenten in getrennten Arbeitskopien, mehrere Kommandozeilen-Agenten, Änderungsprüfung, einen eingebauten Chromium-Browser, den Design Mode, Automatisierungen, entfernte Server, eine mobile App und ein eigenes Modul für Orchestrierung. Diese Angaben stammen vom Hersteller. Von uns kommt nur der Zusatz: Die Teile, die wir täglich nutzen, halten echter Kundenarbeit stand.
Wir nennen es bewusst Basis und nicht Liebling. Eine Basis ist das, worauf Sie zurückfallen, wenn ein Projekt keine Sonderanforderung hat. Sie muss also eher berechenbar sein als aufregend. Was wir in Projekten nutzen: getrennte Arbeitskopien, damit zwei Agenten an einer Funktion nie kollidieren. Mehrere Kommandozeilen-Agenten, damit die Prüfung auf einem anderen Modell läuft als die Umsetzung. Änderungsprüfung direkt in der Umgebung. Den eingebauten Browser, damit ein Agent die laufende Anwendung öffnet und die eigene Arbeit kontrolliert. Automatisierungen für die wiederkehrenden Schritte. Entfernte Server, damit eine lange Aufgabe nicht davon abhängt, ob jemand den Laptop zuklappt.
Der Design Mode verdient eine eigene Erklärung. Ein Mensch zeigt auf ein Element der Oberfläche. Der Agent bekommt dazu das DOM, die berechneten Stile, ein Bild davon und, wenn eine Source Map vorliegt, die Quelldatei und die Zeilennummer. Statt "korrigiere den Knopf oben rechts, nein, den anderen" bekommt der Agent eine Koordinate im Quellcode.
Orca trennt außerdem Oberfläche und Laufzeit. Repositories, Terminals, Arbeitskopien und Agenten können auf einer eigenen Maschine liegen. Laptop oder Telefon sind dann nur die Steuerung. Das Orchestrierungsmodul ergänzt Durchläufe, Aufgaben, überwachte Arbeiter, Nachrichten und Freigabepunkte. Das Signal ist nicht die Funktionsliste. Das Signal ist, dass die Koordinationsschicht in die Umgebung wandert. Früher haben wir diese Schicht selbst gebaut, mit MCP-Servern und Klebeskripten. Jetzt kommt sie mitgeliefert.
Für einen Kunden, der ein Portal oder ein CRM baut, ist die Wirkung einfach: Zwischen den Schritten geht weniger Kontext verloren. Weniger "was wollten wir hier nochmal" zwischen Fehlermeldung und Korrektur. Das ist kein Prozentwert, den wir nennen können. Und wir erfinden auch keinen.
super.engineering und die direkte Zusammenarbeit zwischen Agenten
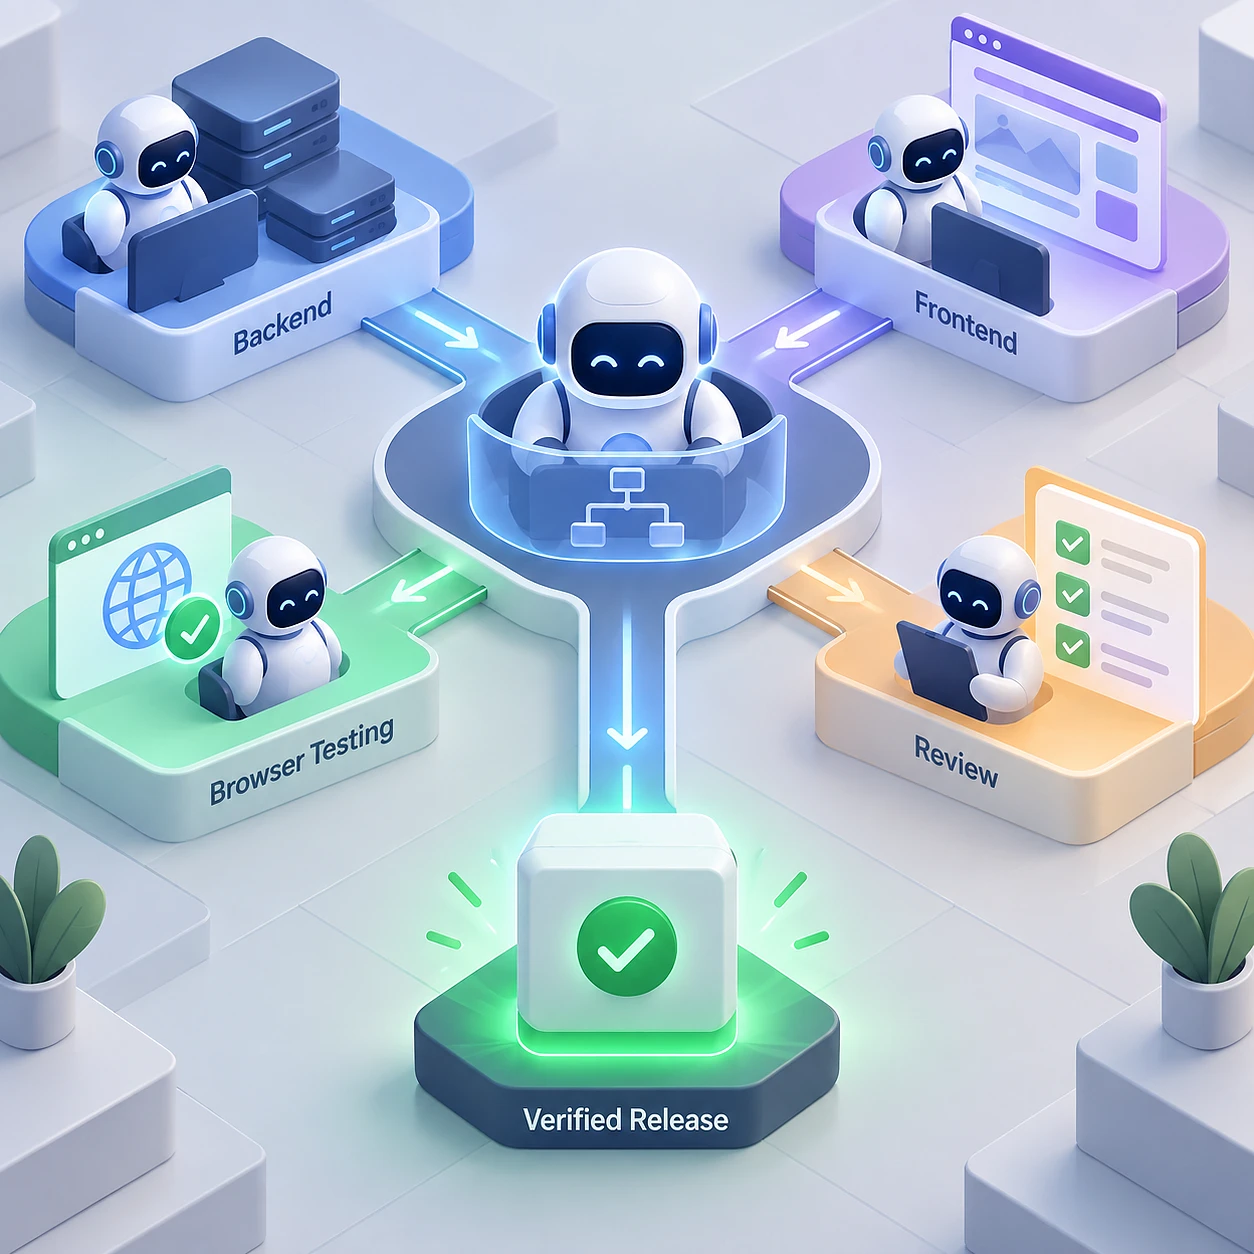
super.engineering ersetzt fünf getrennte Chatfenster durch ein Team. Ein führender Agent verteilt die Arbeit auf feste Rollen: Backend, Frontend, Tests und eine unabhängige Prüfung. Diese Rollen können auf verschiedenen Modellen und sogar bei verschiedenen Anbietern laufen. Die Agenten schicken sich Nachrichten. Wichtige Entscheidungen landen in einem maschinenlesbaren Koordinationszustand. Das ist das klarste Bild, das wir bisher davon gesehen haben, wohin Entwicklung mit mehreren Agenten geht. Es ist außerdem immer noch Alpha.
Genau wegen dieser Lücke probieren wir es aus. Ein Werkzeug, das die Form der Zukunft zeigt, lohnt sich zu verstehen, lange bevor es sich lohnt einzusetzen. Wir würden heute keinen Produktivprozess darauf umstellen, und das sagen wir Kunden direkt. Die anbieterübergreifende Rollenverteilung finden wir wirklich wertvoll. Setzen Sie den Prüfer auf eine andere Modellfamilie als den Umsetzer, dann findet er eine andere Klasse von Fehlern. Ein Modell teilt seine blinden Flecken mit sich selbst. Ein zweites Modell aus einer anderen Linie erbt die selbstsicheren Irrtümer des ersten nicht. Wir machen das in unserer eigenen Kette absichtlich. Es ist die günstigste Qualitätsverbesserung, die wir kennen.
Die zweite Idee zum Übernehmen ist der Koordinationszustand. In einfachen Worten: eine geordnete Aufzeichnung von Entscheidungen, wer welche Teilaufgabe besitzt, was blockiert ist, welche Fassung einer Schnittstelle gilt, dazu Prüfpunkte, Übergaben und Prüfergebnisse. Ein gemeinsames Heft, das Software lesen kann. Ohne so etwas ist jede Übergabe eine Erklärung von vorn.
Warum das für B2B-Projekte zählt: Eine Funktion kann gleichzeitig eine Single-Page-Anwendung, eine API, einen Anmeldedienst, die Abrechnung und die Benachrichtigungen berühren. Der gemeinsame Kontext gehört zur Funktion. Jeder Agent braucht trotzdem eine getrennte Arbeitsumgebung im jeweiligen Repository. Beides gleichzeitig zu haben ist das eigentliche technische Problem.
Die ehrlichen Grenzen: Alpha-Status, nur macOS, experimentelle Orchestrierung. Das macht es zu einem guten Ort für Versuche und zu einem schlechten Ort für Kundenprojekte. Das Zuschauen hat auch unseren Blick auf die eigene Geschichte verändert. Wir haben unsere Orchestrierung auf MCP-Basis selbst gebaut, weil es nichts gab. Es sah aus wie ein Umweg. Es war eine frühe Fassung der Schicht, auf die der Markt jetzt zuläuft.
ADE und Superset als starke Herausforderer mit verschiedenen Stärken
ADE (ade-app.dev) setzt auf die Lane. Eine Lane bündelt die Arbeitskopie, die Terminals, den Kontext des Agenten, die Ports, die Umgebungsvariablen, die Historie, die aktuellen Änderungen und den Zustand des Pull Requests. Dazu kommt ein Graph paralleler Arbeitskopien mit Bewertung des Konfliktrisikos. Superset setzt auf den eingebauten Browser als gemeinsame Fläche für Mensch und Agent. Beide lösen verschiedene Hälften desselben Problems. ADE verwaltet die Abhängigkeiten zwischen Änderungen. Superset verwaltet den Beweis, dass eine Änderung funktioniert.
ADE und die Lane
Eine Lane ist mehr als ein Zweig oder eine Arbeitskopie. Ein Zweig hält Code. Eine Lane hält den Code, die dazugehörigen Terminals, den gesammelten Kontext des Agenten, die Ports des Entwicklungsservers, die Umgebungsvariablen, die Historie, die aktuellen Änderungen und den Zustand des Pull Requests. Alles, was die Arbeit braucht, um genau dort weiterzulaufen, wo sie stehen geblieben ist.
Das klingt nach Bequemlichkeit, bis zehn Agenten gleichzeitig laufen. Dann ist die harte Frage nicht mehr "noch einen Agenten starten". Dann lautet sie "die Abhängigkeiten zwischen ihren Änderungen verwalten". ADE baut einen Graphen paralleler Arbeitskopien mit Bewertung des Konfliktrisikos. Das ist die richtige Form einer Antwort: wissen, welche zwei Änderungen sich streiten werden, bevor beide zur Prüfung kommen.
Synchrone Clients für Rechner, Terminal und Telefon zeigen in dieselbe Richtung wie alles andere hier. Die Laufzeit der Agenten wird ein eigenständiger Dienst. Die Vorsicht ist einfach. Das Projekt ist jung. Aussagen zur Reife der mobilen App und zu einzelnen Funktionen sollten Sie neu prüfen, bevor sich jemand im Projekt darauf verlässt.
Superset und der Browser als gemeinsame Fläche
Superset hat dauerhafte Arbeitsbereiche, Terminals, Agenten, entfernte Geräte, Automatisierungen und einen Mechanismus für Orchestrierung. Besonders macht es der eingebaute Browser. Sein Design Mode gibt dem Agenten das DOM, die Stile, React-Metadaten und ein Bildschirmfoto. Der Agent kann den Browser außerdem selbst steuern. Beide Richtungen zusammen ergeben eine Schleife, die wirklich neu ist: Der Mensch sieht die Seite und zeigt auf das Problem. Der Agent bekommt genauen technischen Kontext, ändert die Quelle, lädt neu und prüft das Ergebnis an der laufenden Anwendung.
Die Einordnung muss genau sein, denn Produktplan und ausgelieferte Funktion sind zweierlei. Die einfache Orchestrierung gibt es heute. Orchestration Chat, Selbstprüfung, Momentaufnahmen und Rücknahme, die Warteschlange für Aufmerksamkeit, Cloud-Sandboxes und iOS stehen im Plan. Wir nennen sie Kunden nicht als vorhandene Fähigkeiten.
Gemessen an unseren sechs Achsen: ADE ist bei Isolation und Kontext am stärksten, denn eine Lane ist im Kern ein Behälter für Kontext. Superset ist bei der Verifikation am stärksten, denn die Browser-Schleife schließt die Lücke zwischen "es baut" und "es funktioniert". Die Orchestrierung ist bei beiden echt, aber früh. Ist Ihr Hauptrisiko, dass parallele Änderungen kollidieren, dann zahlt sich die Wette von ADE aus. Ist es, dass Oberflächenfehler bis zur Abnahme durchrutschen, dann die von Superset.
Emdash, Conductor, Mux, Herdr und Codex: was jeder Ansatz beisteuert
Der Rest des Feldes ist kein Rauschen. Emdash ist die breite offene Plattform. Conductor ist streng auf dem Weg vom Arbeitsbereich über die Änderung und die Prüfungen bis zum Pull Request. Mux bringt eine eigene Laufzeit für mehrere Modelle mit. Die Codex App zeigt dieselbe Bewegung innerhalb eines einzigen Ökosystems. Jedes Werkzeug löst eine Achse besser als die Allrounder. Alle folgenden Beschreibungen sind Herstellerangaben.
- Emdash. Parallele Arbeitskopien, dutzende Kommandozeilen-Agenten, ein Browser, Automatisierungen, Tickets, Fähigkeiten und MCP, CI und entfernte Entwicklung. Einen Blick wert, wenn Sie Breite wollen und sich später noch umentscheiden möchten.
- Conductor. Eine strenge Kette: Arbeitsbereich, Agent, Änderung, Prüfungen, Pull Request. Ein gehosteter MCP-Dienst und eine API erlauben es einem externen führenden Agenten, Arbeitsbereiche anzulegen, Aufgaben zu verteilen und Ergebnisse einzusammeln. Gut, wenn Sie schon eine Orchestrierung haben und verlässliche Arbeiter brauchen.
- Mux. Eine eigene Laufzeit für mehrere Modelle, Ausführung lokal, in einer Arbeitskopie oder über SSH, dazu Prüfung und die Modi Plan und Exec, die Entscheiden und Tun trennen.
- Herdr. Eine dauerhafte Terminal-Laufzeit für viele Agenten. Sitzungen laufen weiter, wenn der Client die Verbindung trennt. Ein anderer Agent kann über eine API Sitzungen anlegen, Aufträge verteilen und die Zustände arbeitend, blockiert oder fertig abfragen. Das ist Infrastruktur, keine Werkbank.
- Codex App. Parallele Agenten, Arbeitskopien, Fähigkeiten, Automatisierungen und Fernsteuerung in einem Ökosystem. Interessant ist, dass ein einzelner Anbieter unabhängig bei denselben Bausteinen gelandet ist.
- OpenAI Symphony. Ein architektonischer Wegweiser. Das Aufgabenbrett wird zur Steuerungsebene. Jede Aufgabe bekommt eine getrennte Umgebung und einen Agenten. Das Ergebnis muss mit einem Arbeitsnachweis ankommen: Tests, CI und Prüfung.
Schauen Sie sich die Liste als Ganzes an, und das Muster ist kaum zu übersehen. Neun unabhängige Teams, verschiedene Finanzierung, verschiedene Ausgangspunkte, und alle landen bei denselben Bausteinen: Isolation, Dauerhaftigkeit, Orchestrierung, Verifikation, entfernte Laufzeit und Freigabe. Wenn Wettbewerber ohne Abschreiben bei denselben Bausteinen ankommen, dann sind diese Bausteine das eigentliche Produkt. Oberflächen ändern sich ständig. Die Bausteine sind stabil genug, um einen Prozess darauf zu bauen.
Übersicht: Werkzeuge gegen unsere sechs Bewertungsachsen
| Werkzeug | Isolation | Kontext | Orchestrierung | Verifikation | Entfernte Laufzeit | Freigabe |
|---|---|---|---|---|---|---|
| Orca | Verfügbar | Verfügbar | Verfügbar (Modul) | Verfügbar (Browser) | Verfügbar (Server, mobil) | Verfügbar |
| super.engineering | Verfügbar | Verfügbar (Koordinationszustand) | Alpha | Teilweise | Teilweise (nur macOS) | Verfügbar (Prüferrolle) |
| ADE (ade-app.dev) | Verfügbar (Lane) | Verfügbar (Lane) | Teilweise (Risikograph) | Teilweise | Verfügbar (synchrone Clients) | Verfügbar (Änderungen, Pull Request) |
| Superset | Verfügbar | Verfügbar | Teilweise (Chat geplant) | Verfügbar (Browser) | Verfügbar (entfernte Geräte) | Teilweise (Rücknahme geplant) |
| Emdash | Verfügbar (Arbeitskopien) | Verfügbar | Teilweise | Verfügbar (Browser, CI) | Verfügbar | Verfügbar |
| Conductor | Verfügbar (Arbeitsbereiche) | Verfügbar | Verfügbar (MCP, API) | Verfügbar (Prüfungen) | Teilweise | Verfügbar (Änderung bis Pull Request) |
| Mux | Verfügbar (Arbeitskopie, SSH) | Verfügbar | Teilweise (Plan, Exec) | Teilweise | Verfügbar (SSH, Web) | Verfügbar |
| Herdr | Verfügbar (Sitzungen) | Teilweise | Verfügbar (API) | Teilweise | Verfügbar (dauerhaft) | Teilweise |
| Codex App | Verfügbar (Arbeitskopien) | Verfügbar | Teilweise | Teilweise | Verfügbar | Verfügbar |
Nutzen Sie die Tabelle als ersten Filter, nicht als Urteil. Suchen Sie die Achse, an der Ihr Projekt hängt. Lesen Sie diese Spalte von oben nach unten. Testen Sie dann zwei oder drei Kandidaten eine Woche lang an echter eigener Arbeit. Jede Zelle ist eine Aussage über ein Produkt, das sich schnell bewegt.
Von Sitzungen zu Arbeit: führender Agent, spezialisierte Arbeiter und unabhängige Prüfung
Die wichtigste Verschiebung ist kein besseres Modell. Sie ist der Wechsel: Sie springen nicht mehr zwischen Agentenfenstern, Sie nennen ein Ziel. Ein führender Agent zerlegt die Aufgabe, verteilt Rollen, setzt das Ergebnis zusammen und eskaliert nur das, was wirklich einen Menschen braucht. Das ist unser Standardmodell: Ein Agent plant, mehrere setzen um, ein weiterer prüft, ein Entwickler gibt frei.
Klick gemacht hat es bei einer ERP-Anbindung. Ein Entwickler war fast einen ganzen Tag lang Nachrichtenverteiler zwischen drei Agentenfenstern und hat dieselbe Schnittstelle dreimal erklärt. Irgendwann kam die naheliegende Frage. Warum macht ein erfahrener Entwickler Botengänge?
Unsere Kette bei ernsthafter Arbeit, unabhängig von der Umgebung:
- Analyse von System und Modulen durch zwei unabhängige Spitzenagenten, die parallel an derselben Frage arbeiten.
- Zusammenführung der Analysen. Die Widersprüche werden sichtbar gemacht und nicht weggemittelt.
- Eine Architekturentscheidung wird aufgeschrieben und danach von einem anderen Agenten kritisiert, der sie nicht geschrieben hat.
- Umsetzung, verteilt auf spezialisierte Agenten in getrennten Arbeitskopien.
- Anbieterübergreifende Quellcode-Prüfung. Der Prüfer läuft auf einer anderen Modellfamilie als der Umsetzer.
- Tests, Integration und Ende zu Ende, ausgeführt gegen die echte Änderung.
- Freigabe durch den Menschen. Durch den Entwickler, der die Folgen trägt.
Zwei unabhängige Agenten statt einem, weil sie verschieden scheitern. Kommen beide zum selben Schluss, steigt die Sicherheit günstig. Sind sie uneinig, ist genau diese Uneinigkeit das wertvollste Ergebnis des Schritts. Sie zeigt auf den Teil des Systems, der mehrdeutig ist. Und aus Mehrdeutigkeit entstehen Störungen im Betrieb.
Eine Architekturentscheidung ADR ist ein kurzes Dokument. Es sagt, was wir entschieden haben, was wir sonst noch erwogen haben und warum. Eine Seite. Wir lassen Agenten so ein Dokument schreiben, weil ein Agent, der eine Entscheidung nicht in einfachen Worten erklären kann, meist gar keine Entscheidung getroffen hat. Er hat geraten, und es ließ sich übersetzen. Danach gehört dem Entwickler die Übernahme, die Freigabe und die Folge. Menschliche Kontrolle im Prozess ist hier eine Entwurfsentscheidung und kein Hinweis im Kleingedruckten.
"Der Wendepunkt kam für uns, als wir aufgehört haben, einen Agenten als weiteren Chat-Reiter zu sehen. Viel spannender ist es, eine Aufgabe zu steuern: Ein Agent plant, mehrere setzen um, ein weiterer prüft, und der Entwickler trägt die Verantwortung für das Ergebnis." - Andrew Popov, CTO und Gründer, Webdelo
Herausgekommen ist das Organigramm eines kleinen Teams, angewendet auf Software. Ein Planer, mehrere Macher, ein unabhängiger Prüfer, ein verantwortlicher Eigentümer. Diese Struktur wurde nicht für KI erfunden. Und dass sie funktioniert, hat nichts damit zu tun, ob die Arbeiter Menschen sind.
Wie wir dieses Modell für CRM, ERP, mehrere Repositories und stark belastete Systeme nutzen
Das Modell mit Agenten-Teams zahlt sich genau bei den Projekten aus, die früher am langsamsten waren. CRM-Funktionen über Rechte und Datenkonsistenz hinweg. ERP-Entwicklung über mehrere Repositories. Betreuung großer Altsysteme. Umstellungen mit viel mechanischer Arbeit. Die Form ist jedes Mal gleich: getrennte Arbeitskopien, eine vereinbarte Schnittstelle im gemeinsamen Kontext und eine Prüfung, die die ganze Kette abdeckt und nicht nur einen Dienst. Das sind echte Projektmuster, beschrieben ohne erfundene Zahlen. Dieselben Muster gelten außerhalb der Unternehmenssoftware. Wenn wir eine Immobilien Webseite erstellen, verhalten sich Objektdaten und Fremdsysteme genau wie ERP-Daten.
CRM-Projekte
Der führende Agent zerlegt die Funktion in Teile, die sich unabhängig bewegen. Ein Backend-Agent setzt Geschäftsregeln und API um. Ein Frontend-Agent übernimmt Oberfläche und Zustand. Ein Test-Agent schreibt Integrations- und Ende-zu-Ende-Tests gegen die vereinbarte Schnittstelle. Ein eigener Prüfer kontrolliert Rechte, Datenkonsistenz und Regressionen. Denn diese drei sind für das meiste verantwortlich, was nach einer CRM-Freigabe schiefgeht.
ERP und mehrere Dienste
Eine Aufgabe reicht über mehrere Repositories. Jeder Agent bekommt eine getrennte Arbeitskopie in seinem Repository. Der gemeinsame Kontext hält die vereinbarte Schnittstelle. Das ist das eine Dokument, das alle gleich lesen müssen. Danach prüft ein Integrationstest die ganze Kette. Eine Änderung, die in jedem Dienst besteht und zwischen den Diensten scheitert, ist der klassische ERP-Fehler. Tests pro Dienst finden ihn nie.
Betreuung großer Systeme und Modernisierung von Altsystemen
Der Agent untersucht den Vorfall, die Protokolle und die fehlgeschlagenen Tests. Er bereitet eine eng begrenzte Änderung vor, öffnet einen eigenen Zweig und hängt die Nachweise an. Eng begrenzt ist das entscheidende Wort. Eine große Änderung von einem Agenten in einem System, das niemand ganz versteht, ist bei jedem Tempo ein schlechtes Geschäft. Die Verantwortung für den Betrieb bleibt beim Entwickler.
Umstellungen, Aufräumarbeiten und Datenbankmigration
Die mechanischen Teile lassen sich sauber auf mehrere Agenten verteilen. Ein Koordinator verfolgt, welche Änderung von welcher abhängt. Eine gemeinsame Testreihe läuft nach dem Zusammenführen, nicht nur pro Zweig. Denn gerade bei Umstellungen bestehen Änderungen einzeln und ergeben zusammen etwas Kaputtes.
B2B-Portale
Browser und Design Mode verkürzen den Weg vom sichtbaren Fehler zur echten Komponente und zur Quelldatei. Jemand zeigt auf das kaputte Element. Der Agent bekommt das DOM, die berechneten Stile und eine Zeilennummer. Ein Hin und Her, das früher einen Tag voller Bildschirmfotos kostete, dauert Minuten. Von außen sieht der Kunde weniger Überraschungen bei der Abnahme, weil jede Änderung mit Nachweisen ankommt. Aus demselben Grund arbeiten unsere Webdesign Agentur und unsere Entwicklung heute auf derselben Prüffläche.
Prüfung im Browser und über das Betriebssystem als Arbeitsnachweis
Code, der sich übersetzen lässt, ist keine fertige Funktion. Für uns ist eine Änderung fertig, wenn ein Agent die echte Anwendung in einem echten Browser bedient hat und der Anwendungsfall wirklich funktioniert. Der Agent öffnet die Seite, klickt sich durch den Ablauf, liest das DOM, macht Bildschirmfotos und hängt diese Nachweise an die Änderung. Bei CRM, ERP und B2B-Portalen ist das der Unterschied zwischen "es baut" und "es funktioniert".
Wir haben daraus eine harte Regel gemacht, aus einem unspektakulären Grund. Code von Agenten besteht Tests mit hoher Quote und scheitert trotzdem am Anwendungsfall. Denn die Tests wurden gegen dasselbe Missverständnis geschrieben wie der Code. Ein zweiter Blick aus demselben Kopf findet nichts. Die laufende Anwendung zu bedienen ist dagegen eine wirklich unabhängige Prüfung.
Ein Arbeitsnachweis ist konkret ein Paket an der Änderung: Testergebnisse, CI-Status, ein Browser-Durchlauf, Bildschirmfotos an den wichtigen Schritten und ein Satz dazu, welcher Ablauf geprüft wurde. Ein Prüfer überfliegt das in einer Minute. Eine Fachperson ohne Technikhintergrund schaut auf die Bildschirmfotos und erkennt den eigenen Prozess wieder.
Der Design Mode dreht dieselbe Schleife um. Statt dass der Agent beweist, dass der Ablauf läuft, zeigt ein Mensch auf die Stelle, an der er nicht läuft. Einen sichtbaren Fehler in Worten zu beschreiben ist ein verlustbehafteter Kanal. Darauf zu zeigen nicht. Die Prüfung über die Bedienung des Betriebssystems geht über den Browser hinaus: Wenn das Produkt nicht rein webbasiert ist, kann ein Agent auch einen Ablauf auf dem Rechner oder ein Fenster einer nativen Anwendung kontrollieren.
Wo es ehrlich gesagt nicht trägt: bei wackeligen Umgebungen, in denen ein Fehlschlag nichts aussagt. Bei Anmeldehürden, die einen automatischen Zugriff unklug machen. Bei fremden Systemen, die wir nicht bedienen dürfen. Und bei Urteilsfragen, etwa ob eine Ansicht gut lesbar ist. In diesen Fällen schaut ein Mensch hin, und wir planen die Zeit dafür ein. Der Grund für diesen Aufwand ist übertragenes Vertrauen. Ein Arbeitsnachweis ist das, was einer Fachperson ohne Programmierkenntnisse erlaubt, einer Änderung von einem Agenten zu glauben.
Warum die Laufzeit vom Entwickler-Laptop wegzieht
Die Maschine, die das Repository hält und die Agenten laufen lässt, muss kein Laptop mehr sein. Orca Server, die entfernten Geräte von Superset, ADE, Herdr und die Codex App zeigen alle in dieselbe Richtung. Für Projekte im Unternehmen geht es dabei nicht um Bequemlichkeit. Eine eigene Laufzeit gibt echte Kontrolle über Abhängigkeiten, Zugangsdaten, Netzwerkzugriff und langlaufende Prozesse. Und die Arbeit läuft weiter, wenn der Laptop zugeht.
Der Auslöser war banal. Langfristige agentische Arbeit, also ein Auftrag über Stunden statt über Sekunden, passt nicht in eine Sitzung, die endet, wenn jemand um 18:00 Uhr den Deckel zuklappt.
Was eine eigene Laufzeit einem Unternehmen bringt, in der Reihenfolge, die ein Sicherheitsteam interessiert: Kontrolle über Abhängigkeiten, damit die Umgebung bekannt ist und nicht das, was sich auf einem Rechner angesammelt hat. Trennung der Zugangsdaten, damit der Zugriff eines Agenten auf einen Server begrenzt ist, den Sie verwalten. Kontrolle über den Netzwerkzugriff. Reproduzierbare Umgebungen, damit ein Fehler untersucht werden kann. Hintergrundaufträge, die Verbindungsabbrüche überleben. Und ein einziger Punkt für Protokolle, was über fünfzehn private Laptops kaum zu schaffen ist.
Herdr ist das klarste Beispiel für dauerhafte Sitzungen. Sie laufen weiter, wenn der Client die Verbindung trennt. Ein anderer Agent kann über eine API Sitzungen anlegen, Aufträge verteilen und ihren Zustand abfragen. Sobald das existiert, ist der Client nur noch ein Fenster: Rechner, Terminal, Web oder Telefon, alle auf dieselbe Laufzeit gerichtet.
Die Kosten sind real, und wir sagen sie klar. Ein Budget für den Server. Betriebliche Verantwortung, denn jemand muss ihn betreiben. Eine weitere Fläche, die abgesichert werden muss. Für ein Zweierteam ist das ein schlechtes Geschäft. Für ein Unternehmen, dessen Agenten produktive Systeme berühren, ist es die einzig verantwortbare Aufstellung. Denn wenn Agenten Kundencode und Kundendaten anfassen, gehört die Laufzeit zu Ihrem Sicherheitsbereich. Wo sie liegt, ist eine betriebliche Entscheidung und keine Geschmacksfrage. Genau danach fragt ein deutscher oder US-amerikanischer Einkäufer im ersten Gespräch.
Was die Daten zur Produktivität von Entwicklern wirklich sagen
Die ehrliche Antwort: Es hängt von der Art der Arbeit ab. In einem kontrollierten Versuch von GitHub mit 95 Berufsentwicklern war die Copilot-Gruppe bei einer klar begrenzten JavaScript-Aufgabe rund 55 % schneller. In der METR-Studie von 2025 brauchten 16 erfahrene Open-Source-Entwickler bei 246 echten Aufgaben in Repositories, die sie gut kannten, rund 19 % länger. Beide Ergebnisse sind echt. Sie beantworten verschiedene Fragen. Wir verkaufen Ihnen keinen Prozentwert.
Verbreitung und Vertrauen
Die Stack Overflow Entwicklerumfrage 2025 nennt 84 % der Befragten, die KI-Werkzeuge nutzen oder nutzen wollen. 51 % der Berufsentwickler nutzen sie täglich. Die Verbreitung ist entschieden.
Beim Vertrauen zeigt dieselbe Umfrage ein anderes Bild. 46 % misstrauen der Genauigkeit der KI-Ausgabe eher, 33 % vertrauen ihr, und nur 3 % berichten von hohem Vertrauen. Der größte Teil des Berufsstandes nutzt diese Werkzeuge also täglich und prüft die Arbeit genau. Die Umfrage nennt auch den Fehlermodus: 66 % nannten "fast richtige" Antworten ein Problem, und 45 % erlebten Fälle, in denen die Fehlersuche in KI-Code länger dauerte. Fast richtig ist der teure Fehler. Offensichtlich falscher Code wird in zehn Sekunden gelöscht.
Die zwei kontrollierten Ergebnisse, die sich widersprechen
Die GitHub-Studie: 95 Berufsentwickler, eine klar begrenzte JavaScript-Aufgabe, rund 55 % schneller mit Copilot. Ein sauberes Beispiel dafür, wo KI wirklich beschleunigt: klarer Umfang, eindeutige Ziellinie.
Die METR-Studie 2025: 16 erfahrene Entwickler, 246 echte Aufgaben, in gewachsenen Repositories, die sie bereits gut kannten. Mit den Werkzeugen von Anfang 2025 dauerte die Arbeit rund 19 % länger.
Am nützlichsten finden wir nicht die Schlagzeile. Die Entwickler erwarteten vorher rund 24 % Tempogewinn. Hinterher, obwohl sie tatsächlich langsamer waren, glaubten sie immer noch, KI habe sie um rund 20 % beschleunigt. Die Fehleinschätzung hat die Messung überlebt. Das ist eine Warnung vor jeder internen Produktivitätsaussage aus dem Gedächtnis, auch vor unserer. METR warnt ausdrücklich, dass das Ergebnis nicht für alle Softwareentwicklung gilt. Wir wiederholen diese Warnung, statt uns die Zahl zu leihen.
Die Lesart auf Systemebene
Die DORA-Arbeit von 2025 liefert den Rahmen, in dem beide Ergebnisse Sinn ergeben. KI verstärkt das vorhandene Entwicklungssystem. Eine um 55 % schnellere Aufgabe in einem Prozess, in dem Änderungen zwei Wochen auf die Prüfung warten, bringt im Unternehmen nichts.
Die messbare Frage lautet nie "beschleunigt KI das Programmieren". Sie lautet: Wird diese Art Arbeit in diesem Entwicklungsprozess schneller und sicherer? Bei begrenzten und prüfbaren Aufgaben meist ja. Bei tiefen Änderungen in einem gewachsenen System, das das Team genau kennt, oft nein. Wir veröffentlichen keine internen Webdelo-Prozentwerte, weil wir keine kontrollierte interne Messung haben. Und nach der Fehleinschätzung bei METR würden wir einer beiläufigen Messung auch nicht trauen.
Wo KI-Agenten ein Team bremsen und wann wir bewusst nicht orchestrieren
Manchmal schlägt ein Agent fünf Agenten. Manchmal schlägt kein Agent einen. Wir orchestrieren nicht, wenn die Aufgabe klein ist. Nicht, wenn der Agent den Code nicht kennt und der Entwickler ihn sehr genau kennt. Nicht, wenn sich Abnahmekriterien nicht aufschreiben lassen. Und nicht, wenn die Abstimmung klar teurer ist als die Arbeit. Das offen zu sagen gehört zur Leistung. Die folgenden Fehlschläge sind unsere eigenen. Wir sind in jeden hineingelaufen.
Die Kosten der Orchestrierung sind nicht versteckt, sie werden nur selten genannt. Mehr Agenten heißt mehr Abstimmung, mehr Konflikte beim Zusammenführen, mehr Token, mehr Rechenzeit und mehr Prüfaufwand. Bei einer Aufgabe von zwei Stunden kostet das Aufsetzen von drei Agenten mehr als die Aufgabe.
Die "fast richtig"-Falle ist die teure. 66 % der befragten Entwickler nennen sie, und 45 % berichten von längerer Fehlersuche in KI-Ausgaben. Plausibler Code, der an einer feinen Stelle falsch ist, übersteht eine flüchtige Prüfung. Er besteht Tests, die gegen dasselbe Missverständnis geschrieben wurden. Und er taucht im Betrieb auf. Gewachsene Repositories mit viel ungeschriebenem Wissen sind dieselbe Sache in der Form von METR. Der Entwickler weiß, warum eine Funktion seltsam aussieht, welches Modul zerbrechlich ist und was letztes Jahr kaputtging. Nichts davon steht im Repository. Also liefert der Agent eine technisch vernünftige Änderung, die vier ungeschriebene Regeln ignoriert.
Unsere ausdrückliche Liste, wann wir nicht orchestrieren:
- kleine Änderungen, bei denen das Aufsetzen teurer ist als die Arbeit
- Erkundungen, bei denen das Ziel ist, dass ein Mensch etwas versteht
- Störungen im Betrieb, die eine entscheidungsfähige Person brauchen und keinen Ausschuss aus Agenten
- Arbeit ohne Test, der die Richtigkeit beweisen kann
- alles, wo die Schnittstelle noch strittig ist
In diesen Fällen nutzen wir einen Agenten, engen Umfang, Mensch am Steuer. Oder gar keinen Agenten.
"In der Unternehmensentwicklung beginnt Selbstständigkeit mit Grenzen. Zuerst legen wir Rechte, Kontext, Tests und Abnahmekriterien fest, und erst dann geben wir dem Agenten mehr Freiheit." - Andrew Popov, CTO und Gründer, Webdelo
Ein Anbieter, der Ihnen nicht sagen kann, wann man die Technik nicht einsetzt, verkauft die Technik und nicht das Ergebnis. Fragen Sie jeden Anbieter nach seiner Liste der Fälle, in denen er keine Agenten nutzt. Gibt es keine, dann spricht die Begeisterung. Die Liste ist auch der schnellste Weg herauszufinden, ob ein Team das im Betrieb gefahren hat. Denn solche Grenzen lernt man nur, indem man sie überschreitet.
Sicherheit, Rechte, Beobachtbarkeit und Steuerung für Agenten im Unternehmen
Ein Agent ist ein Stück Software mit Zugangsdaten, Netzwerkzugriff und der Fähigkeit zu handeln. Behandeln Sie ihn so. NIST arbeitet an Identität und Befugnis für Software-Agenten. Der Agent Control Standard von OWASP macht den Punkt, dass das Verhalten eines Agenten zur Laufzeit beobachtbar, nachvollziehbar und steuerbar sein muss. In der Praxis heißt das: kleinstmögliche Rechte, getrennte Zugangsdaten, begrenzte Werkzeuge, Protokolle, Freigabepunkte und ein klarer Weg zur Eskalation an einen Menschen. Diesen Abschnitt liest ein Einkäufer im Unternehmen zuerst. Deshalb geht er hier in die Tiefe.
Identität, Zugriff und Grenzen des Handelns
Drei Fragen, in dieser Reihenfolge. Wer ist der Agent als eigene Identität in Ihren Systemen? Was darf er anfassen? Welche Werkzeuge darf er aufrufen? Kleinstmögliche Rechte gelten genau wie bei einem Dienstkonto. Ein Agent, der an der Oberfläche arbeitet, braucht keine Zugangsdaten zur Produktionsdatenbank.
Die Trennung von Zugangsdaten zählt bei Agenten mehr als bei Menschen, denn Agenten handeln schnell und in Menge. Ein Mensch mit dem falschen Schlüssel macht einen Fehler. Ein Agent mit dem falschen Schlüssel macht zweihundert. Begrenzen Sie den Werkzeugkasten, bevor Sie Selbstständigkeit geben. Die Arbeit von OWASP zur Kontrolle von Agenten ist die praktischste Startquelle, die wir kennen.
Beobachtbarkeit und Überwachung zur Laufzeit
Sie müssen im Nachhinein beantworten können: Was hat er getan und warum? Dafür brauchen Sie Protokolle der Handlungen, eine Spur von der Entscheidung zurück zu ihren Eingaben, eine Verhaltensüberwachung während des Laufs und genug aufgezeichneten Zustand, um alles nachzustellen. Die Reproduzierbarkeit lassen Teams am ehesten weg. Und genau sie zählt im Störfall.
Menschliche Aufsicht und Freigabepunkte
Freigaben vor dem Zusammenführen. Und Freigaben vor jeder Handlung mit Wirkung nach außen: eine E-Mail senden, eine Karte belasten, in ein Produktivsystem schreiben, eine Partner-API aufrufen. Der Eskalationsweg muss feststehen, bevor der Agent blockiert ist, und nicht währenddessen erfunden werden. Ein Agent, der unsicher ist, soll anhalten und eine benannte Person fragen, die es im Organigramm gibt.
Getrennte Umgebungen, Netzwerkkontrolle und Lieferkette
Abgeschottete Umgebungen, damit ein Fehler eingegrenzt bleibt. Kontrollierter Netzwerkzugriff, damit der Agent erreicht, was er braucht, und sonst nichts. Und Steuerung der Lieferkette für die Zusatzmodule, Fähigkeiten und MCP-Server, die ein Agent laden darf. Ein Agent, der zur Laufzeit ein Werkzeug installiert, hat Ihre Lieferkette ohne Prüfung erweitert. Die Werkzeuge zur Steuerung dieses Punktes sind im ganzen Markt noch unreif, auch bei uns.
Der Blick auf EU und Deutschland
Kurz, und das ist keine Rechtsberatung. Der AI Act führt Agenten nicht als eigene rechtliche Kategorie. Bestehende Anforderungen an KI-Systeme können aber für passende Fälle gelten. Getrennte Transparenzpflichten gelten seit dem 2. August 2026. Für einen deutschen Einkäufer folgt daraus vor allem Prozess: wissen, was das System tut, es zeigen können und eine Dokumentation führen, die einer Nachfrage standhält.
Eine Prüfliste, die Sie in Ihren eigenen Anbieterfragebogen übernehmen können: kleinstmögliche Rechte, getrennte Zugangsdaten, begrenzte Werkzeuge, Protokolle, Freigabepunkte, getrennte Umgebungen, Kontrolle des Netzwerkzugriffs, Reproduzierbarkeit, Eskalation an Menschen. Unternehmenssoftware-Entwicklung mit KI muss Daten, Rechte, Transparenz und die Rechtsordnung des Kunden berücksichtigen. Das Modell ist in dieser Liste die unwichtigste Größe. Wir arbeiten nach den Grundsätzen von GDPR und DSGVO und bauen Prozesse entlang der Grundsätze von ISO 27001 und SOC 2. Das Unternehmen ist auf dem Weg zur formalen Zertifizierung und hat noch kein Zertifikat.
Wie wir KI-Agenten in Geschäftsprozesse von Kunden einbauen
Den meisten Firmen muss man nicht erzählen, dass es KI gibt. Sie brauchen KI in einem echten Prozess, mit sicherem Zugriff auf Daten, klarer Verantwortung und einem wiederholbaren Ergebnis. McKinsey fand 2025 heraus, dass 88 % der Organisationen KI in mindestens einer Funktion nutzen, aber nur 7 % sie als vollständig ausgerollt betrachten. Deloitte fand im August 2026 rund 5 % der Organisationen prozessbereit für Agenten. Diese Lücke ist die Arbeit. Dieselbe Lücke gibt es im Marketing. Deshalb gehört auch Google SEO heute in dieselbe Prozessfrage.
Die vollen Zahlen, jede mit Quelle. McKinsey, 2025: 88 % nutzen KI irgendwo, 7 % vollständig ausgerollt. Deloitte, August 2026: rund 5 % prozessbereit für Agenten, rund 15 % mit einem skalierten, abteilungsübergreifenden Multi-Agenten-Ablauf, und 74 % der befragten Führungskräfte erwarten, dass innerhalb von vier Jahren fast die Hälfte der Geschäftsprozesse um Agenten herum neu gebaut wird. Zusammengelesen: fast überall Versuche, sehr wenig Betriebsreife und hohe Erwartungen in kurzer Zeit.
Wo wir Agenten im Betrieb von Kunden tatsächlich einsetzen: Kundenbetreuung, interne Wissensdatenbanken, Vertriebsabläufe, Dokumentenverarbeitung, Softwarequalitätssicherung und Entwicklungsprozesse. Gemeinsam ist diesen Fällen ein Prozess mit klarer Eingabe, klarer Ausgabe und einer Möglichkeit zu erkennen, ob das Ergebnis richtig war. Die Punkte, die wir jedes Mal festlegen: begrenzte Rechte, vollständige Protokolle, ein fester Eskalationsweg zu einem benannten Menschen und ein messbares Abnahmekriterium, das vor dem Start vereinbart wird. Dieselbe Liste gilt, wenn Agenten das Online Marketing berühren. Dort ist eine falsche Ausgabe in Minuten öffentlich.
Wie eine Zusammenarbeit meist beginnt
Ein Schnitt nach 30 / 60 / 90 Tagen funktioniert gut. Erster Monat: einen klar begrenzten Prozess auswählen, ihn messbar machen und den heutigen Stand messen. Zweiter Monat: den Agenten laufen lassen, mit menschlicher Freigabe für jede Ausgabe. Dritter Monat: den Umfang nur dort erweitern, wo die Belege tragen, und die Freigabe überall dort lassen, wo sie es nicht tun. Wir haben diesen Schnitt von ERP-Einführungen bis zu Beauty Salon SEO gefahren. Der erste Monat besteht immer aus Messen.
Warnzeichen, die Sie bei jedem Anbieter prüfen sollten, auch bei uns. Kein Protokoll. Kein Weg zurück. Kein benannter Verantwortlicher. Keine Möglichkeit, das Ergebnis nach dem Start zu messen. Schon eines davon heißt: Das Projekt ist eine Vorführung und keine Einbindung. Einbindung ist Prozessgestaltung mit einem Softwareanteil. Die Auswahl des Modells dauert einen Nachmittag. Die Frage, wer die Verantwortung trägt, wenn der Agent falsch liegt, dauert den Rest des Projekts. Und sie entscheidet, ob es die erste schlechte Woche übersteht.
Wie die normale agentische Entwicklungsumgebung in 6-12 Monaten aussehen dürfte
Vier Dinge laufen zusammen. Arbeit zu steuern ersetzt Sitzungen zu steuern. Die Laufzeit zieht weiter vom Laptop weg. Der Browser wird die übliche Prüffläche. Und die Kommunikation zwischen Agenten wird Infrastruktur: Identität, Rollen, Nachrichten, gemeinsamer Zustand, Sperren, Besitz, Lebenszyklus, Rechte und Beobachtbarkeit wandern aus selbstgebauten Skripten in die Umgebung selbst. Das ist eine Prognose, und wir sagen dazu, wie sicher wir sind. Bei der Richtung sind wir recht sicher. Beim Zeitpunkt nicht. Eine fünfte Verschiebung liegt knapp neben der Entwicklung: GEO SEO und KI-Antwortmaschinen verändern, wie ein Kunde einen Anbieter überhaupt findet.
Trend 1: von der Steuerung der Sitzungen zur Steuerung der Arbeit. Der Hauptbildschirm der Umgebung wird ein Aufgabenbrett und kein Raster aus Terminals. Sie nennen ein Ziel, das System zerlegt es, und Sie öffnen ein Terminal nur, wenn Sie gebraucht werden.
Trend 2: die Laufzeit trennt sich von der Oberfläche. Schlanke Clients, dauerhafte Agenten auf dem Server, Arbeit, die weiterläuft, wenn Sie den Laptop zuklappen. In ausgelieferten Produkten schon zur Hälfte da.
Trend 3: der Browser als gemeinsame Prüffläche. Beide Richtungen der Schleife: Der Mensch zeigt auf einen Fehler, und der Agent beweist, dass der Ablauf funktioniert. Das wird Pflicht statt Alleinstellungsmerkmal.
Trend 4: die Kommunikation zwischen Agenten wird Infrastruktur. Heute baut jedes ernsthafte Team eine eigene Fassung der Koordinationsschicht. In einem Jahr wird das aussehen wie einen eigenen HTTP-Client zu schreiben.
Was in zwölf Monaten wohl ungelöst bleibt: die Kostenkontrolle, das Auflösen von Konflikten über viele parallele Änderungen hinweg und eine vertrauenswürdige selbstständige Prüfung, also ein Agent, dem Sie glauben können, wenn er sagt, die Arbeit sei fertig. Werkzeuge laufen zusammen und werden dann austauschbar. Vorn sind am Ende die Teams mit einem Prozess, der es wert ist, verstärkt zu werden.
Glossar: die Begriffe aus diesem Artikel
Einfache Erklärungen zu den Begriffen von oben, alle herstellerneutral.
- Agentische Entwicklungsumgebung (ADE). Ein Arbeitsplatz, gebaut für den Betrieb und die Koordination mehrerer eigenständiger Programmieragenten, mit eingebauter Trennung, gemeinsamem Kontext, Prüfung und Freigabe.
- Agentische IDE. Ein Code-Editor, in dem eine KI eine mehrstufige Änderung in einer Sitzung planen und ausführen kann. Ein Agent, eine Aufgabe.
- KI-Programmieragenten. Programme, die eine Aufgabe lesen, Schritte festlegen, Code ändern und Befehle ausführen, statt nur Text vorzuschlagen.
- Orchestrierung von KI-Agenten. Mehrere Agenten so koordinieren, dass sie Arbeit teilen, ihr Wissen austauschen und die Ergebnisse zu einer Änderung zusammenführen.
- Führender Agent. Der Agent, der die Aufgabe zerlegt, Rollen verteilt, das Ergebnis zusammensetzt und bei Bedarf an einen Menschen eskaliert.
- Arbeitskopie und Isolation. Eine eigene Kopie des Repositories, damit die Änderungen eines Agenten die eines anderen vor der Prüfung nicht stören.
- Lane. Ein Bündel aus allem, was eine Arbeitseinheit braucht: Arbeitskopie, Terminals, Kontext des Agenten, Ports, Umgebungsvariablen, Historie, Änderungen und Zustand des Pull Requests.
- Kontextfenster. Die Menge an Text, die ein Modell gleichzeitig im Blick hat. Wird sie überschritten, fällt das Älteste heraus.
- Zwischenspeicher für Prompts. Bereits verarbeiteter Hintergrundtext wird über mehrere Züge wiederverwendet. Lange Sitzungen kosten dadurch weniger und starten schneller.
- Langfristige agentische Arbeit. Ein Auftrag, der über Stunden oder viele Schritte läuft, statt in einem Austausch fertig zu sein.
- Multi-Agenten-Ablauf. Eine feste Abfolge, in der verschiedene Agenten Planung, Umsetzung, Tests und Prüfung übernehmen.
- Parallele KI-Agenten. Mehrere Agenten, die gleichzeitig an verschiedenen Teilen einer Aufgabe arbeiten.
- Architekturentscheidung ADR. Ein kurzes Dokument, das festhält, was entschieden wurde, was sonst erwogen wurde und warum.
- Anbieterübergreifende Quellcode-Prüfung. Ein Modell eines anderen Anbieters oder einer anderen Familie prüft den Code, damit es die blinden Flecken des Autors nicht teilt.
- Menschliche Kontrolle im Prozess. Ein Aufbau, in dem eine Person festgelegte Schritte freigibt, besonders alles mit Wirkung außerhalb des Systems.
- Arbeitsnachweis. Die Belege an einer Änderung: Testergebnisse, CI-Status, ein Browser-Durchlauf, Bildschirmfotos und der geprüfte Ablauf.
- Prüfung über das Betriebssystem. Ein Ergebnis kontrollieren, indem der Agent das Betriebssystem selbst bedient. Für Produkte, die nicht rein webbasiert sind.
- Entfernte Laufzeit. Repositories, Terminals und Agenten laufen auf einem Server. Laptop oder Telefon sind nur die Steuerung.
- MCP. Eine einheitliche Schnittstelle, über die Agenten externe Werkzeuge und Datenquellen anbinden.
- Freigabepunkt. Eine Stelle, an der die Arbeit stoppt, bis eine benannte Person sie freigibt.
- Kleinstmögliche Rechte. Nur den Zugriff geben, der für die Aufgabe nötig ist, und nichts darüber hinaus.
Worauf Sie bei der Auswahl eines Partners für KI-Softwareentwicklung achten sollten
Wer heute ein KI-Softwareentwicklung Unternehmen auswählt, fragt am besten zuerst, wie es die Ergebnisse seiner Agenten prüft, und nicht, welches Modell es nutzt. Ein ernsthaftes Haus für B2B-Softwareentwicklung kann Ihnen getrennte Umgebungen zeigen, einen unabhängigen Prüfschritt, Arbeitsnachweise an den Änderungen, ein Protokoll, einen benannten Menschen für jede Übernahme in den Hauptzweig und eine klare Liste von Fällen, in denen es bewusst keine Agenten einsetzt. Die folgende Liste funktioniert bei uns genauso wie bei allen anderen. Deshalb veröffentlichen wir sie gern.
- Wie prüfen Sie, dass eine Änderung von einem Agenten wirklich funktioniert? Bitten Sie um ein echtes Beispiel aus einem Projekt.
- Wer prüft die Ausgaben der Agenten, und ist der Prüfer unabhängig vom Umsetzer?
- Welchen Zugriff haben Ihre Agenten auf unseren Code und unsere Daten, und wie ist er begrenzt?
- Was wird protokolliert, und wie lange wird es aufbewahrt?
- Wer ist der benannte Mensch für eine Übernahme in unsere Produktivsysteme?
- Wann setzen Sie bewusst keine Agenten ein? Nennen Sie drei konkrete Beispiele.
- Was passiert, wenn ein Agent falsch liegt und der Fehler in den Betrieb gelangt?
Die sechste Frage sagt am meisten. Ein Team, das das im großen Maßstab gefahren hat, hat eine konkrete Liste mit Narben. Ein Team ohne diese Erfahrung gibt Ihnen eine allgemeine Antwort über die Bedeutung von Aufsicht.
Was wir mitbringen: Projekte über den ganzen Lebenszyklus für B2B-Plattformen, ERP- und CRM-Systeme, Anbindungen und stark belastete Dienste. Von Analyse und Nutzererlebnis über Architektur, Entwicklung, DevOps bis zur langfristigen Betreuung, dazu KI-Einbindung und Automatisierung. Dazu gehört auch ganz normale Webentwicklung, nicht nur Projekte mit Agenten. Wir bauen Software seit 2006 und liefern in Deutschland, den Vereinigten Staaten und Osteuropa. Unsere Position ist technische Reife, Planbarkeit und Verlässlichkeit. Wir sind ausdrücklich nicht die billige und schnelle Wahl, und das sagen wir früh. Für den Mittelstand ist das oft genau der Punkt.
Wenn Sie ein anspruchsvolles Projekt für CRM, ERP, ein Portal, eine Anbindung oder KI-Agenten planen, vereinbaren Sie ein Erstgespräch mit Webdelo. Wir gehen Ihren heutigen Prozess durch, zeigen Ihnen, wo Agentenarbeit passt und wo nicht, und geben Ihnen einen konkreten Lieferplan für Deutschland, die Vereinigten Staaten oder Osteuropa.
Fazit: warum der Prozess mehr zählt als der Name des Modells
Die Werkzeuge aus diesem Artikel werden in einem Jahr anders aussehen. Manche wird es nicht mehr geben. Das Argument darunter ändert sich nicht, denn es geht gar nicht wirklich um KI. Es geht darum, wie Arbeit organisiert wird, wenn die Arbeiter ihre Form ändern.
Fünf Dinge, die wir behalten würden, wenn wir den Rest wegwerfen müssten:
- Die Arbeitseinheit ist eine Stufe höher gerückt, von der Datei zur Funktion. Alles andere folgt aus dieser einen Verschiebung.
- Die Belege sind wirklich zweiseitig. 55 % schneller bei klar begrenzter Arbeit, 19 % langsamer bei tiefer Arbeit in gewachsenen Systemen. Ein Anbieter, der Ihnen nur eine dieser Zahlen zeigt, verkauft.
- KI verstärkt das Entwicklungssystem, das Sie schon haben. Ein schwacher Prozess wird ebenfalls verstärkt, und zwar schneller.
- Steuerung, Trennung und Arbeitsnachweise machen Änderungen von Agenten im Unternehmen annehmbar. Ohne sie haben Sie Tempo, das Sie nicht nutzen können.
- Werkzeuge ändern sich ständig. Der Prozess, die Prüfdisziplin und der benannte Verantwortliche überleben die nächste Modellversion.
Wir hängen an keinem der hier genannten Werkzeuge, auch nicht an dem, das wir täglich nutzen. Wir hängen an einer Arbeitsweise, die die Werkzeuge austauschbar macht.
"Wir messen KI nicht an der Menge des erzeugten Codes. Für uns zählt, wie viel geprüfte Arbeit in den Betrieb gelangt, ohne die technischen Altlasten zu vergrößern." - Andrew Popov, CTO und Gründer, Webdelo
Wenn Sie ein anspruchsvolles System bauen, modernisieren oder anbinden wollen, vereinbaren Sie ein Erstgespräch mit unserem Team.
Häufig gestellte Fragen
Was ist eine agentische Entwicklungsumgebung (ADE) und wie unterscheidet sie sich von einer IDE mit KI?
Eine agentische Entwicklungsumgebung ist ein Arbeitsplatz, der mehrere eigenständige Programmieragenten gleichzeitig betreibt und koordiniert. Eine IDE mit KI hilft einer Person beim Bearbeiten einer Datei. Eine agentische Umgebung verwaltet dagegen getrennte Arbeitskopien, gemeinsamen Kontext, Prüfung, Freigabe und fertige Änderungsanträge. Die Arbeitseinheit ist damit nicht mehr eine Datei, sondern eine ganze Funktion oder Geschäftsaufgabe.
Beschleunigen KI-Agenten die Entwicklung von Unternehmenssoftware wirklich?
Das hängt von der Art der Arbeit ab, und die öffentlichen Daten zeigen in zwei Richtungen. In einem kontrollierten Versuch von GitHub mit 95 Entwicklern war die Gruppe mit KI-Assistent bei einer klar abgegrenzten Aufgabe rund 55% schneller. In der METR-Studie von 2025 brauchten 16 erfahrene Entwickler bei 246 echten Aufgaben in vertrautem Code rund 19% länger. Klar abgegrenzte und prüfbare Arbeit wird meist schneller, tiefe Eingriffe in ein gewachsenes System, das ein Team gut kennt, oft nicht.
Wie weisen Sie nach, dass von KI-Agenten geschriebener Code wirklich funktioniert?
Eine Änderung gilt bei uns erst als fertig, wenn ein Agent die laufende Anwendung in einem echten Browser bedient hat und der Anwendungsfall wirklich funktioniert. Der Agent öffnet die Seite, klickt den Ablauf durch, liest den Seitenaufbau, macht Bildschirmfotos und hängt diese Belege an die Änderung. Tests allein reichen nicht, weil Tests oft aus demselben Missverständnis heraus entstehen wie der Code. Freigegeben wird jede Zusammenführung weiterhin von einem namentlich benannten Menschen.
Ist es sicher, KI-Agenten an Unternehmenssystemen und Kundendaten arbeiten zu lassen?
Sicher ist es dann, wenn ein Agent wie jede andere Software behandelt wird, die Zugangsdaten besitzt und handeln kann. Das bedeutet kleinstmögliche Rechte, getrennte Zugangsdaten, eine eingeschränkte Auswahl an Werkzeugen, Protokolle, Freigabepunkte und einen klaren Weg zur Eskalation an einen Menschen. Die Arbeit von OWASP zur Steuerung von Agenten sagt dasselbe: das Verhalten eines Agenten muss zur Laufzeit beobachtbar, nachvollziehbar und steuerbar sein. Ein Agent, der an der Oberfläche arbeitet, braucht niemals Zugang zur Produktionsdatenbank.
Wann sollte man KI-Agenten in einem Projekt besser nicht einsetzen?
Wir verzichten bewusst auf Orchestrierung, wenn die Aufgabe klein ist, wenn der Code dem Menschen sehr vertraut und dem Agenten fremd ist, wenn sich Abnahmekriterien nicht aufschreiben lassen oder wenn die Abstimmung mehr kostet als die Arbeit selbst. Bei einer Aufgabe von zwei Stunden ist das Aufsetzen von drei Agenten teurer als die Arbeit. Jeder zusätzliche Agent bringt mehr Konflikte beim Zusammenführen, höhere Kosten und mehr Prüfaufwand. Fragen Sie jeden Anbieter nach seiner Liste der Fälle, in denen er Agenten nicht einsetzt.
Was sollte ich ein Unternehmen für KI-Softwareentwicklung vor Vertragsabschluss fragen?
Fragen Sie, wie die Ergebnisse der Agenten geprüft werden, nicht welches Modell zum Einsatz kommt. Ein ernsthafter Partner zeigt getrennte Umgebungen, eine unabhängige Prüfung durch ein Modell einer anderen Familie, Arbeitsnachweise an jeder Änderung, ein Protokoll, einen namentlich benannten Verantwortlichen für jede Zusammenführung und eine Liste von Fällen, in denen er bewusst keine Agenten nutzt. Der letzte Punkt sagt am meisten aus, denn eine konkrete Liste hat nur ein Team mit echter Projekterfahrung. Namen von Modellen wechseln alle paar Monate, gekauft wird der Entwicklungsprozess.
Ersetzen KI-Agenten Entwickler, und wer trägt die Verantwortung für das Ergebnis?
Nein. Agenten übernehmen die Routine der Umsetzung, während Menschen die Architektur entscheiden, Abnahmekriterien festlegen und die Verantwortung tragen. In unserem Prozess bestimmt ein Mensch die Geschäftsaufgabe, nimmt die Architekturentscheidung an und gibt die letzte Prüfung frei. Agenten dürfen nichts eigenständig in den Hauptzweig übernehmen. Geht in der Produktion etwas schief, verantwortet das eine benannte Person und nicht ein Modell.
