


Wo unsere Geschichte der KI-Workflow-Optimierung beginnt
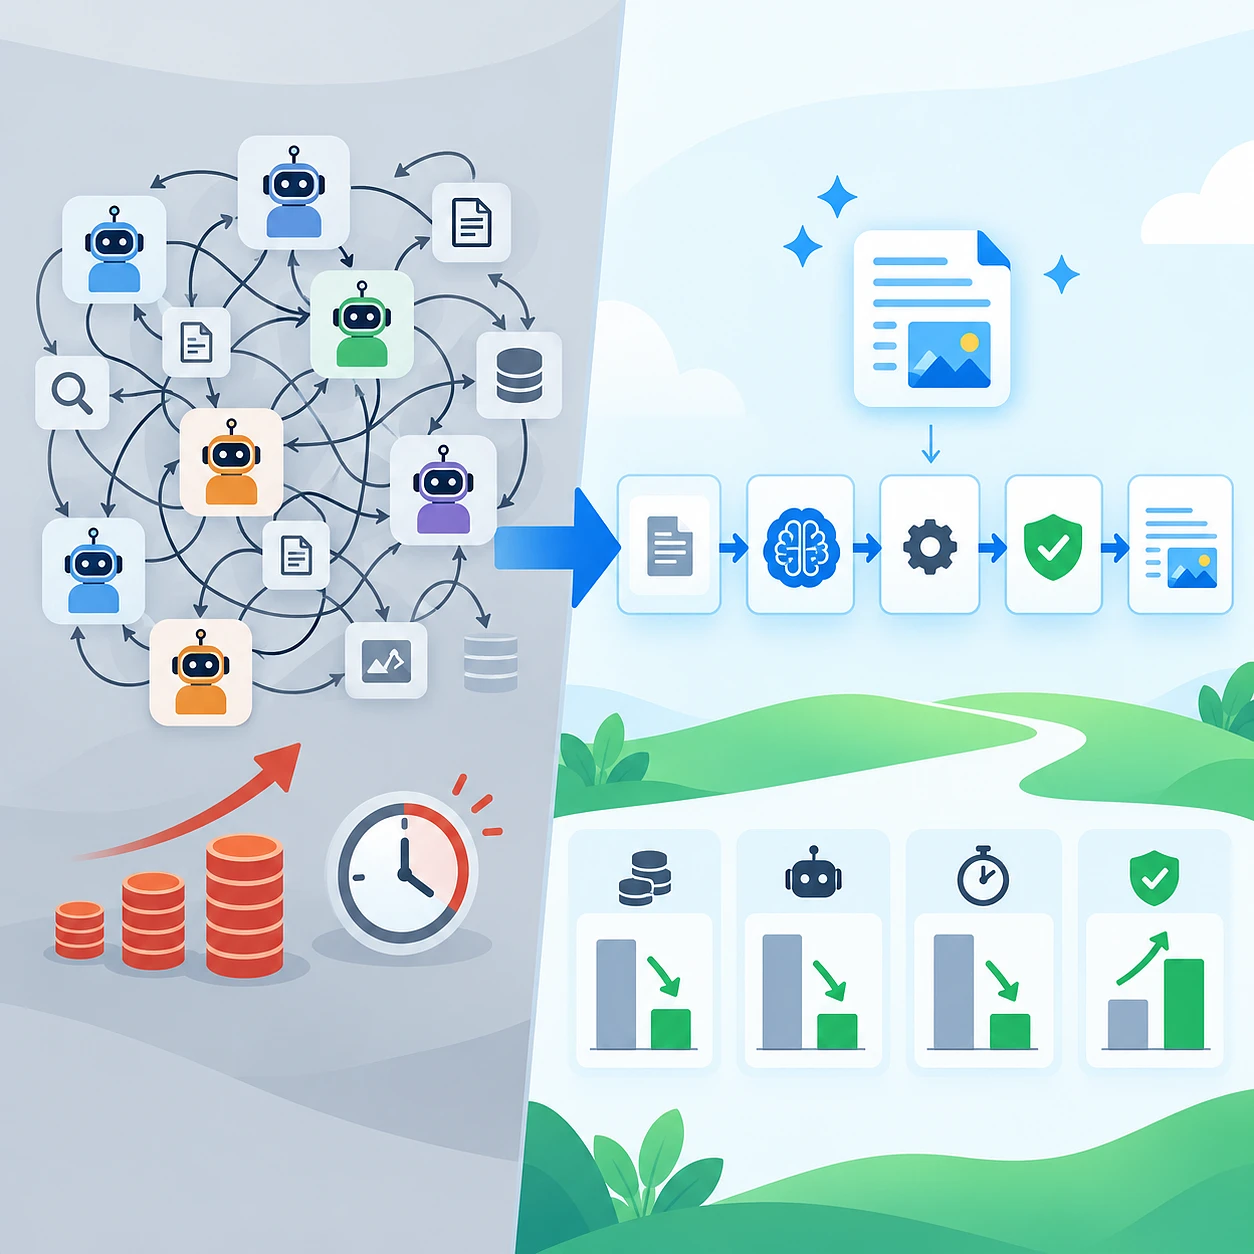
Dies ist ein echter Fall von KI-Workflow-Optimierung aus unserer eigenen Content-Plattform. Es handelt sich nicht um eine Zusammenfassung fremder Quellen. Im Agentenmodus brauchte die Plattform im Median 197 Modellaufrufe und 34,2 Minuten pro Artikel. Wir haben die Routinearbeit in deterministischen Code verlagert und das Modell nur dort eingesetzt, wo Bedeutung gefragt ist. Danach benötigten drei identische reale Briefings 13, 10 und 6 Modellaufrufe. Die Gesamtkosten sanken von 95,32 $ auf 35,13 $ Äquivalent (2,71-mal niedriger) und die Gesamtzeit von 94,2 auf 36,8 Minuten (2,56-mal schneller). Rechnet man die Wiederholungsläufe ein, die der Agentenmodus tatsächlich brauchte, erreichte der Abstand das 4,86-Fache bei den Kosten und das 4,40-Fache bei der Zeit.
Ein Hinweis vor den Details: Alle Dollarbeträge sind Äquivalente, die anhand öffentlicher Modellpreise berechnet wurden. Es handelt sich nicht um Rechnungsbeträge. Das Projekt läuft über ein Abonnement, die tatsächliche Einsparung liegt also bei Nutzungslimits und Kapazität. Wir verwenden das Dollaräquivalent, weil sich damit am klarsten vergleichen lässt, wie viele Ressourcen jeder Ansatz verbraucht.
Die Arbeit hat auch unser Verständnis von Qualität verändert. Dieselben Code-Prüfungen, die die Pipeline günstiger machten, fanden Fehler in bereits veröffentlichten Artikeln: fehlende Links, doppelte Links und einen Link auf die Domain der falschen Sprache. Das Agenten-Setup hatte all das durchgelassen.
Wir haben diesen Beitrag für Inhaber, Geschäftsführer, COOs sowie Produkt- und Operations-Verantwortliche in B2B-Unternehmen des Mittelstands geschrieben, die KI-Automatisierung für echte Geschäftsprozesse abwägen. Tiefes technisches Wissen ist nicht nötig, um ihm zu folgen. Das erwartet Sie:
- das Geschäftsproblem und was wir zuerst gemessen haben;
- warum mehr Agenten die Lage verschlechtert hätten;
- die Architektur, auf die wir umgestiegen sind, und ein Vorher-Nachher-Vergleich;
- Benchmark-Ergebnisse, Zuverlässigkeitsgewinne und gefundene Fehler;
- was das für ERP, CRM und andere KI-Projekte in Unternehmen bedeutet;
- die ehrlichen Grenzen des Falls und was wir als Nächstes testen wollen.
Das Geschäftsproblem: KI funktionierte, war aber zu teuer
Unser System erfüllte seine Aufgabe bereits: Es machte aus einem Briefing einen veröffentlichten mehrsprachigen Artikel im CMS. Jeder Durchlauf erforderte jedoch Hunderte Modellaufrufe und mehr als eine halbe Stunde. Die Qualität der Ergebnisse war akzeptabel. Schwierig waren die Wirtschaftlichkeit und die zunehmende Unberechenbarkeit des Prozesses, und beides würde sich mit wachsendem Volumen verschärfen.
Vereinfacht gesagt nimmt die Plattform ein Briefing entgegen und führt es durch eine Kette von Schritten. Sie sammelt Kontext und Recherche mit Autoritätsstufen für Quellen, erstellt eine Struktur, schreibt den Haupttext, übersetzt ihn, fügt interne Links ein, bereitet Metadaten, FAQ und Medien vor und veröffentlicht im CMS. Die Artikel unterstützen unsere Arbeit in den Bereichen Google SEO und GEO SEO, deshalb müssen sie in jeder Sprache korrekt sein. Keinen dieser Geschäftsschritte haben wir bei der Optimierung verändert. Wir haben nur geändert, wer den jeweiligen Schritt ausführt.
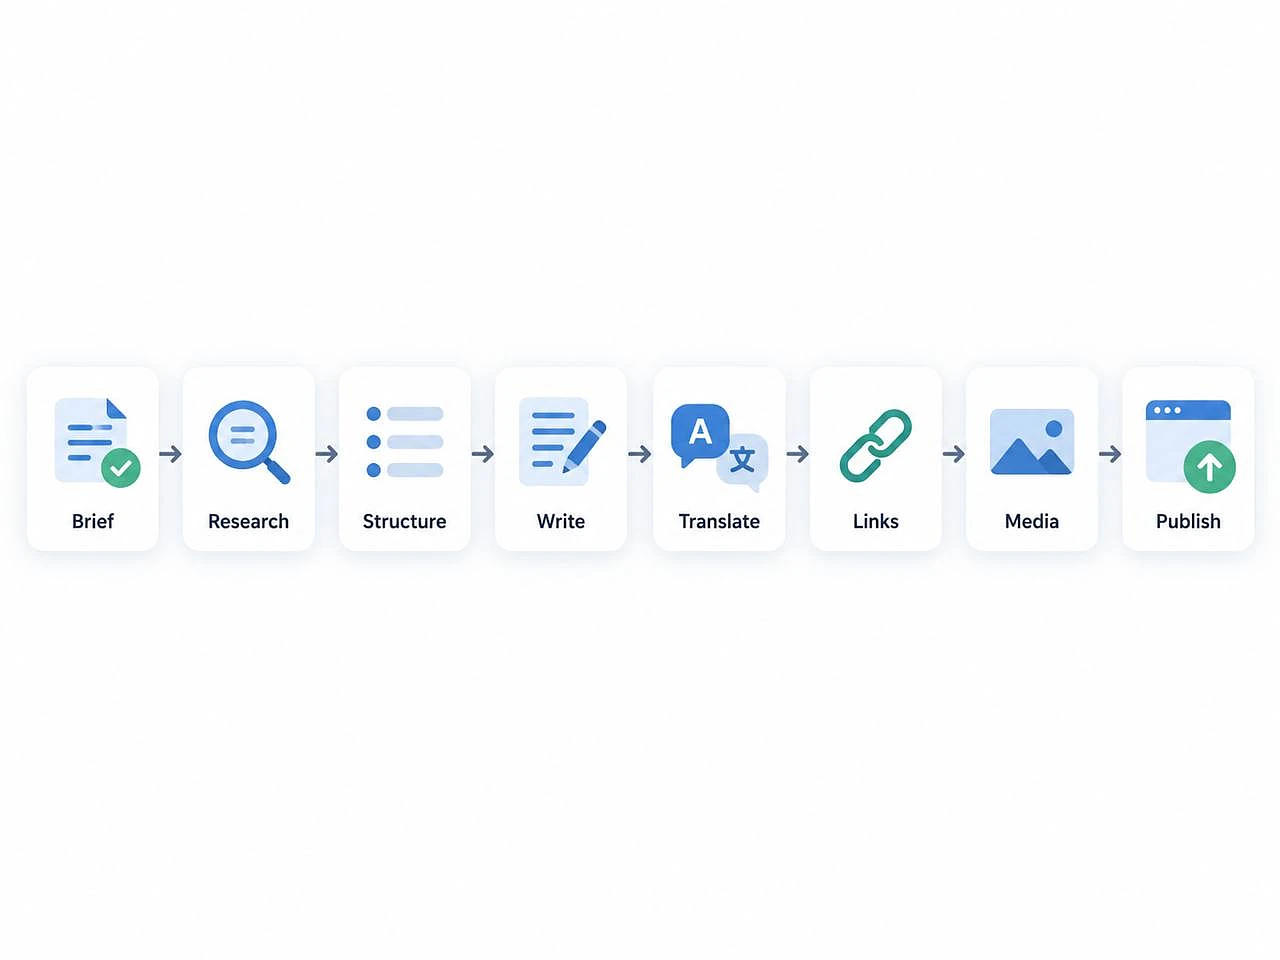
Das alte Setup war ein Multi-Agenten-System auf Basis von Claude Code. Ein Orchestrator-Modell startete mehr als zehn Subagenten, einen pro Phase. Jeder Subagent erhielt Dateipfade statt der Daten selbst. Er musste diese Dateien lesen, herausfinden, wie API-Anfragen signiert werden, temporäre Skripte schreiben, Text in kleinen Stücken bearbeiten und seinen Status selbst zurückmelden.
Wir haben 11 vollständige Durchläufe im Agentenmodus gemessen. Die Medianwerte lagen bei 42,49 $ Äquivalent pro Artikel, mit einer Spanne von 20,87 $ bis 66,39 $. Der Median-Durchlauf machte 234 Tool-Aufrufe. Eine dreifache Spreizung zwischen dem günstigsten und dem teuersten Artikel lässt sich schwer planen, selbst wenn der Durchschnitt erträglich wirkt.
Für ein Unternehmen ist das das bekannte Risiko der KI-Workflow-Automatisierung. Die Kosten pro Einheit sind unvorhersehbar, Wiederholungsläufe treiben sie unbemerkt nach oben, und jede zusätzliche Sprache oder optionale Phase vervielfacht die Ausgaben. Wer die Kosten von KI-Agenten senken will, stößt früher oder später auf diese Hürde. Jedes Unternehmen, das einen echten Prozess automatisiert, von der Auftragsabwicklung bis zum Kundensupport, erreicht diesen Punkt, sobald aus dem Pilotprojekt Tagesgeschäft wird.
Was wir gemessen haben und was uns überrascht hat
Die Kosten entstanden nicht beim Schreiben. Sie entstanden, weil die Agenten ihren Kontext immer wieder neu lasen: im Durchschnitt 12,7 Millionen Cache-Read-Tokens gegenüber 202.000 Output-Tokens, also etwa 63 gelesene Tokens pro geschriebenem Token. Das teure Modell, das wir im Verdacht hatten, lief während der Generierung nicht einmal.
Ausgangspunkt war eine einfache Frage unseres Product Owners, die wir durch eine zeilenweise Analyse der Sitzungsprotokolle beantwortet haben. Hätten wir geraten, hätten wir die Modelle getauscht, und das hätte nichts gelöst.
63 gelesene Tokens pro geschriebenem Token
Ein durchschnittlicher Agentendurchlauf verbrauchte 12.734.402 Cache-Read-Tokens, 833.199 Cache-Write-Tokens, 202.319 Output-Tokens und nur 375 neue Input-Tokens. Einfach ausgedrückt: Das Modell bezahlte ständig dafür, dieselben Dokumente erneut zu lesen, statt nützlichen Text zu erzeugen.
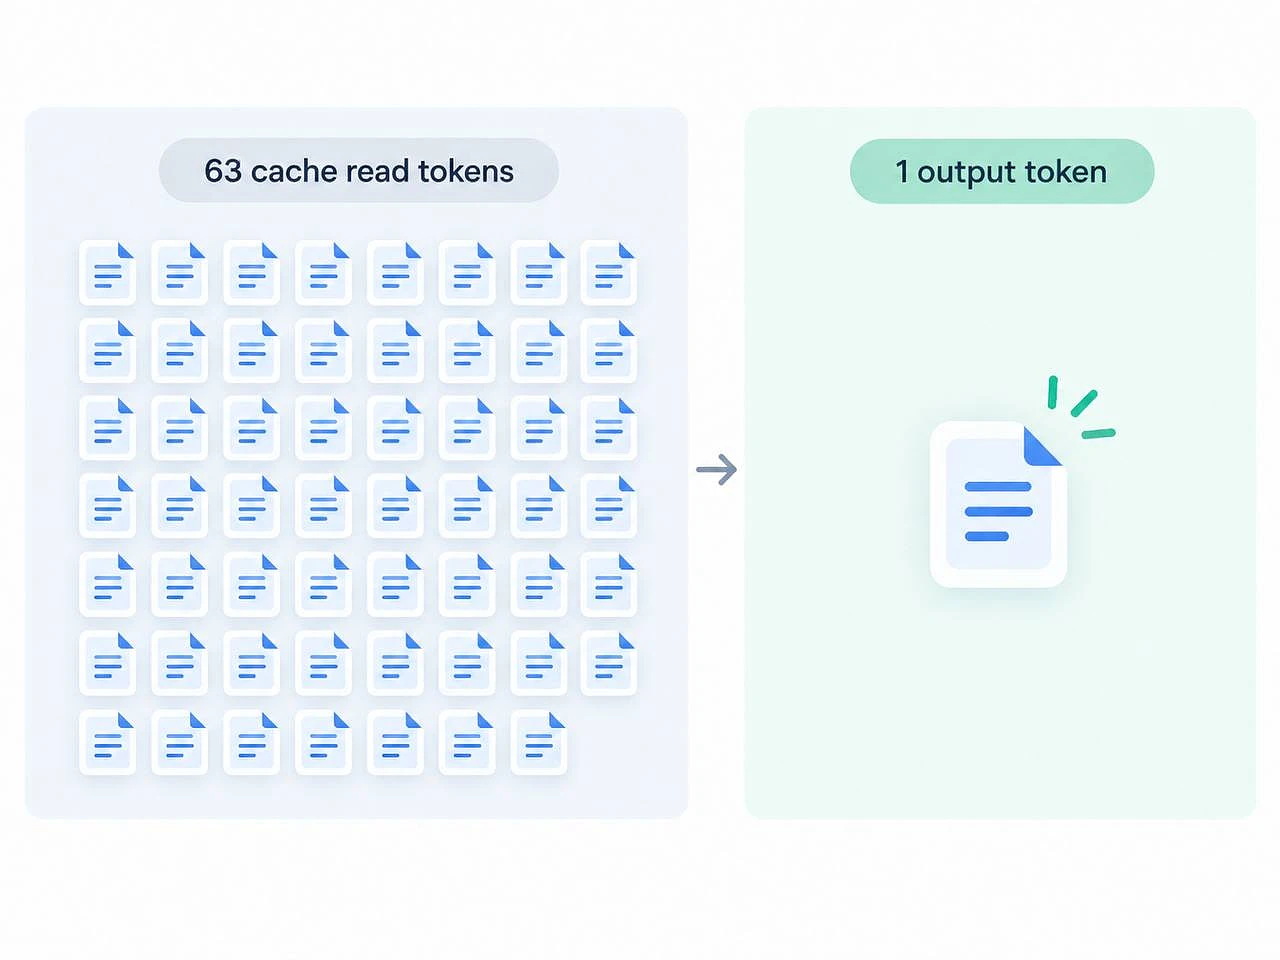
Ein Orchestrator-Durchlauf zeigt, wie das passiert. Er machte 71 Modellaufrufe in 22 Minuten, und 21 davon waren kurze Meldungen ohne Aktion wie "reading the brief". Sein Kontext wuchs von 17.000 auf 91.000 Tokens, und bei jedem Aufruf wurde alles erneut gelesen. Das Verhältnis von 63:1 ist ein Durchschnittswert aus unserem System und sollte nicht als allgemeingültiges Verhältnis für Sprachmodelle verstanden werden.
Das teure Modell war nie das Problem
Der Product Owner fragte, ob man ein teures Modell auf dem Orchestrator behalten solle, weil die Generierung nach dessen Aktivierung "keine Schritte mehr verlor". Die Protokolle lieferten eine überraschende Antwort. Ein Backend-Flag überschrieb die Agenteneinstellungen, und alle 106 Generierungssitzungen nutzten Sonnet.
Die Stabilität kam von korrigierten Anweisungen und einer maschinellen Prüfung am Ende des Durchlaufs, die wir Preflight-Gate nennen. Die Modellwahl spielte keine Rolle. Der Orchestrator verursachte außerdem 23,5 % der Modellaufrufe, aber nur 4,7 % der Kosten, war also nie die richtige Stelle zum Sparen.
Eine Messfalle, die unsere Kosten verdoppelte
Unsere ersten Zahlen lagen etwa um den Faktor zwei daneben. Eine Modellantwort wird im Protokoll als mehrere Zeilen gespeichert (Text, Reasoning, jeder Tool-Aufruf), und jede Zeile wiederholt dieselben Nutzungsdaten. Das Aufsummieren der Zeilen ergab 95,43 $ für einen Durchlauf, das Zählen eindeutiger Antworten dagegen 48,37 $.
Wir haben die Methode korrigiert, indem wir anhand der Antwort-ID dedupliziert haben. Die relativen Ergebnisse blieben bestehen, die absoluten Zahlen änderten sich jedoch. Die Lehre für das Geschäft ist einfach: Prüfen Sie, wie eine Zahl berechnet wird, bevor Sie Entscheidungen darauf stützen.
Warum mehr Agenten nicht die Lösung waren
Mehr Agenten oder ein stärkeres Modell hätten dieselben Fehler nur teurer gemacht. Die Agenten scheiterten nicht an schwierigen Aufgaben. Sie kämpften mit der Umgebung: API-Aufrufe signieren, Dateien finden, Antworten parsen und Links einzeln einfügen.
Wir widersprechen der verbreiteten Vorstellung, dass mehr Autonomie bessere Automatisierung bedeutet. Wer KI-Agenten optimieren will, sollte wissen: Unsere Daten zeigen bei klar definierten Prozessen das Gegenteil. Der Interlinker ist ein deutliches Beispiel. Das Backend hatte Seiten, Anker und Relevanzwerte bereits ausgewählt, das Modell musste die Links nur in Absätze einbauen. Das ist eine Aufgabe für einen einzigen Aufruf. Es wurden bis zu 91 Aufrufe daraus, 26 davon fügten pro Bearbeitung einen einzigen Link ein, und über 24 Durchläufe schwankte die Zahl zwischen 3 und 91.
Umgebungsfehler statt schwieriger Aufgaben
Wir haben 69 Tool-Fehler in 10 Durchläufen gezählt, etwa sieben pro Generierung. Fehler traten in 27 von 30 Durchläufen auf, und das abschließende Skript musste in 11 von 30 Fällen erneut ausgeführt werden. Die Ursachen hatten nichts mit der Schwierigkeit der Aufgabe zu tun:
- zwischen Shell-Aufrufen verlorene Umgebungsvariablen: 13;
- Fehler des abschließenden Skripts: 13;
- Parsen von Antworten: 7;
- fehlende Dateien unter erwarteten Pfaden: 7;
- Bearbeitungen, deren Zielstring nicht gefunden wurde: 6;
- durch einen Security-Hook blockierte Netzwerkaufrufe: 6;
- im Subagenten nicht verfügbares Tool: 4.
Der Interlinker signierte Anfragen zudem mit einem veralteten Verfahren und erhielt 401-Fehler, während seine Anweisungen auf ein Signaturmodul verwiesen, das es nicht gab.
Erfundene Daten und abweichende Formate
Ein Teil der "Daten" der Agenten war erfunden. In 92 Durchläufen des Keyword-Subagenten erhielt kein einziger echte Google-Daten: Das Paket fehlte, und das Token war ungültig. Das Modell dachte sich Keywords aus und markierte sie als "manual".
Die Wettbewerbsanalyse wurde von Hand erledigt, obwohl es dafür bereits Skripte gab. Die Datei keywords.json existierte in vier inkompatiblen Formaten, und drei Signaturverfahren waren gleichzeitig im Einsatz. Für ein Unternehmen ist das der gefährlichste Befund: Ein Agent kann defekte Integrationen hinter Ergebnissen verbergen, die glaubwürdig aussehen.
Was wir an der KI-Workflow-Architektur geändert haben
Wir haben das Netz aus Agenten durch eine deterministische Pipeline ersetzt. Code sammelt Daten, erstellt Prompts, schreibt Dateien, führt Prüfungen aus und steuert die Arbeit. Das Modell führt pro Phase eine gezielte LLM-Inferenz aus, ohne Tools und mit vollständig vorbereitetem Kontext, und sein Ergebnis wird validiert, bevor der nächste Schritt beginnt.
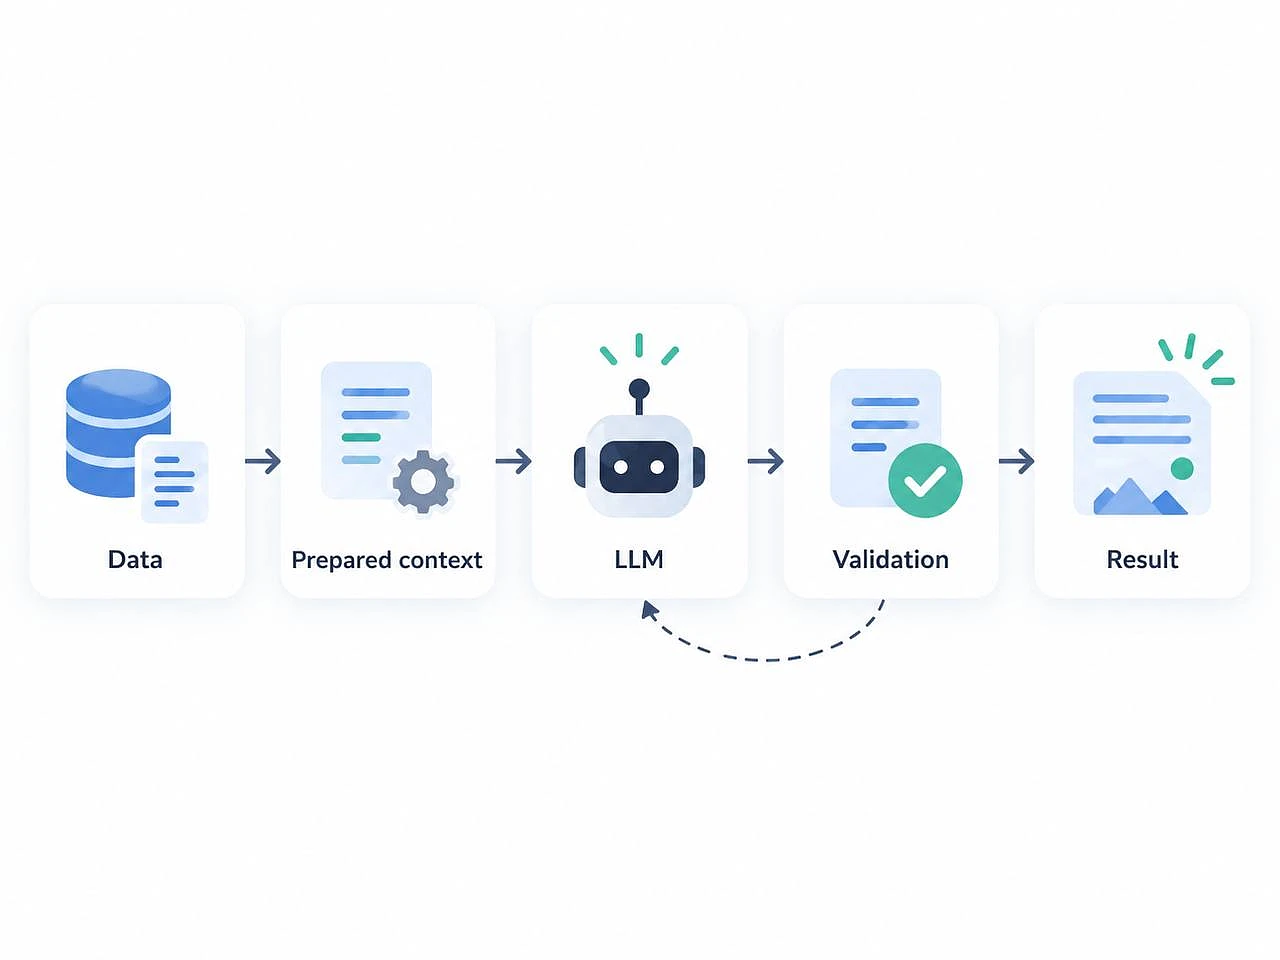
Für nichttechnische Leser lässt sich das Prinzip als gerade Linie lesen: Daten -> Vorbereiteter Kontext -> LLM -> Validierung -> Ergebnis. Das gesamte Projekt, von Analyse und Umsetzung über Benchmark und Korrekturen bis zur Umstellung der Produktion, dauerte einen Arbeitstag. Es entstanden 144 Commits und 652 automatisierte Tests, und alle Live-Modellläufe kosteten zusammen etwa 82 $ Äquivalent, weniger als zwei Agentengenerierungen eines langen Artikels.
Das Modell übernimmt nur, was Bedeutung erfordert
In der neuen Pipeline verbraucht das Modell Tokens nur für Schreiben, Übersetzen und inhaltliche Synthese. Alles rund um diese Arbeit erledigt Code. Skripte setzen den tatsächlichen Inhalt in Prompt-Vorlagen ein, sodass das Modell keine Dateipfade mehr erhält und nicht mehr nach seinen Eingaben suchen muss.
Wir haben auch bereinigt, was jeder Aufruf mitführt. Nachdem wir Tools, Hooks, Plugins und MCP abgeschaltet und einen eigenen System-Prompt gesetzt hatten, sank der Overhead pro Modellaufruf von etwa 9.000 Input-Tokens auf etwa 537, beziehungsweise etwa 950, wenn ein JSON-Schema angehängt ist. Diese Einsparung zählt, weil sie sich bei jedem Aufruf wiederholt.
Verträge, Validatoren und Wiederholungen mit Feedback
Ein Artefaktvertrag legt Dateinamen und JSON-Schemas fest und prüft sie bei jedem Schreiben und Lesen, sodass Formate nicht mehr auseinanderlaufen können. Nach jeder Modellphase läuft ein Validator. Schlägt er fehl, enthält die Wiederholung den Validatorbericht, und das Modell weiß genau, was zu korrigieren ist.
Sprachen stammen ausschließlich aus dem Briefing, ohne fest codierte Listen, und die Produktion wird erst nach einem Benchmark mit denselben Briefings umgestellt. Der Rollback ist ein Konfigurationswert: generation.mode wird auf agent oder script gesetzt, und das Umschalten erfordert nur einen Wert und einen Neustart des Workers. Beide Modi schreiben dieselben Artefakte, sodass ein in einem Modus generierter Artikel im anderen korrigiert werden kann.
Ein gemeinsamer Linkplan für alle Sprachen
Autor, Übersetzer und Prüfung nutzen einen einzigen Verlinkungsplan. Einfacher Code prüft, ob jeder Link vorhanden, doppelt, erfunden oder auf die Domain einer anderen Sprache gerichtet ist. Das Modell wird nur aufgerufen, wenn etwas nicht stimmt, und erhält dann eine Liste der Abweichungen statt der gesamten Aufgabe.
Vorher und nachher: Wie sich der Workflow verändert hat
Vorher interagierten viele Agenten in Schleifen mit Dateien, Daten, Suche, Code und Einstellungen. Nachher ist der Workflow eine gerade Linie: Daten vorbereiten, generieren, validieren, fertigen Artikel veröffentlichen. Die Geschäftsschritte blieben gleich. Geändert hat sich, wer den jeweiligen Schritt ausführt: Code oder das Modell.
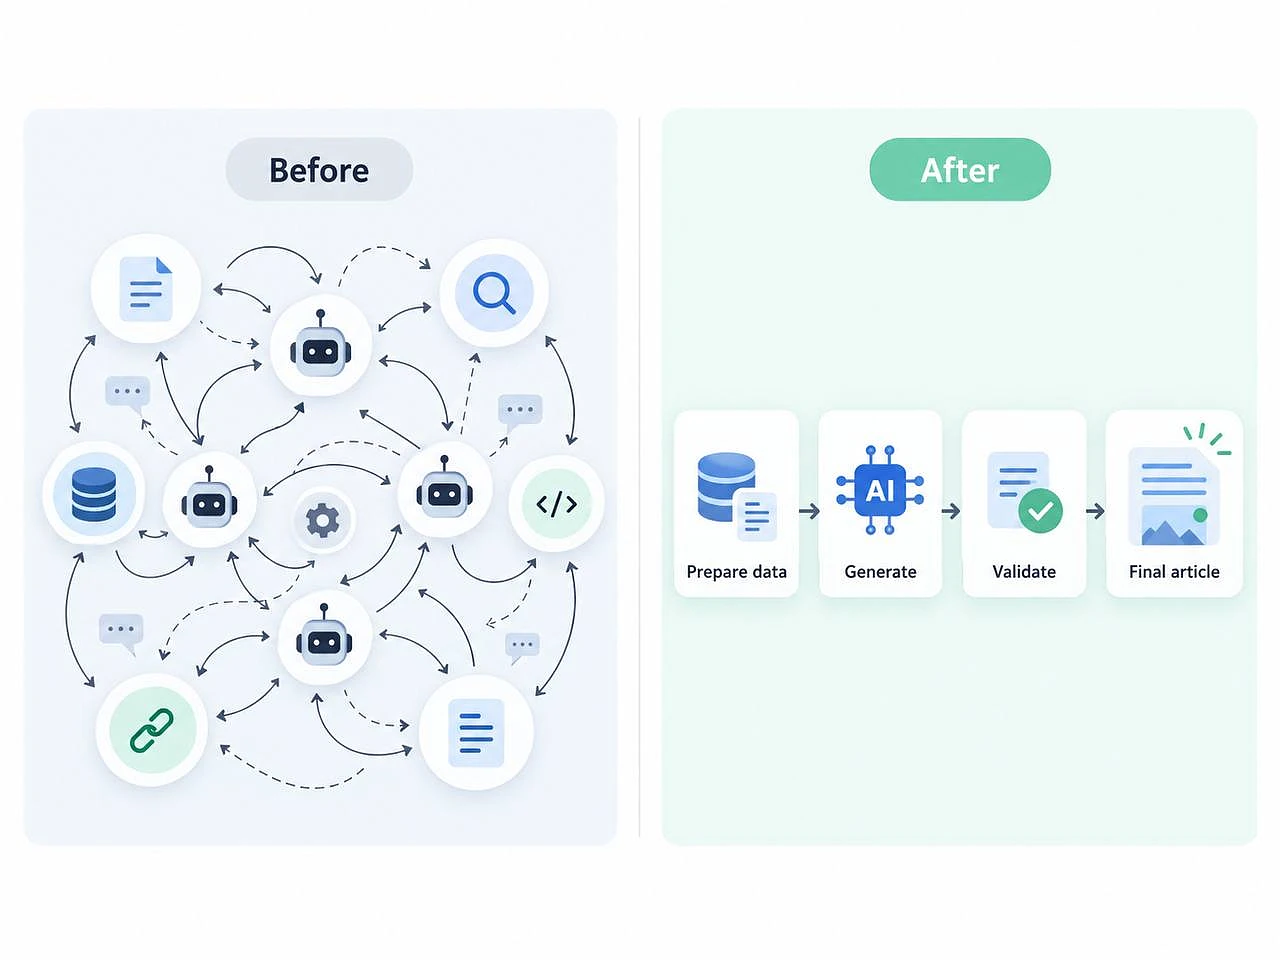
Die folgende Tabelle vergleicht beide Modi anhand der drei Benchmark-Briefings. Die Zahlen zu Tool-Aufrufen im Agentenmodus enthalten die zusätzlichen Sitzungen, die die Briefings A und B tatsächlich benötigten.
| Aspekt | Agentenmodus (vorher) | Skript-Pipeline (nachher) |
|---|---|---|
| Wer Daten sammelt | Subagenten lesen Dateien, rufen APIs auf und schreiben temporäre Skripte | Deterministischer Code |
| Wie Kontext übergeben wird | Dateipfade, die das Modell öffnen und erneut lesen muss | Tatsächlicher Inhalt in Prompt-Vorlagen |
| Tool-Aufrufe pro Artikel (A/B/C) | 709 / 184 / 130 | 0 / 0 / 0 |
| Cache-Reads pro Artikel | 6-12 Millionen Tokens | 3-31 Tausend Tokens |
| Wie Fehler behandelt werden | Agent improvisiert, führt das abschließende Skript erneut aus, startet Worker neu | Validatorbericht, begrenzte Wiederholungen, klare Abbruchgründe |
| Wie Links eingefügt werden | Separater Interlinker-Agent, oft ein Link pro Bearbeitung | Autor folgt einem gemeinsamen Plan; Code prüft das Ergebnis |
Die Output-Tokens, also der nützliche Text, veränderten sich deutlich weniger als die Cache-Reads. Das bestätigt, wo die Verschwendung lag: bei Navigation und erneutem Lesen, während das eigentliche Schreiben ungefähr gleich umfangreich blieb.
Der Interlinker macht den Unterschied greifbar. Im Agentenmodus kostete er durchschnittlich 4,52 $ pro Durchlauf. Im Skriptmodus kostete er bei allen drei Briefings 0 $, weil der Autor jeden geplanten Link einfügte und die Code-Prüfung bestanden wurde, ohne das Modell überhaupt aufzurufen.
Eine Ausnahme haben wir bewusst gemacht. Korrekturen, die aus dem CMS angefordert werden, bleiben im Agentenmodus. Wenn eine Redakteurin einen Begriff im gesamten Artikel ändern möchte, muss der Skriptweg den vollständigen Text zurückgeben, und das kostet etwa so viel wie eine Übersetzung. Die punktgenauen Bearbeitungen des Agenten sind hier vergleichbar oder günstiger, also haben wir das Werkzeug behalten, das zur Aufgabe passt.
Ergebnisse bei denselben realen Workloads
Bei drei realen Produktions-Briefings kostete die Skript-Pipeline 35,13 $ Äquivalent statt 95,32 $ (2,71-mal weniger) und dauerte 36,8 statt 94,2 Minuten (2,56-mal schneller). Die Modellaufrufe sanken von 197/163/117 auf 13/10/6. Rechnet man die Wiederholungsläufe ein, die der Agentenmodus tatsächlich brauchte, erreichte der Abstand das 4,86-Fache bei den Kosten und das 4,40-Fache bei der Zeit.
Wir haben Briefings mit unterschiedlichen Konfigurationen ausgewählt. Briefing A umfasste en/de/ru, sehr ausführlich, mit allen optionalen Phasen. Briefing B umfasste ru/en/de, lang, nur mit Keywords. Briefing C umfasste en/ru, mittlere Länge, ohne optionale Phasen. Die Agentendaten stammen aus vorhandenen Produktionsprotokollen. Die Skriptdurchläufe liefen über ein Replay-Backend, das aus der Produktion liest, aber nichts dorthin schreibt, und beide Modi nutzten dieselbe Preistabelle. A, B und C bleiben anonymisiert.
Kosten: von 95,32 $ auf 35,13 $ Äquivalent
Pro Briefing, verglichen wurde der Median-Durchlauf der Agenten mit dem Skriptdurchlauf, ergaben sich folgende Werte:
- Briefing A: 44,49 $ gegenüber 18,77 $;
- Briefing B: 29,96 $ gegenüber 12,11 $;
- Briefing C: 20,87 $ gegenüber 4,25 $.
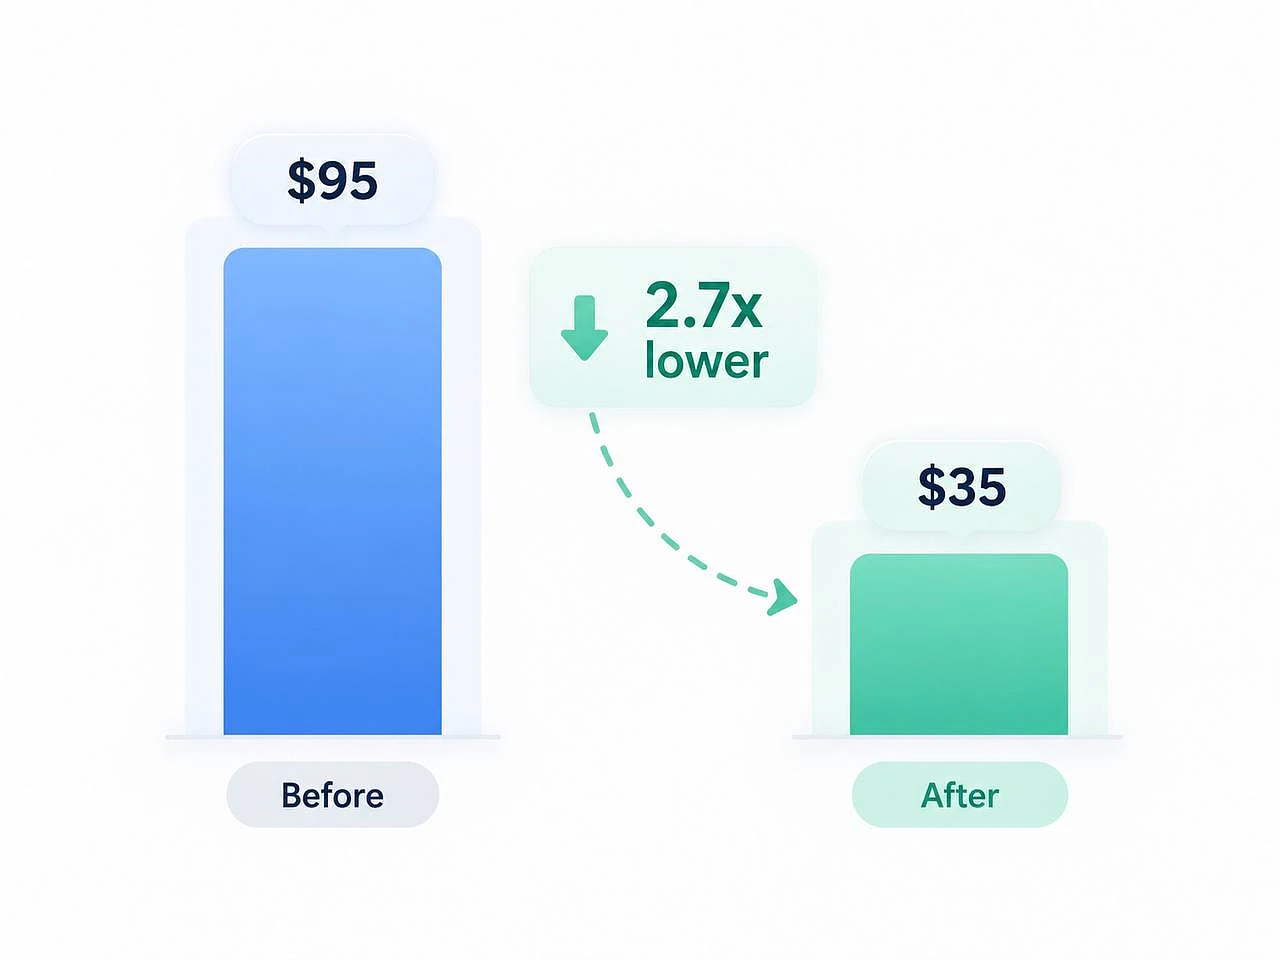
Es handelt sich um Äquivalente auf Basis öffentlicher Modellpreise, während das Projekt über ein Abonnement läuft. Sie messen den Ressourcenverbrauch und sollten nicht als tatsächliche Rechnung gelesen werden. Validierungswiederholungen machten etwa 29 % der Skriptkosten aus, also 10,3 $. Ohne sie schätzen wir etwa 24,9 $ für die drei Briefings, doch das ist eine Schätzung und wurde nicht separat gemessen.
Zeit: von 94,2 auf 36,8 Minuten
Die Zeit sank bei jedem Briefing, mit dem größten relativen Gewinn beim einfachsten:
- Briefing A: 38,2 gegenüber 19,1 Minuten;
- Briefing B: 34,2 gegenüber 13,1 Minuten;
- Briefing C: 21,8 gegenüber 4,6 Minuten.
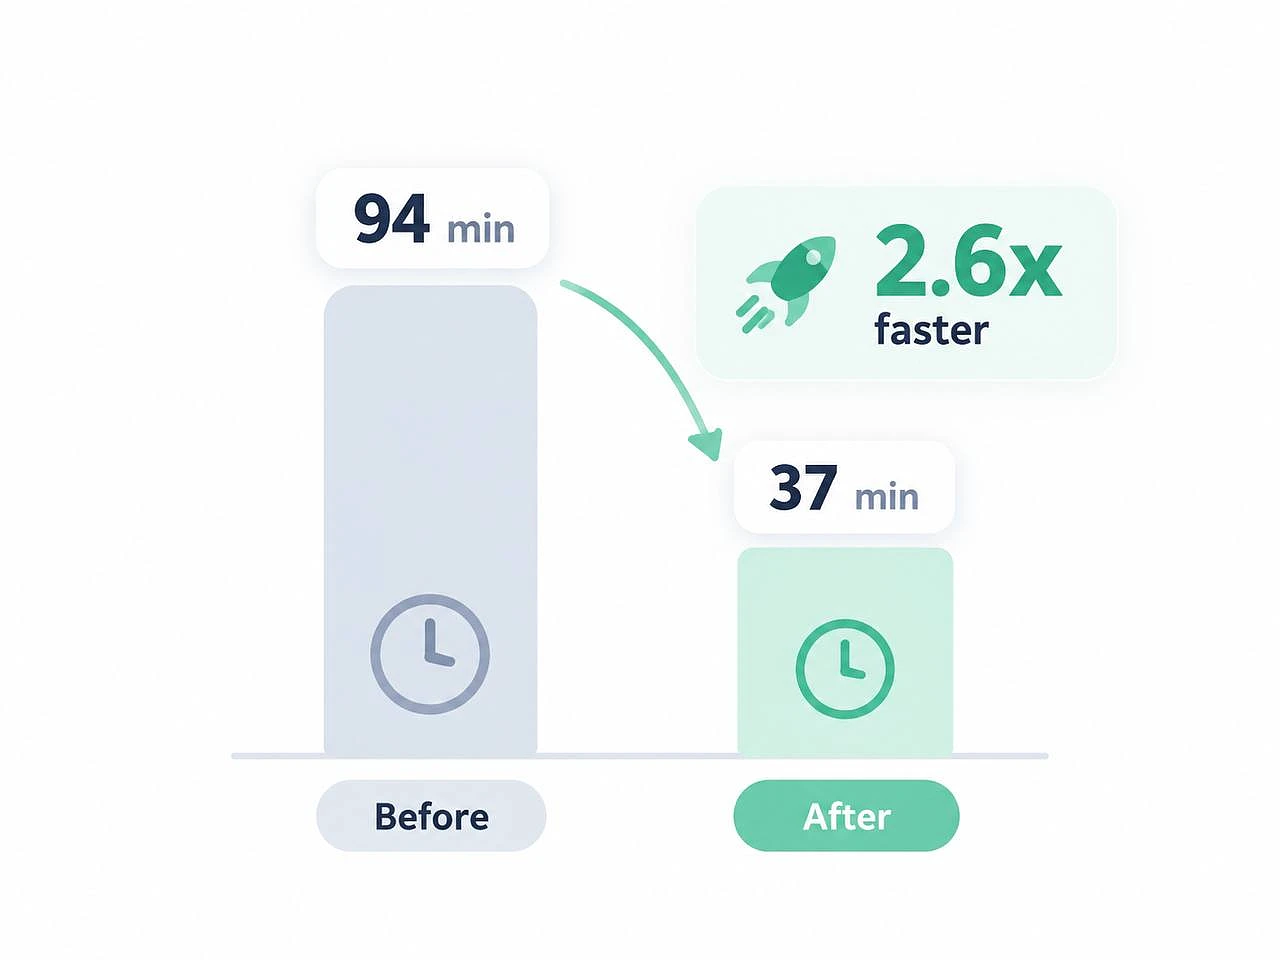
Das Diagramm rundet die gemessenen Gesamtwerte auf 94 und 37 Minuten. Der Faktor 2,6 beschreibt unsere Pipeline bei diesen Briefings, und wir würden ihn nicht als allgemeingültige Beschleunigung für KI-Projekte darstellen. Ihr Gewinn hängt davon ab, wie viel Routinearbeit Ihr aktuelles Setup dem Modell überlässt.
Modellaufrufe und Wiederholungsläufe, die niemand einplant
Die Zahl der Modellaufrufe pro Briefing sank von 197/163/117 im Agentenmodus auf 13/10/6 im Skriptmodus. Weniger Aufrufe bedeuten weniger erneutes Lesen, weniger Stellen für Umgebungsfehler und einen kürzeren Weg zum fertigen Artikel.
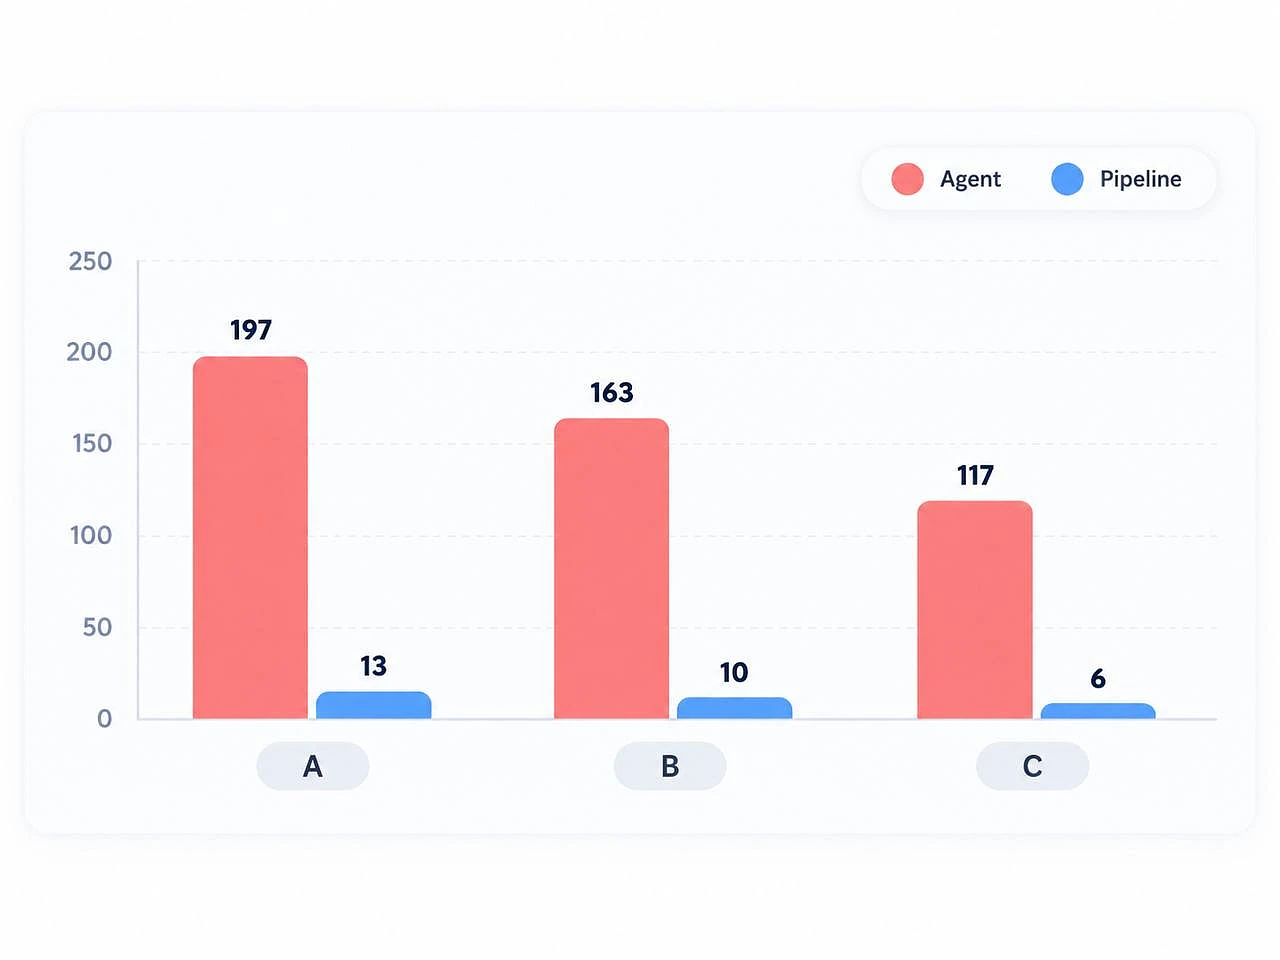
Median-Durchläufe verbergen den Teil, der Budgets am meisten belastet. Briefing A benötigte tatsächlich drei Agentensitzungen bis zum Abschluss: 119,23 $, 105,2 Minuten und 593 Modellaufrufe. Unser bester Fall, Briefing C, war im Skriptmodus 4,91-mal günstiger und 4,72-mal schneller.
Der letzte Schritt zeigt dasselbe Bild. Der Agentenmodus brauchte bei Briefing A 8 Skriptwiederholungen plus 2 Worker-Neustarts, bei Briefing B 10 Wiederholungen und bei Briefing C eine. Der Skriptmodus brauchte keine. Jede Wiederholung kostet außerdem Aufmerksamkeit: Jemand muss den Fehler bemerken, den Job neu starten und das Ergebnis erneut prüfen.
Wenn Sie ein Budget für einen KI-Prozess planen, beziehen Sie die Wiederholungsläufe ein. Ein Plan, der auf dem reibungslosen Idealdurchlauf basiert, sieht im Pilotprojekt gut aus und verfehlt die tatsächlichen Kosten im Betrieb.
Zuverlässigkeit stieg zusammen mit sinkenden Kosten
Die günstigere Pipeline erwies sich auch als zuverlässiger. Alle Skriptversionen bestanden die abschließende Prüfung vor der Veröffentlichung und enthielten 100 % der geplanten internen Links. Deterministische Prüfungen fanden außerdem Fehler, die das Agenten-Setup in bereits veröffentlichte Artikel durchgelassen hatte.
Kosten und Zuverlässigkeit standen hier nicht im Widerspruch. Beide verbesserten sich aus demselben Grund: Die Routinearbeit hing nicht mehr vom Modell ab und damit auch nicht mehr von dessen Improvisation.
In bereits veröffentlichten Artikeln gefundene Fehler
Wir haben die neue Linkprüfung auf 23 veröffentlichte Artikel angewendet. Sie fand 3 Fälle, in denen ein im Verlinkungsbericht aufgeführter Link im Text fehlte, 2 doppelte Links auf dieselbe Seite und 23 URLs außerhalb der geplanten Seitenauswahl. Außerdem unterschieden sich die Seitenauswahlen zwischen den Sprachen in 4 von 30 Artikeln.
Zwei Befunde stachen heraus. In einem Artikel verlinkten die englische und die russische Version auf eine Seite der deutschen Domain. In einem anderen stimmte der Verlinkungsbericht nicht mit dem tatsächlichen Text überein, der Agent hatte also Arbeit gemeldet, die er nicht erledigt hatte.
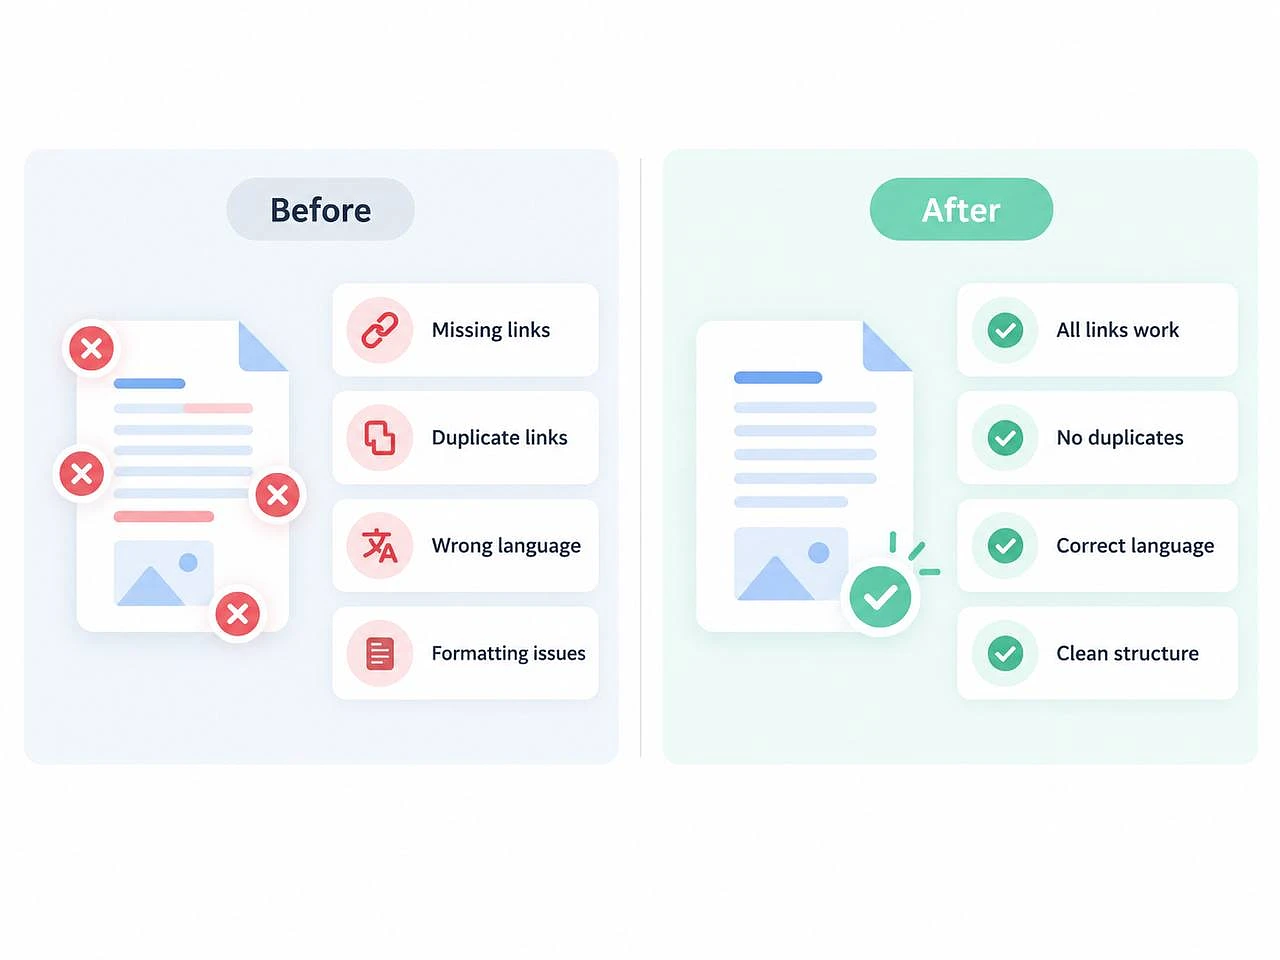
Die Illustration zeigt Fehlerarten und sagt nichts über ihre Häufigkeit aus. Für eine mehrsprachige Website sind solche Fehler teuer: Ein Link in der falschen Sprache unterbricht die Nutzerführung, die eine gute Webdesign Agentur sorgfältig plant, und ein fehlender Link schwächt die Seitenstruktur, auf die sich Suchmaschinen stützen.
Selbstheilungsregeln und Fehlerszenarien
Die Zuverlässigkeit der neuen Pipeline beruht auf expliziten Regeln, die wir festgelegt haben, bevor überhaupt etwas schiefging:
- eine fehlgeschlagene Validierung löst eine Wiederholung mit dem Validatorbericht aus, höchstens zweimal;
- ist ein externes System nicht erreichbar, wird auf eine Ersatzquelle ausgewichen;
- eine fehlgeschlagene unkritische Phase schreibt ein leeres, schemakonformes Artefakt, und die Generierung läuft weiter;
- eine fehlgeschlagene kritische Phase (Text, Übersetzung, Upload) stoppt den Durchlauf mit einem klaren Grund;
- 5xx-Fehler des Backends erhalten 3 Wiederholungen, ein 409-Slug-Konflikt wird nicht wiederholt.
Wir haben diese Regeln in Fehlerszenarien getestet. Als der Suchanbieter nicht verfügbar war, lief die Generierung weiter, und der Fehler wurde protokolliert und kategorisiert. Als wir einen geplanten Link aus der deutschen Version entfernten, stellte eine einzige Korrekturinferenz ihn beim ersten Versuch wieder her.
Ein Szenario deckte einen eigenen Fehler auf. Wurde nur die deutsche Übersetzung neu ausgeführt, blieben die anderen Sprachen unverändert, Metadaten und FAQ wurden jedoch für alle Sprachen neu berechnet. Wir haben das behoben. Genau deshalb führen wir Benchmarks durch, bevor wir die Produktion umstellen: um solche Probleme in einem kontrollierten Test zu finden.
Was das für die KI-Integration im Unternehmen bedeutet
Die Lehre reicht über Content hinaus. In jedem Geschäftsprozess, auch bei ERP-Integration und CRM-Integration, sollte das Modell nur die Schritte übernehmen, die Urteilsvermögen oder Sprache erfordern. Datenabruf, API-Aufrufe, Prüfungen, das Schreiben von Datensätzen und die KI-Orchestrierung sollten deterministisch, messbar und leicht rückgängig zu machen sein.
Externe Forschung weist in eine ähnliche Richtung. Die Forschung der MIT Sloan dazu, wie KI Workflows verändert, argumentiert, dass der größte Nutzen aus der Neugestaltung ganzer Workflows entsteht und dass jede Übergabe Koordinationskosten wie Prüfung und Validierung verursacht. Dort liegt der Fokus auf der Verkettung von Aufgaben für KI, bei uns auf der Trennung von Modellarbeit und Code, doch beide bewerten KI nach der Effizienz des Gesamtprozesses. Google Cloud beschreibt einen Wandel von Assistenten hin zu agentischen Teams und den Trend, natürlichsprachliche Schnittstellen über Altsysteme wie jahrzehntealte SAP-Instanzen zu legen. Genau in dieser Schicht entscheidet deterministische Integrationsarbeit darüber, ob die KI zuverlässig ist.
Agenten sind ein Werkzeug, keine Standardarchitektur
Unsere Position ist klar: Setzen Sie Agenten ein, wenn eine Aufgabe offene Erkundung erfordert, und gestalten Sie alles andere als Pipeline. Ein agentischer Workflow ist wertvoll, wenn der Weg zur Antwort unbekannt ist. Ist der Weg bekannt, geht Code ihn schneller, günstiger und mit weniger Überraschungen.
Andrey Popov, CTO und Gründer von Webdelo, fasst die redaktionelle Position des Teams auf Grundlage dieses Projekts zusammen:
Agentisches Verhalten ist ein Werkzeug, das wir für eine bestimmte Aufgabe wählen. Unsere eigene Pipeline hat gezeigt, dass der Großteil der Kosten entstand, weil Agenten Kontext erneut lasen und mit ihrer Umgebung kämpften, während das Schreiben selbst nur einen kleinen Anteil hatte. Wir geben dem Modell die Arbeit, die Bedeutung erfordert, und gestalten Daten, APIs, Prüfungen und Steuerung deterministisch, messbar und umkehrbar.
Andrey Popov, CTO und Gründer, Webdelo
Unser eigener Fall enthält auch das Gegenbeispiel. CMS-Korrekturen bleiben agentisch, weil Bearbeitungen des Gesamttexts im Skriptmodus mehr kosten: 6,75 $ gegenüber 5,12 $. Generierungsfehler dagegen findet Code in Sekunden. Wir entscheiden pro Aufgabe, auf Basis von Messungen.
Fragen vor der Skalierung der KI-Automatisierung
Bevor Sie einen KI-Prozess skalieren, empfehlen wir, dass Ihr Team diese Fragen mit Daten beantwortet:
- Wo braucht das Modell wirklich Bedeutung, und wo erledigt es Routinearbeit, die Code übernehmen könnte?
- Was kostet eine Einheit des Prozesses, einschließlich Wiederholungsläufen und manueller Neustarts?
- Wie wird die Qualität maschinell geprüft, bevor das Ergebnis einen Kunden oder einen Datensatz erreicht?
- Sind die Integrationen mit Ihrem ERP, CRM und internen APIs echt und funktionsfähig, oder überdeckt die KI fehlerhafte Daten mit erfundenen Ergebnissen?
- Gibt es vor Änderungen in der Produktion einen Benchmark mit denselben realen Workloads und einen Rollback-Schalter?
- Hat jemand die Messmethode selbst überprüft, etwa die doppelten Protokollzeilen, die unsere erste Kostenschätzung verdoppelt haben?
Steigende KI-Ausgaben werden zum Managementthema, wie die McKinsey-Analyse dazu, wie CIOs die KI-Nachfrage im großen Maßstab steuern können, zeigt. Die obigen Fragen machen aus diesem Thema konkrete Prüfungen für einen einzelnen Workflow.
Grenzen dieses Falls und was wir als Nächstes testen
Dies ist ein kleiner, ehrlicher Benchmark, und er beweist nichts allgemeingültig. Er umfasste 3 Blog-Briefings und 7 Korrekturen, verwendete Dollaräquivalente statt Rechnungen und stützte sich bei der Qualitätsbewertung auf ein Modell statt auf eine menschliche Redaktion. Seit der Behebung der Lücken, die der Benchmark aufgedeckt hat, haben wir nicht erneut gemessen.
Unser eigenes strenges Ziel "4-mal günstiger" haben wir pro Einzeldurchlauf ebenfalls verfehlt: Wir erreichten das 2,7-Fache pro Durchlauf und das 4,9-Fache pro tatsächlichem Artikel einschließlich Wiederholungen. Zum Zeitpunkt der Messung war die erste Skriptgenerierung über den Produktions-Worker noch nicht gelaufen.
Wo die Skriptversion schwächer war
Ein Modell bewertete die Entwürfe blind, als A/B, anhand einer redaktionellen Checkliste mit fünf Kriterien. Die Skriptversion gewann bei Briefing C (4,1 gegenüber 3,7) und verlor bei Briefing A (3,6 gegenüber 3,9) und Briefing B (3,2 gegenüber 4,0). Zwei von drei verlorenen Vergleichen zeigten uns, dass die Pipeline in diesem Zustand noch nicht bereit war.
Wir haben konkrete Ursachen gefunden und behoben:
- eine Service-Formulierung des Modells gelangte in den Artikeltext;
- die FAQ ignorierte die im Briefing aufgeführten Fragen;
- der Text fiel 38 % kürzer aus als die Agentenversion;
- das exakte Keyword fehlte in der russischen Version;
- alle Recherchequellen landeten in der niedrigsten Autoritätsstufe;
- Korrekturanfragen ohne Handlungsbedarf gingen in den teuren Agentenmodus.
Validierungswiederholungen verbrauchten zudem etwa 29 % der Skriptkosten, was das nächste naheliegende Ziel ist.
Was wir als Nächstes testen würden
Unsere nächsten Schritte ergeben sich direkt aus den genannten Grenzen:
- den Benchmark nach den Korrekturen mit denselben Briefings wiederholen, danach mit weiteren Content-Typen;
- zusätzlich zur Modellbewertung eine redaktionelle Bewertung durch Menschen einführen;
- tatsächliche Nutzungslimits und die Kosten von Produktionsläufen im Skriptmodus über längere Zeit verfolgen;
- Validierungswiederholungen reduzieren und einen günstigeren Weg für Korrekturen am Gesamttext finden.
Weitere Content-Typen sind wichtig, weil Blogartikel nur einen Teil dessen ausmachen, was die Plattform produziert. Branchenseiten haben eine andere Struktur und strengere Anforderungen, zum Beispiel Seiten zu Themen wie Immobilien Webseite erstellen, Website für Reparaturdienst oder Beauty Salon SEO. Wir veröffentlichen nur, was die Messungen belegen.
KI-Workflow-Optimierung in Ihrem Unternehmen planen
Wenn Ihre KI-Automatisierung funktioniert, aber teuer, langsam oder schwer vertrauenswürdig ist, liegt die Lösung meist in der Architektur, ein größeres Modell hilft selten. Dieselbe Methode wenden wir auf die Workflows unserer Kunden an: zuerst messen, Modellarbeit von Routinecode trennen, validieren und vor der Skalierung an realen Workloads vergleichen.
Für B2B-Unternehmen des Mittelstands in den USA und in Deutschland bedeutet dieser Ansatz der KI-Workflow-Optimierung in der Regel die Arbeit mit Systemen, die das Geschäft bereits tragen. Auftragsdaten liegen im ERP, die Kundenhistorie im CRM, und Inhalte speisen die Website und das Online Marketing. Gerade für KI im Mittelstand gilt: Sie muss sich mit klaren Eingaben, Prüfungen und Rollback in diese Landschaft einfügen.
Sprechen Sie mit unserem Team über Ihren KI-Workflow: Wir helfen Ihnen, den Prozess zu bewerten, die Architektur zu entwerfen, KI in Ihr ERP/CRM oder Ihre internen Systeme zu integrieren und die Wirtschaftlichkeit vor der Skalierung zu messen. Eine typische Zusammenarbeit umfasst:
- Workflow-Audit: wo das Modell Bedeutung beisteuert, wo es Routinearbeit erledigt und was eine Einheit einschließlich Wiederholungsläufen wirklich kostet.
- Architektur für KI-Assistent oder Agenten: ein Entwurf, der Agenten nur dort einsetzt, wo Erkundung nötig ist, und überall sonst deterministische Schritte.
- ERP/CRM-Integration: funktionierende Verbindungen zu Ihren Daten und APIs, damit das Modell nie raten muss.
- Kosten- und Zuverlässigkeits-Benchmark: ein Vergleich mit Ihren realen Workloads, mit einem Rollback-Plan vor dem Produktivbetrieb.
Wenn der Workflow kundennahe Systeme berührt, baut unser Team für Web Entwicklung die Integrationsschicht mit derselben Disziplin aus Verträgen, Validatoren und gemessenen Releases. Das Budget besprechen wir stets individuell, nachdem wir den Prozess verstanden haben.
Die wichtigsten Erkenntnisse aus dem Pipeline-Umbau
Unser KI-Workflow wurde günstiger und zuverlässiger, sobald wir Agenten keine Routinearbeit mehr überließen. Bei denselben drei Briefings sanken die Kosten um das 2,71-Fache und die Zeit um das 2,56-Fache, unter Berücksichtigung der realen Wiederholungsläufe sogar um bis zu das 4,86-Fache und 4,40-Fache. Deterministische Prüfungen fanden außerdem Fehler in bereits veröffentlichten Artikeln.
Die wichtigsten Lehren aus dem Umbau:
- Die Kosten kamen aus der Umgebung. Agenten lasen Kontext erneut und kämpften mit Dateipfaden, Signaturen und Parsing, in unserem Setup mit etwa 63 gelesenen Tokens pro geschriebenem Token. Der Modellpreis war ein Nebenfaktor, und das teure Modell lief nicht einmal.
- Agenten sind ein Werkzeug. Das Modell übernimmt Bedeutung: Schreiben, Übersetzen, Synthese. Code übernimmt Daten, APIs, Prüfungen, das Schreiben von Datensätzen und die Steuerung.
- Zuverlässigkeit folgt der Struktur. Verträge, Validatoren, Wiederholungen mit Feedback und ein gemeinsamer Linkplan machten Qualität messbar und wiederholbar.
- Auch Messungen müssen geprüft werden. Doppelte Protokollzeilen verdoppelten unsere erste Schätzung, und die korrigierte Methode veränderte die absoluten Zahlen.
- Grenzen bleiben sichtbar. Wir berichten Dollaräquivalente, eine kleine Stichprobe, modellbasierte Bewertung und die Briefings, bei denen die Skriptversion verlor, und behalten einen Rollback-Schalter in der Konfiguration.
Diese Prinzipien gelten weit über Content hinaus. Jede Geschäftsprozessautomatisierung, die KI mit einem ERP, einem CRM oder internen APIs verbindet, profitiert von derselben Trennung zwischen Urteilsvermögen und deterministischer Arbeit sowie von einem Benchmark mit realen Workloads, bevor etwas skaliert wird.
Wenn Sie planen, einen Geschäftsprozess mit KI zu automatisieren, oder Ihre bestehende Automatisierung mehr kostet, als sie sollte, sprechen Sie mit unserem Team. Wir bewerten den Workflow, entwerfen die Architektur, integrieren KI in Ihr ERP/CRM oder Ihre internen Systeme und messen gemeinsam mit Ihnen die Wirtschaftlichkeit, bevor Sie skalieren.
