


Für langlebige Systeme bleiben Frameworks sinnvoll
Meine Antwort auf die Debatte um vibe coding frameworks lautet: ja, bei komplexen, langlebigen Systemen. KI kann den Aufwand beim Programmieren senken. Tests, Fehlerbehebung, Updates von Abhängigkeiten und die Betreuung der Software brauchen weiterhin Zeit und Sorgfalt.
Ich bin Andrey Popov, CTO und Mitgründer von Webdelo. Meine Einschätzung beruht auf der Arbeit unseres Teams an komplexer Software. Sie ist ein technisches Urteil, keine für jedes Projekt belegte Regel.
Vibe Coding bedeutet, eine Aufgabe in einfachen Worten zu beschreiben und einen KI-Agenten den Code schreiben zu lassen. Ein Framework ist eine fertige Grundlage für eine Anwendung mit gemeinsamen Regeln. Eine bewährte Grundlage wie Laravel, Spring Boot oder Django muss anders bewertet werden als ein kleines Paket, das einen einzelnen externen Dienst anbindet.
KI spart Tipparbeit, aber die Verantwortung bleibt
Das Argument gegen Frameworks ist einfach: Wenn ein Agent den Code erzeugen kann, warum sollte man fremde Regeln akzeptieren? Dieses Argument betrachtet die erste Version. Uns beschäftigt, was passiert, wenn sich die Software ändert oder ausfällt.
Frameworks sparen wiederkehrende Arbeit. KI verringert diesen Vorteil. Aber jemand muss das Ergebnis weiterhin prüfen und dem nächsten Entwickler erklären. Bei unserer Arbeit in der web entwicklung beeinflussen solche Übergaben und spätere Änderungen die Wahl der Grundlage.
Unter dem Begriff "Framework" werden außerdem Werkzeuge mit unterschiedlichen Aufgaben zusammengefasst:
- Server-Frameworks wie Laravel, Spring Boot und Django organisieren die Anwendungslogik und den Datenzugriff.
- Werkzeuge für Benutzeroberflächen wie Vue.js und Next.js helfen beim Aufbau der Teile, mit denen Nutzer interagieren.
- Go Fx verbindet Anwendungskomponenten und steuert deren Start und Herunterfahren.
- Bibliotheken bieten eine enger begrenzte Funktion, die eine Anwendung bei Bedarf aufruft.
- SDKs bieten fertige Werkzeuge für eine externe API. Über diese Schnittstelle tauschen Systeme Anfragen und Antworten aus.
- Agenten-Frameworks koordinieren KI-Modelle, Werkzeuge und Schritte in einem Arbeitsablauf.
Ein Grund, auf ein kleines SDK zu verzichten, ist kein Grund, ein ganzes Anwendungsframework aufzugeben.
Bewährte Frameworks geben KI-Agenten eine bekannte Struktur
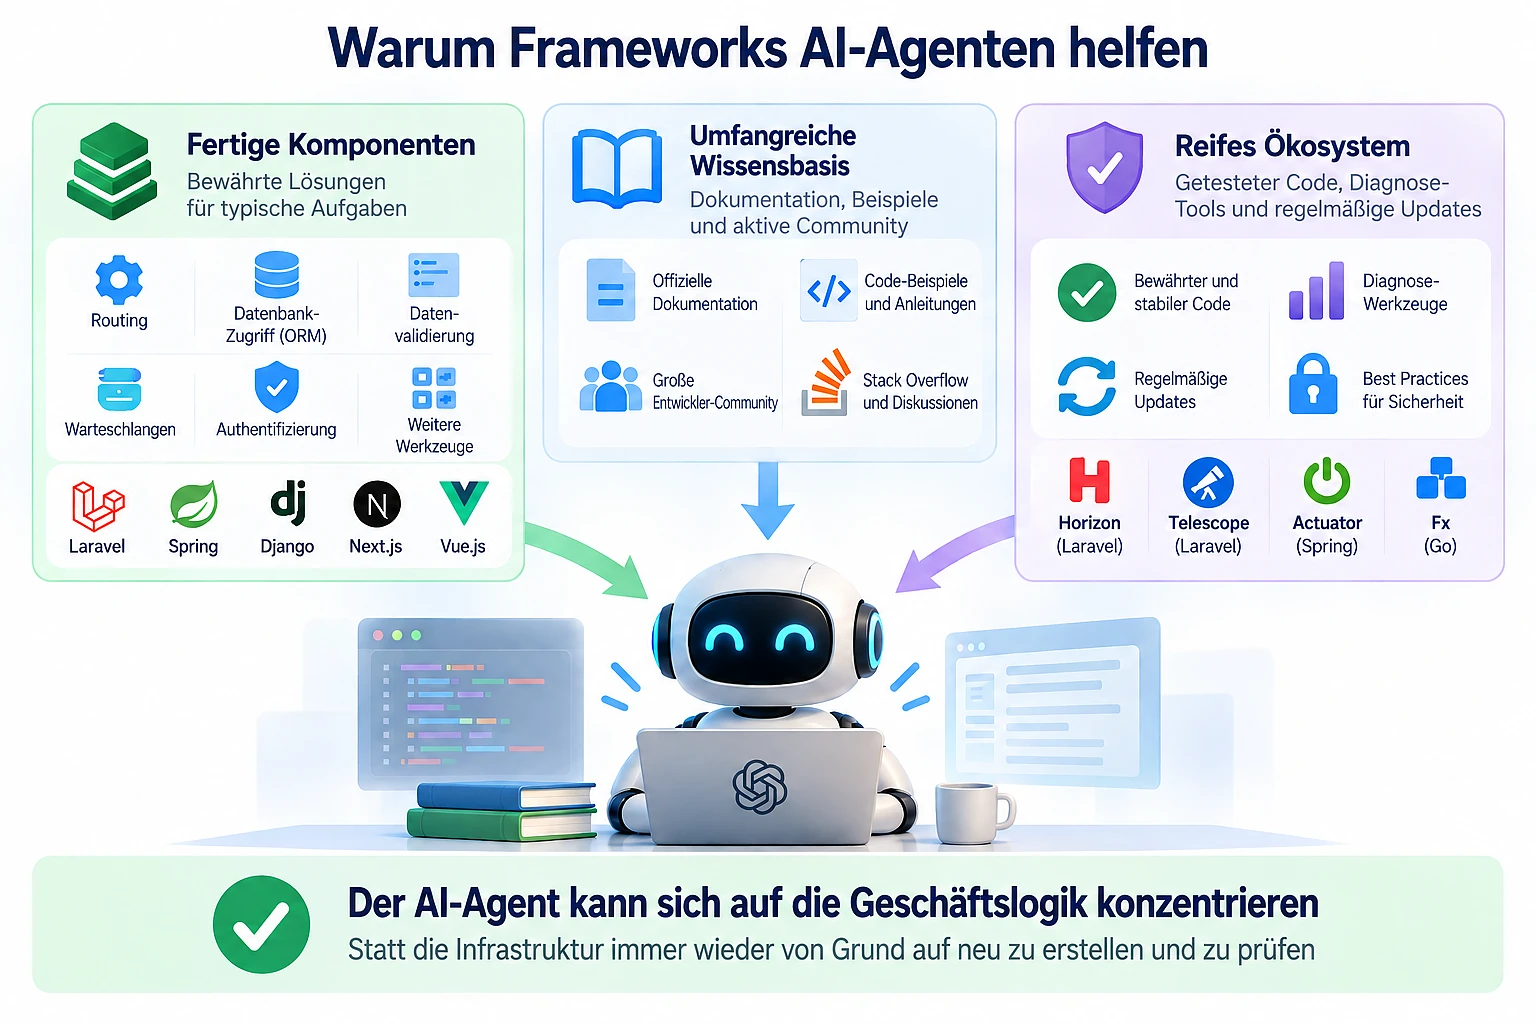
Bewährte Frameworks für die KI-gestützte Entwicklung, auch AI-assisted development frameworks genannt, geben dem Team und dem Agenten fertige Komponenten, Dokumentation und Diagnosewerkzeuge. So bleibt mehr Aufmerksamkeit für die Geschäftsregeln. Nach unserer Erfahrung hilft diese Struktur besonders dann, wenn eine Anwendung über Jahre betreut werden muss.
Fertige Komponenten und gemeinsame Regeln
Server-Frameworks und ihr Ökosystem decken häufige Anforderungen ab:
- Eingehende Anfragen an den richtigen Code weiterleiten.
- Datensätze in einer Datenbank lesen und schreiben.
- Übermittelte Daten prüfen.
- Nutzer und Zugriffsrechte verwalten.
- Hintergrundaufgaben über Warteschlangen ausführen.
In crm-systemen werden Kundenbeziehungen verwaltet. Die Regeln zur Kundenzuordnung können unternehmensspezifisch sein. Die grundlegenden Abläufe zum Empfangen von Anfragen und Prüfen von Eingaben müssen meist nicht neu entworfen werden.
Gemeinsame Konventionen zeigen einem Agenten auch, wohin eine Änderung gehört. Ein Entwickler, der Django oder Laravel kennt, kann sich im Projekt schnell orientieren. Bei einer selbst entwickelten Grundlage muss er die Struktur erst kennenlernen.
Dokumentation hilft Menschen und Agenten
Offizielle Dokumentation und ausgearbeitete Beispiele geben einem Agenten hilfreiche Anhaltspunkte. Diskussionen in der Community können auch bekannte Fehlerfälle erklären. Bei einer eigenen Grundlage muss das Team mehr von diesem Wissen selbst aufbauen und aktuell halten.
Weitverbreitete Frameworks werden öffentlich geprüft und verbessert. Beliebtheit garantiert aber keine Sicherheit. Die richtige Konfiguration und rechtzeitige Updates bleiben die Verantwortung des Teams.
Bestehende Komponenten könnten auch die Menge des vom Agenten erzeugten Codes und seinen Token-Verbrauch senken. Ich sehe darin eine Möglichkeit bei einzelnen Aufgaben, keine gemessene Kostenersparnis.
Diagnose hilft, wenn etwas ausfällt
Eine fehlgeschlagene Hintergrundaufgabe lässt sich leichter untersuchen, wenn die nötigen Werkzeuge schon vorhanden sind. Bewährte Ökosysteme bieten praktische Möglichkeiten, das Verhalten einer Anwendung zu prüfen:
- Laravel Horizon überwacht Aufgabenwarteschlangen auf Redis-Basis.
- Laravel Telescope hilft beim Prüfen von Anfragen, Fehlern und Datenbankaktivitäten.
- Spring Boot Actuator bietet Zustandsprüfungen und Messwerte für Anwendungen.
Uber Fx erfüllt einen anderen Zweck. Es verwaltet Abhängigkeiten und den Lebenszyklus von Komponenten in Go. Es gibt Struktur, ersetzt aber nicht diese Überwachungswerkzeuge.
Für uns sind diese Werkzeuge bei Störungen im laufenden Betrieb besonders wichtig. Dann ist ein schlechter Zeitpunkt, um erst eine Möglichkeit zur Beobachtung der Anwendung zu bauen.
Vibe coding without frameworks passt zu kleinen, klar begrenzten Aufgaben
Vibe Coding ohne Frameworks ist sinnvoll, wenn eine Aufgabe wenig Infrastruktur braucht. Ein einmaliges Skript oder ein kleines Hilfsprogramm lässt sich als schlankes Programm womöglich leichter verstehen und pflegen. Ein großes Framework kann mehr Arbeit verursachen, als es spart.
Ein Skript, das eine lokale CSV-Datei in ein anderes Format umwandelt, braucht zum Beispiel vielleicht nur eine Standardbibliothek. Ein Anwendungsframework bringt Einrichtungsaufwand und Updates mit sich, ohne bei der Aufgabe zu helfen.
Ich würde den Aufwand über die gesamte Lebensdauer der Lösung vergleichen:
- Die gewählten Werkzeuge kennenlernen und einbinden.
- Normales Verhalten und Fehlerfälle testen.
- Updates und Sicherheitskorrekturen einspielen.
- Den Code an einen anderen Entwickler übergeben.
Auch Anthropics Leitfaden zum Aufbau effektiver Agenten bevorzugt einfache Lösungen aus kombinierbaren Bausteinen. Er betrifft vor allem die Koordination von Agenten, nicht Web-Frameworks wie Laravel oder Django. Die hilfreiche Lehre daraus: Vermeiden Sie Schichten, die keinen Nutzen bringen.
Wird aus einem Prototyp ein dauerhafter Dienst, prüfen Sie seine Architektur erneut. Ein einmalig genutztes Programm braucht eine andere Betreuung als ein Dienst, auf den Kunden täglich angewiesen sind.
Bei einem kleinen SDK muss die Wartung separat geprüft werden
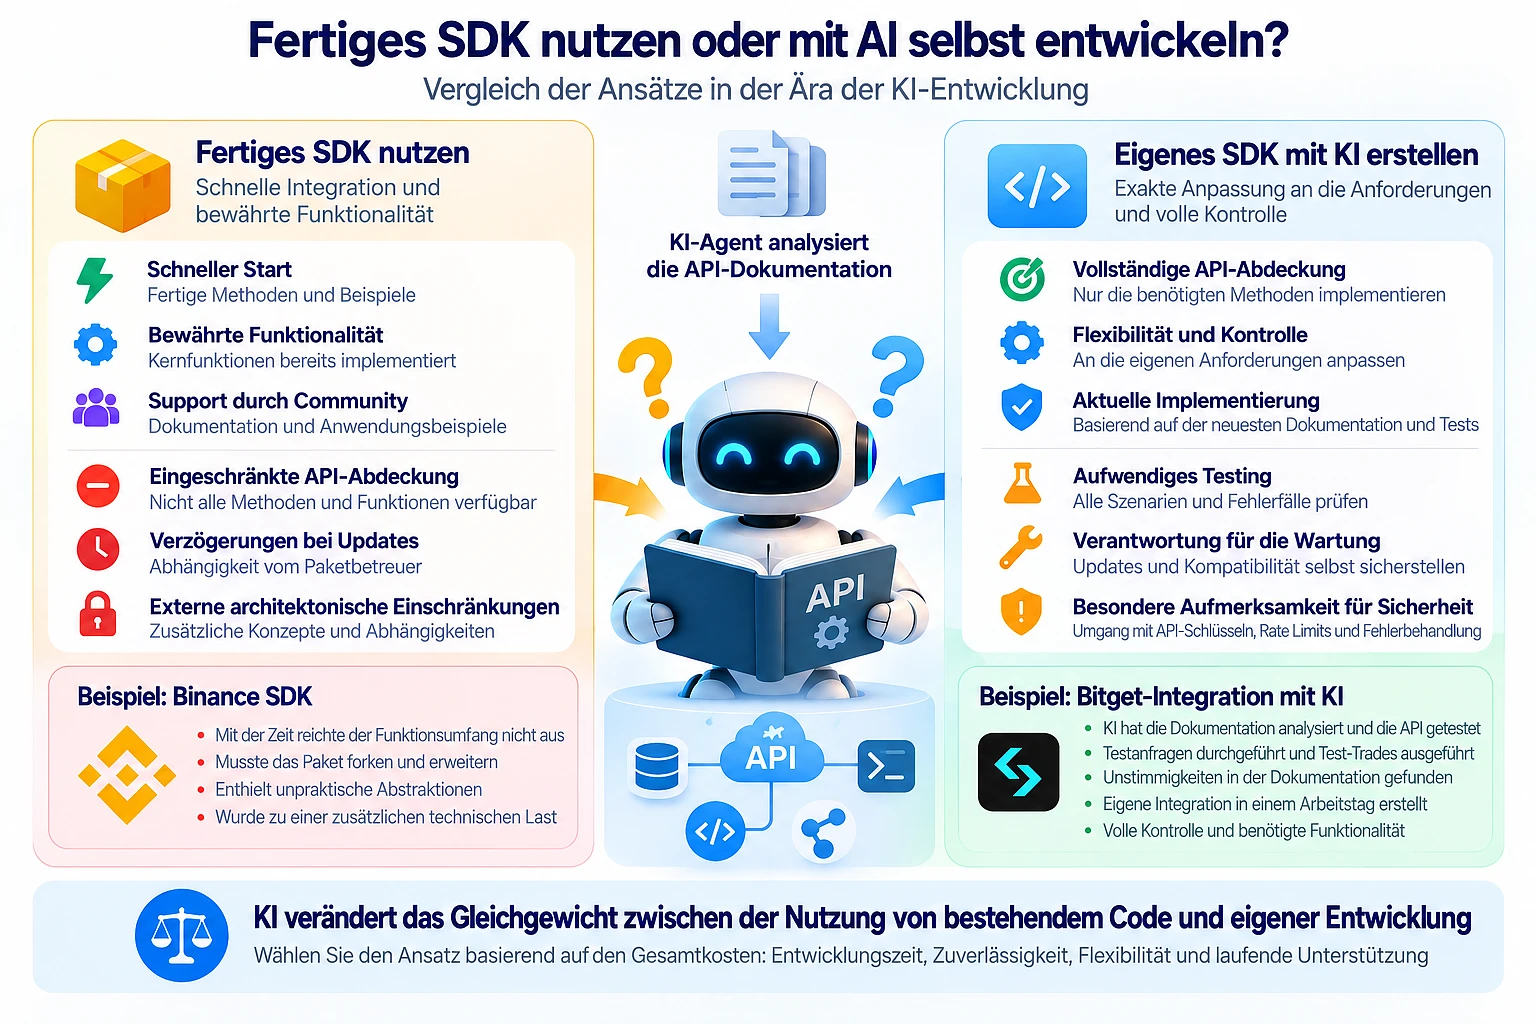
Ein SDK kann Integrationsarbeit sparen. Sein Nutzen hängt aber davon ab, welche Funktionen es abdeckt und wie es gepflegt wird. Ein Paket, das von ein oder zwei Personen betreut wird, kann hinter der externen API zurückbleiben. Ihr Team übernimmt dann womöglich Arbeit, die eigentlich das Paket erledigen sollte.
Vor der Wahl eines SDK würde ich auf diese Warnzeichen achten:
- Lange Pausen zwischen Updates, während sich die API weiter verändert.
- Fehlende Methoden, die das Produkt braucht.
- Unzureichende Tests, besonders für Fehlerfälle.
- Verborgene Details von Anfragen oder Antworten, die zur Fehlersuche nötig sind.
- Ein Aufbau, der umständliche Änderungen an anderen Stellen der Anwendung erzwingt.
Beim Vergleich zwischen SDK und eigener API-Integration verändert KI den anfänglichen Aufwand für einen kleinen, spezialisierten Client. Ein schwaches Paket gewinnt nicht mehr allein deshalb, weil es bereits existiert. Ein gut gepflegtes SDK kann weiterhin die bessere Wahl sein.
Binance und Bitget zeigten uns zwei unterschiedliche Folgeaufwände
Wir betreuen eine Plattform mit hoher Systemlast für algorithmischen Handel und Marktanalysen. Ein Binance-SDK eines Drittanbieters erleichterte uns den Einstieg. Später mussten wir dessen Code selbst pflegen. Für Bitget entwickelten wir mit KI-Agenten einen eigenen Client mit begrenztem Funktionsumfang.
Das sind Erfahrungen unseres Teams mit konkreten Integrationen. Sie sind weder eine externe Prüfung der beiden Börsen noch ein Urteil über deren SDK-Ökosysteme.
Binance: vom fertigen Paket zum eigenen Fork
Das Binance-Paket deckte die anfangs benötigten Funktionen bereits ab. Das sparte uns zunächst Entwicklungsarbeit.
Später blieb es hinter der API zurück, und uns fehlten benötigte Methoden. Auch seine Struktur schränkte uns beim Aufbau der Integration ein. Wir erstellten einen Fork, also eine eigene Kopie des Pakets, um es ändern zu können.
Damit mussten wir fremden Code selbst erweitern und pflegen. Aus der ursprünglichen Abkürzung waren technische Schulden geworden: eine Entscheidung, die spätere Änderungen teurer machte. Diese Erfahrung betrifft dieses Paket in diesem Projekt.
Bitget: ein spezialisierter Client, mit Agenten entwickelt
Für Bitget entschieden wir uns für einen eigenen Client. Die Agenten arbeiteten mit der API-Dokumentation und prüften das Verhalten des Dienstes:
- Sie führten echte Anfragen und Anfragen in der Testumgebung aus.
- Sie prüften Testvorgänge.
- Sie testeten WebSocket-Verbindungen. Diese bleiben für laufende Aktualisierungen geöffnet.
- Sie hielten Unterschiede zwischen dokumentiertem und beobachtetem Verhalten in einer README-Datei und einem Bericht fest.
Nach meiner Schätzung hatten wir nach etwa einem Arbeitstag eine funktionsfähige Basis. Die API hatte eine ausführliche Dokumentation und eine Testumgebung. Außerdem hielten wir den benötigten Funktionsumfang klein.
Diese Zeitangabe gilt für dieses Projekt. Das Ergebnis des ersten Tages brauchte weitere Tests und Arbeit, um Fehler zuverlässig zu behandeln.
Was in unserer Verantwortung bleibt
Mit einem eigenen Client bestimmen wir seinen Aufbau selbst. Wir bleiben aber auch für jeden Fehlerfall verantwortlich:
- Fehlerbehandlung: festlegen, was passiert, wenn eine Anfrage fehlschlägt oder eine unerwartete Antwort erhält.
- Wiederholungsversuche und Idempotenz: sicherstellen, dass eine wiederholte Anfrage denselben Vorgang nicht zweimal ausführt.
- Anfragelimits: die von der Börse erlaubte Zahl von Anfragen pro Zeiteinheit einhalten.
- Verbindungswiederherstellung: nach einem Abbruch die Verbindung neu aufbauen und prüfen, ob Aktualisierungen fehlen.
- Schutz von Zugangsschlüsseln: Zugangsdaten aus Quellcode und Protokollen heraushalten.
- Tests und Betreuung: Änderungen prüfen, während sich die API und unsere Anwendung weiterentwickeln.
Forschung zum Programmieren mit KI liefert Kontext, kein Urteil über Frameworks
Die folgenden Studien beantworten die Framework-Frage nicht direkt. Sie zeigen, dass die Wirkung von KI von der Aufgabe und den Werkzeugen abhängt. Und dass erzeugter Code geprüft werden muss. Mein Urteil zur Architektur ist von diesen Ergebnissen zu trennen.
Geschwindigkeit hängt von den Bedingungen ab
Im METR-Experiment von 2025 erledigten 16 erfahrene Entwickler 246 Aufgaben in ausgereiften Open-Source-Projekten. Mit KI-Werkzeugen vom Anfang des Jahres 2025 brauchten sie 19 % länger. Dieses Ergebnis beschreibt diese Bedingungen, nicht alle Entwickler.
Die METR-Aktualisierung von 2026 behandelt Auswahlverzerrungen: Wer an einem Experiment teilnimmt und welche Aufgaben die Teilnehmer mitbringen, kann das Ergebnis verzerren. Laut den Forschern sind neuere Werkzeuge wahrscheinlich nützlicher. Sie erklären auch, warum sich die aktuelle Wirkung nur schwer zuverlässig messen lässt.
Ein Google-Experiment mit 96 Entwicklern schätzte die Zeitersparnis bei Aufgaben in einem bestimmten Unternehmensumfeld auf etwa 21 %. Diese Schätzung war mit erheblicher Unsicherheit verbunden. Es gibt keine einzelne Kennzahl zur KI-Produktivität, die uns die richtige Architektur vorgibt.
Vertrauen und Sicherheit erfordern Prüfungen
In der Stack-Overflow-Entwicklerumfrage 2025 nannten etwa 66 % der Teilnehmer an der Frage zu KI-Frustrationen Antworten, die "fast richtig, aber nicht ganz" waren. Bei der Frage zur Genauigkeit misstrauten 46 % den KI-Ergebnissen, während 33 % ihnen vertrauten. Das sind Antworten auf getrennte Fragen, keine Messungen der Codequalität.
Für Vergleiche mit der Umfrage von 2026 müssen die Fragestellungen und Teilnehmergruppen vergleichbar sein. Vertrauen in eine leicht überprüfbare Antwort ist etwas anderes als allgemeines Vertrauen in die Genauigkeit.
Der Sicherheitsanbieter Veracode meldete unsichere Ergebnisse bei etwa 45 % seiner ausgewählten Aufgaben zur Codegenerierung. Die Aufgaben prüften sicherheitsrelevante Programmierszenarien. Die Zahl bezieht sich nicht auf 45 % aller KI-generierten Software.
Meine praktische Schlussfolgerung: Schreiben Sie möglichst wenig unnötigen eigenen Code für sicherheitsrelevante Funktionen. Wenn wir gepflegte Komponenten wiederverwenden, müssen wir weniger neue Implementierungen prüfen. Sicherheitstests auf Anwendungsebene bleiben notwendig.
Struktur beibehalten und zusätzliche Schichten hinterfragen
OpenAIs Fallstudie zum Harness Engineering beschreibt eine von Agenten getragene Entwicklung mit klaren Architekturgrenzen und Dokumentation. Sie betont auch automatisierte Prüfungen, Messwerte und Werkzeuge zur Beobachtung des Systemverhaltens. Das ist die Erfahrung eines Unternehmens, kein Vergleich von Web-Frameworks.
Ich sehe in dieser Fallstudie und in Anthropics Leitfaden ein gemeinsames Prinzip: Geben Sie Agenten klare Regeln und vermeiden Sie unnötige Schichten. Bewährte Frameworks können diese Regeln liefern. Das Team muss weiterhin entscheiden, welche Teile das Projekt tatsächlich braucht.
Framework vs custom code: Komplexität und Betreuung abwägen
Ich beginne mit zwei Fragen: Wie komplex ist das System? Und wie stark muss es besonderen Anforderungen entsprechen? Dann schätze ich den Aufwand für die Betreuung ein. KI verändert den Entwicklungsaufwand, nimmt uns diese Entscheidung aber nicht ab.
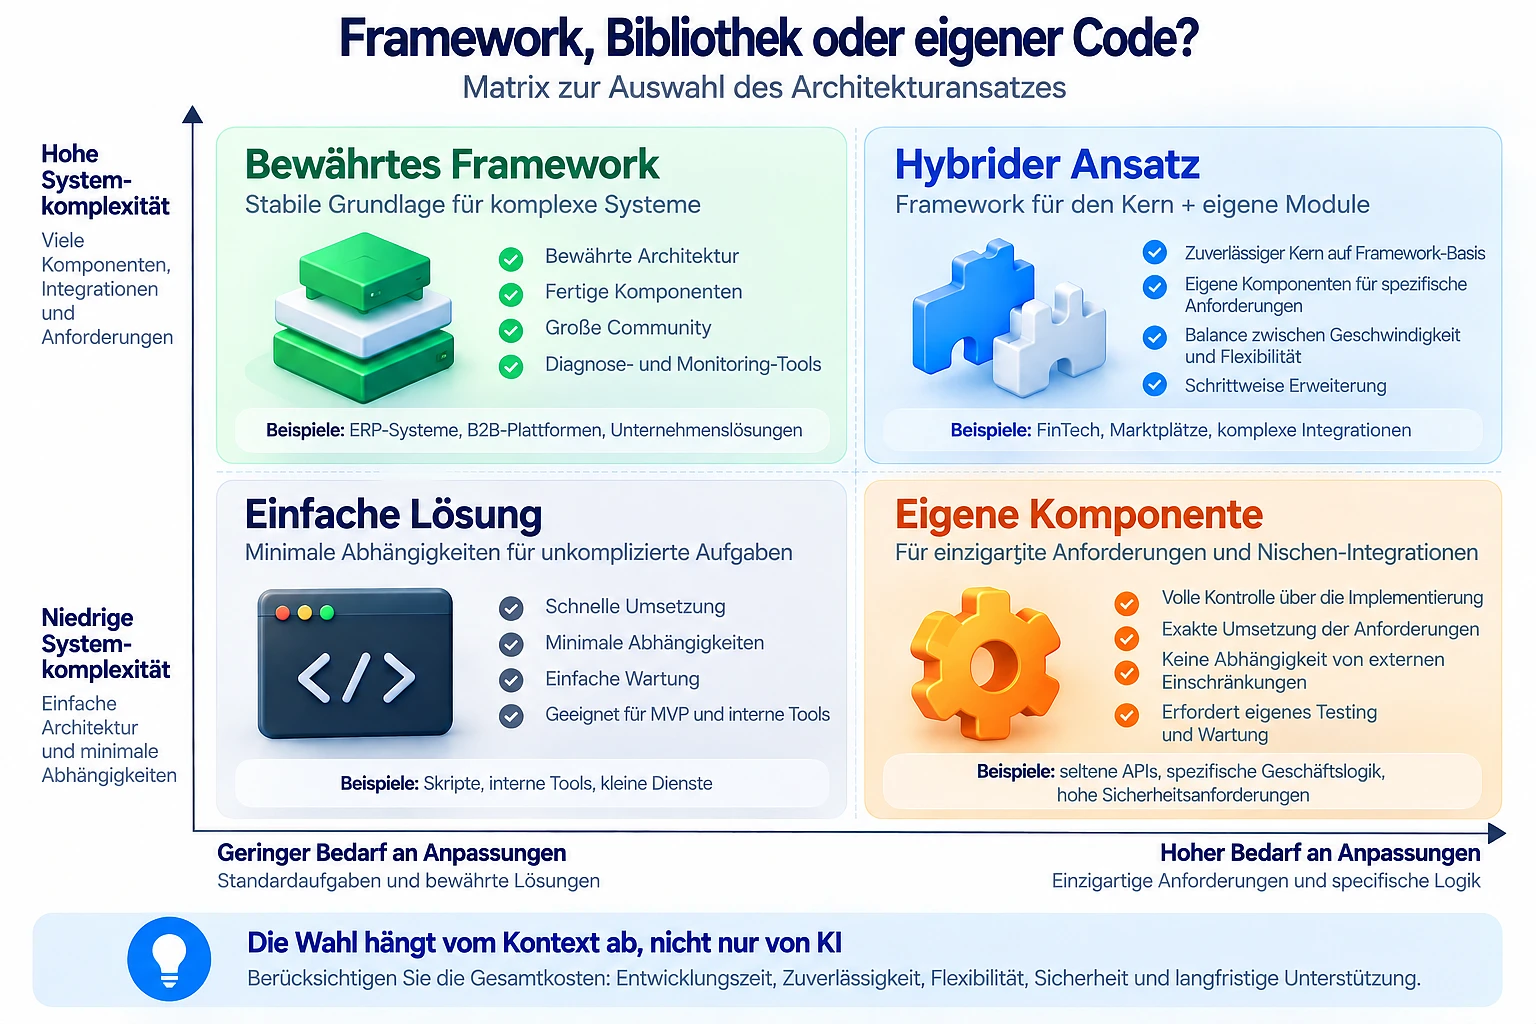
| Situation | Naheliegender Ausgangspunkt | Wichtigste Prüffrage |
|---|---|---|
| Komplexes, langlebiges System mit üblichen Anwendungsanforderungen | Bewährtes Framework | Passt seine Struktur zum Produkt und zum betreuenden Team? |
| Komplexes System mit besonderen Geschäftsregeln oder Integrationen | Mischlösung: bewährte Grundlage mit eigenen Komponenten | Lassen sich die eigenen Teile klar abgrenzen? |
| Einfache, einmalige Aufgabe | Schlankes Programm oder kleine Bibliothek | Bleibt die Aufgabe klar begrenzt? |
| Eng begrenzte Integration mit guter Dokumentation, einer Testumgebung und einem schwachen SDK | Kleiner eigener Client | Wer übernimmt Fehlerbehandlung, Sicherheit und API-Updates? |
Bei komplexen B2B-Systemen bevorzugen wir oft eine Mischlösung. Wir behalten eine bewährte Anwendungsgrundlage und entwickeln ausgewählte Integrationen selbst. Eine gute Bibliothek oder ein gutes SDK kann diese Lücken füllen, wenn es passt.
Diese Matrix ist eine Orientierung, keine Regel. Prüfen Sie das konkrete Paket und die API. Nutzen Sie für Kryptografie und kritische Infrastruktur etablierte Implementierungen, statt einen Agenten Ersatzlösungen erfinden zu lassen.
In unserer Agentur für Webdesign und Webentwicklung gehört diese Entscheidung zur Planung der langfristigen Betreuung. Eine hilfreiche Abschlussfrage lautet: Wer wird diesen Code in zwei Jahren verstehen und pflegen?
Wählen Sie eine Grundlage, die Sie dauerhaft betreuen können
Für komplexe Software bevorzuge ich weiterhin bewährte Frameworks mit kleinen eigenen Komponenten, wo sie sinnvoll sind. Für ein klar begrenztes Skript bevorzuge ich eine schlanke Lösung. Entscheidend ist der Aufwand, den das Ergebnis verursacht, nachdem die erste Version läuft.
Besprechen Sie mit Webdelo die Architektur und langfristige Betreuung Ihrer geschäftskritischen Software.
Häufig gestellte Fragen
Braucht man beim Vibe Coding noch Frameworks?
Bei komplexen, langlebigen Systemen ja. KI senkt den Aufwand beim Schreiben von Code, aber Tests, Fehlerbehebung, Updates von Abhängigkeiten und Betreuung brauchen weiterhin Zeit. Ein bewährtes Framework wie Laravel, Spring Boot oder Django gibt dem Team und dem KI-Agenten fertige Komponenten, Dokumentation und Diagnosewerkzeuge. Das ist die Einschätzung von Webdelo-CTO Andrey Popov, keine Regel, die für jedes Projekt bewiesen ist.
Was ist Vibe Coding und was ist ein Framework?
Vibe Coding bedeutet: Sie beschreiben eine Aufgabe in einfachen Worten, und ein KI-Agent schreibt den Code. Ein Framework ist eine fertige Grundlage für eine Anwendung mit gemeinsamen Regeln für ihren Aufbau. Server-Frameworks wie Laravel, Spring Boot und Django decken übliche Aufgaben ab: Anfragen zuordnen, mit der Datenbank arbeiten, Eingaben prüfen, Nutzer verwalten und Hintergrundaufgaben ausführen.
Wann ist Vibe Coding ohne Framework sinnvoll?
Er passt zu kleinen, klar begrenzten Aufgaben, die wenig Infrastruktur brauchen. Für ein einmaliges Skript, das etwa eine lokale CSV-Datei in ein anderes Format umwandelt, reicht oft die Standardbibliothek. Ein großes Framework brächte Einrichtung und Updates mit sich, ohne der Aufgabe zu helfen. Wird aus dem Prototyp später ein dauerhafter Dienst, sollten Sie die Architektur erneut prüfen.
Wie entscheidet man zwischen einem fremden SDK und einem eigenen API-Client?
Prüfen Sie, wie gut das SDK gepflegt wird und ob es Ihren Bedarf abdeckt. Warnzeichen sind lange Pausen zwischen Updates, fehlende Methoden, schwache Tests, verborgene Details der Anfragen und ein Aufbau, der unpassende Änderungen in Ihrer Anwendung erzwingt. Ist das SDK schwach, die API aber gut dokumentiert und mit Testumgebung ausgestattet, kann ein kleiner eigener Client mit KI-Agenten die bessere Wahl sein. Ein gut gepflegtes SDK kann trotzdem die bessere Lösung bleiben.
Was hat Webdelo aus den Integrationen von Binance und Bitget gelernt?
Ein fremdes Binance-Paket sparte am Anfang Arbeit, blieb dann aber hinter der API zurück, und es fehlten benötigte Methoden. Webdelo musste einen Fork anlegen und fremden Code selbst pflegen. Für Bitget bauten KI-Agenten einen schmalen eigenen Client anhand der Dokumentation, echter und Test-Anfragen sowie WebSocket-Prüfungen. Nach Schätzung des CTO stand eine funktionierende Basis in etwa einem Arbeitstag, doch das gilt nur für dieses Projekt, und das Ergebnis brauchte weitere Tests.
Was bleibt in Ihrer Verantwortung, wenn Sie einen eigenen API-Client mit KI bauen?
Sie verantworten jeden Fehlerfall selbst. Dazu gehören Fehlerbehandlung, sichere Wiederholungen, damit eine wiederholte Anfrage denselben Vorgang nicht doppelt ausführt, das Einhalten der Anfragelimits und der Wiederaufbau einer abgebrochenen Verbindung. Außerdem dürfen Schlüssel nicht in Quellcode oder Logs gelangen, und der Client muss getestet werden, wenn sich API und Anwendung ändern.
Warum beantworten Studien zum Programmieren mit KI die Framework-Frage nicht?
Sie messen KI unter bestimmten Bedingungen, nicht die Wahl eines Frameworks. Im METR-Experiment von 2025 brauchten 16 erfahrene Entwickler mit KI-Werkzeugen von Anfang 2025 19% länger. Das METR-Update von 2026 hält neuere Werkzeuge für wahrscheinlich nützlicher, aber schwer verlässlich messbar. Ein Google-Experiment mit 96 Ingenieuren schätzte rund 21% weniger Zeit pro Aufgabe, mit erheblicher Unsicherheit. Veracode fand bei etwa 45% seiner ausgewählten sicherheitskritischen Aufgaben unsichere Ergebnisse, deshalb muss erzeugter Code weiterhin geprüft werden.
