Warum Ihr Backend-Stack eine Geschäftsentscheidung ist
Für Teams, die Golang für Hochlastsysteme evaluieren, zählen praktische Vorteile: kompilierter Code, leichtgewichtige Nebenläufigkeit und einfache Bereitstellung. Go eignet sich für viele stark frequentierte APIs und Hintergrunddienste. Bei Webdelo wählen wir Technologien anhand von Systemanforderungen und Messergebnissen. Denn der Backend-Stack beeinflusst Infrastrukturkosten, die Wiederherstellung nach Störungen und die langfristige Wartung.
Wir entwickeln B2B-Plattformen, ERP/CRM-Systeme, FinTech- und Trading-Anwendungen sowie Hochlastdienste. Bei diesen Produkten wirken sich Architekturentscheidungen auf DevOps, QA und Betrieb aus. Die gewählte Sprache muss sowohl zum betreuenden Team als auch zur Arbeitslast passen.
Entscheidend ist, wo Go ein konkretes System verbessert. Dafür braucht es eine definierte Arbeitslast, ein Verständnis von Nebenläufigkeit und einen realistischen Vergleich mit dem bestehenden Stack.
Was macht ein Backend-System zum Hochlastsystem?
Ein Backend wird zum Hochlastsystem, wenn Datenverkehr, Nebenläufigkeit oder Latenzanforderungen an seine Ressourcengrenzen stoßen. Die Anfragerate allein beschreibt diesen Druck nicht. Zur Definition gehören auch Zuverlässigkeit bei Lastspitzen und die Erholung nach Ausfällen.
- Anfragen pro Sekunde (RPS): eingehende Nachfrage und abgeschlossener Durchsatz, getrennt gemessen, wenn Anfragen warten oder fehlschlagen.
- Gleichzeitige Verbindungen und Anfragen: offene Verbindungen verbrauchen Ressourcen, auch wenn nur wenige Daten darüber fließen.
- p95- und p99-Latenz: die Antwortzeiten, unterhalb derer 95 % beziehungsweise 99 % der Anfragen abgeschlossen werden. Sie zeigen langsame Anfragen, die Durchschnittswerte verdecken.
- Fehlerrate: fehlgeschlagene Vorgänge, einschließlich abgewiesener Anfragen und Zeitüberschreitungen bei nachgelagerten Diensten.
- Verfügbarkeit: ob Nutzer die Vorgänge abschließen können, die der Dienst unterstützen soll.
CPU-limitierte Aufgaben verbringen ihre Zeit mit Berechnungen, etwa beim Verschlüsseln von Daten oder beim Berechnen von Preisen. I/O-limitierte Aufgaben warten auf Datenbanken oder entfernte Dienste. Viele geschäftliche Backends sind I/O-lastig. Welche Ressource einen bestimmten Endpunkt begrenzt, muss jedoch Profiling zeigen.
Nehmen Sie eine Bestell-API, die auf einen Bestandsdienst wartet. Mehr gleichzeitige Anfragen können die Warteschlange verlängern, ohne die Zahl abgeschlossener Bestellungen zu erhöhen. Backpressure begrenzt die Annahme neuer Arbeit, wenn nachgelagerte Kapazitäten erschöpft sind. Eine kontrollierte Funktionseinschränkung erhält wesentliche Funktionen, wenn optionale Abhängigkeiten ausfallen.
Hohe Last ist eine Eigenschaft des gesamten Systems, nicht einer einzelnen Sprache. Die grundlegenden Prinzipien beschreiben wir in unserem Leitfaden für skalierbare Softwarearchitektur. Hier geht es um die Rolle von Go in diesem Gesamtbild.
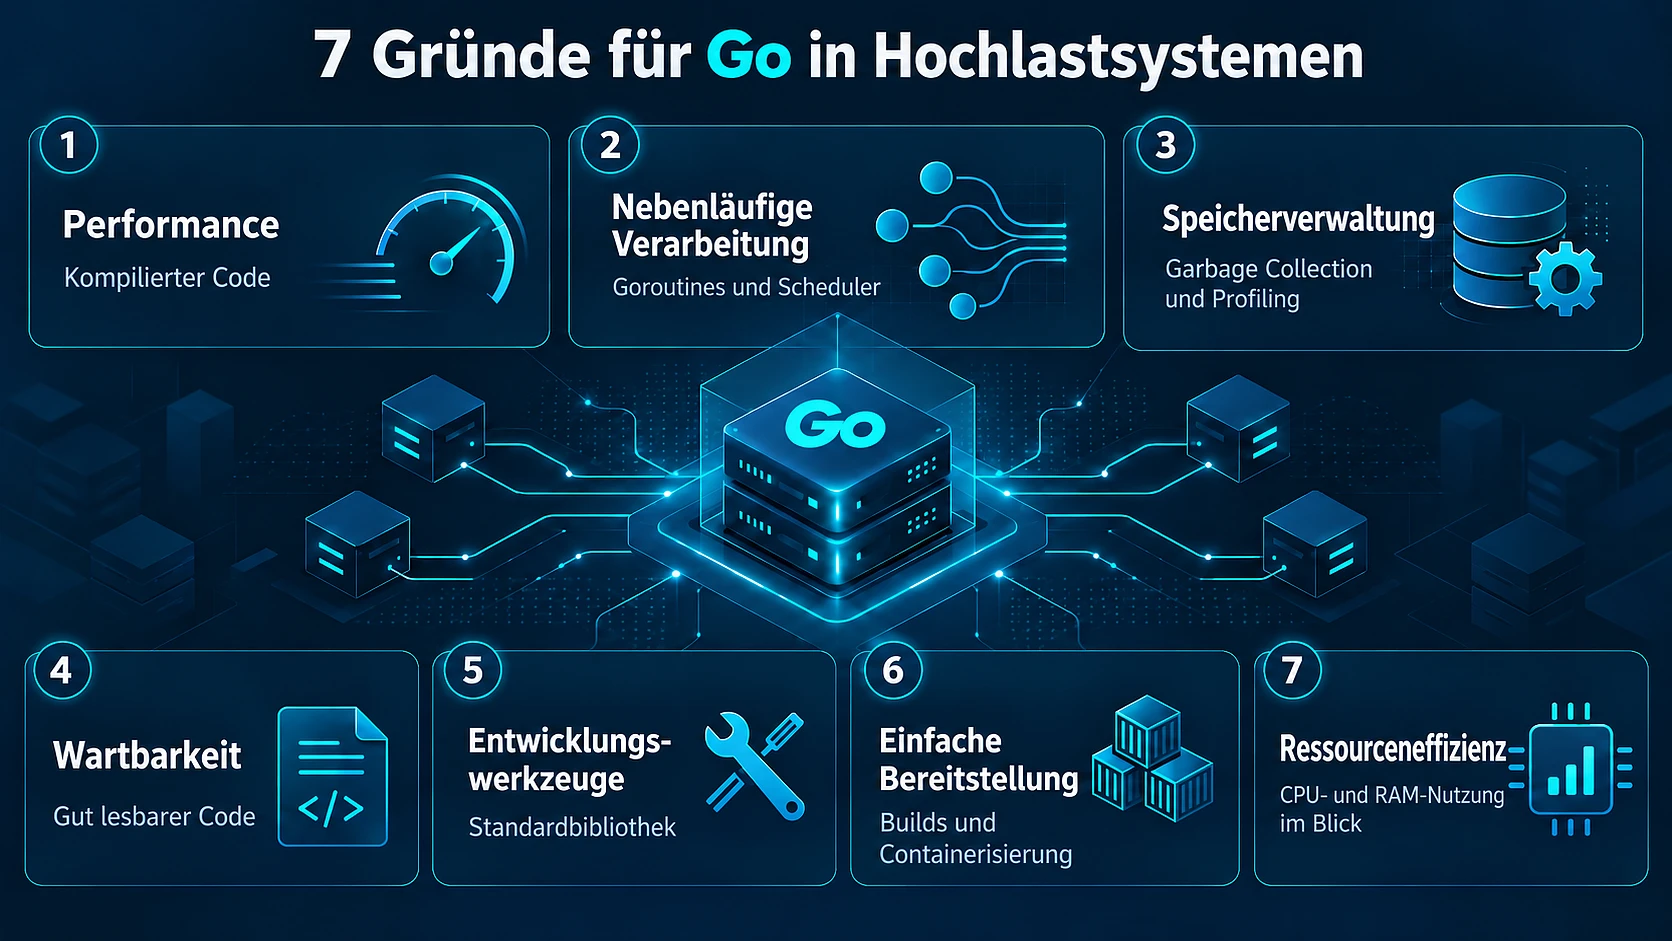
Sieben Gründe, warum Entwicklungsteams Go wählen
Go verbindet kompilierte Ausführung, ressourcensparende Nebenläufigkeit und integrierte Betriebswerkzeuge. Zusammen machen diese Eigenschaften die Sprache zu einer praktischen Option für Netzwerkdienste. Ihr wirtschaftlicher Nutzen hängt davon ab, ob sie in der konkreten Anwendung Ressourcenbedarf oder Wartungsaufwand senken.
Veröffentlichte Erfahrungsberichte zum Go-Einsatz liefern Kontext: Google entwickelte die Sprache, Cloudflare beschreibt ihren Einsatz in der Netzwerkinfrastruktur, und Dropbox berichtet über die Umstellung leistungskritischer Backends von Python. Auch ByteDance berichtet über einen umfangreichen Einsatz für Microservices. Diese Beispiele zeigen die Eignung für bestimmte Arbeitslasten. Sie belegen keinen universellen Branchenstandard.
- Leistung - kompilierter Code. Go kompiliert zu nativem Maschinencode. Das unterstützt eine effiziente Verarbeitung von Anfragen. Wartezeiten auf die Datenbank und algorithmische Komplexität bestimmen jedoch weiterhin einen großen Teil der Latenz eines Endpunkts.
- Nebenläufige Verarbeitung - Goroutines und Scheduler. Goroutines lassen Dienste unabhängige Vorgänge überlappend bearbeiten, ohne jeder Aufgabe einen eigenen Betriebssystem-Thread zuzuweisen. Teams müssen die Zahl laufender Aufgaben trotzdem ausdrücklich begrenzen.
- Speicherverwaltung - Garbage Collection und Profiling. Die automatische Speicherfreigabe vereinfacht die Verantwortung für Speicher. Der Leitfaden zum Go Garbage Collector erläutert den Zielkonflikt zwischen CPU- und Speicherbedarf: Häufigere Bereinigung kann das Heap-Wachstum reduzieren, erhöht aber den Bereinigungsaufwand. Allokationsprofile machen diesen Zielkonflikt messbar.
- Wartbarkeit - lesbarer Code. Einheitliche Formatierung und expliziter Kontrollfluss helfen Entwicklern, unbekannte Dienste zu prüfen. Laut einem veröffentlichten Erfahrungsbericht von Capital One schrieb das Team innerhalb eines Monats Go-Endpunkte. Das ist die Erfahrung eines Teams, kein Versprechen für die Einarbeitung.
- Entwicklungswerkzeuge - Standardbibliothek. Go bietet HTTP-Unterstützung und eine einheitliche Toolchain für Tests, Benchmarks und Profiling. American Express hebt diese integrierten Werkzeuge in seinem veröffentlichten Go-Erfahrungsbericht hervor. Gemeinsame Werkzeuge verringern Unterschiede zwischen Repositories.
- Einfache Bereitstellung - Builds und Containerisierung. Viele reine Go-Dienste lassen sich als einzelne, statisch gelinkte ausführbare Datei ausliefern. Builds mit cgo, das Go mit C-Code verbindet, können native Abhängigkeiten mitbringen. Container-Images benötigen weiterhin die Zertifikate und Laufzeitdateien, die die Anwendung verwendet.
- Ressourceneffizienz - CPU und RAM steuern. Profiling und Laufzeiteinstellungen helfen Teams, den Verbrauch zu kontrollieren. PayPal berichtet in einer veröffentlichten Fallstudie von etwa 10 % weniger CPU-Verbrauch in seinen gezielt gesteuerten Go-Umgebungen. Dieses vom Unternehmen gemeldete Ergebnis gilt für diese Umgebungen und ist kein sprachübergreifender Benchmark.
„Bei Hochlastsystemen kommt es nicht allein auf die Ausführungsgeschwindigkeit des Codes an. Entscheidend ist vielmehr, wie sich das System bei Lastspitzen verhält, wie vorhersehbar es Ressourcen nutzt und wie schnell das Team Probleme erkennen und beheben kann. Go eignet sich für viele dieser Anwendungsfälle. Die endgültige Technologieentscheidung treffen wir jedoch immer auf Grundlage der Systemanforderungen und konkreter Messergebnisse.“
Wie Go nebenläufige Aufgaben verarbeitet
Wer von Golang Nebenläufigkeit spricht, meint vor allem Goroutines. Das sind Funktionen, die die Laufzeitumgebung auf Betriebssystem-Threads einplant. Channels und Synchronisationsprimitive koordinieren ihre Arbeit. Das erleichtert überlappende I/O-Vorgänge. Abbruchmechanismen und Kapazitätsgrenzen müssen Entwickler jedoch ausdrücklich vorsehen.
Goroutines und der G-M-P-Scheduler
Der Scheduler nutzt drei Konzepte: G steht für eine Goroutine, M für einen Betriebssystem-Thread und P für die Ausführungsressourcen, die Go-Code benötigt. GOMAXPROCS steuert die Anzahl der Ps und damit, wie viele Threads Go-Code gleichzeitig ausführen können.
Bei unterstützten Netzwerk-I/O-Vorgängen kann die Laufzeitumgebung eine wartende Goroutine parken und die Ausführungskapazität für andere Aufgaben nutzen. Blockierende Systemaufrufe und cgo-Aufrufe können Threads belegen. Deshalb entspricht die Anzahl der Goroutines keiner festen Thread-Anzahl. Nebenläufigkeit lässt Aufgaben überlappen, während Parallelität Aufgaben gleichzeitig ausführt.
Channels, Mutexes und Abbruch
Channels eignen sich dafür, Arbeit oder Zuständigkeit zwischen Verarbeitungsstufen zu übertragen. Der offizielle Artikel zu Nebenläufigkeitsmustern in Go erläutert Pipelines und Abbruchmechanismen. Er erklärt auch, warum Produzenten stoppen können müssen, wenn Konsumenten ihre Arbeit beenden.
- Channels: koordinieren die Arbeitsverteilung und Fan-out/Fan-in-Pipelines.
- Mutexes: schützen gemeinsam genutzten Zustand.
RWMutexerlaubt gleichzeitige Lesezugriffe, wenn dieses Zugriffsmuster Vorteile bringt. - WaitGroup: wartet, bis eine Gruppe von Goroutines abgeschlossen ist.
- Context: gibt Fristen und Abbruchsignale an Vorgänge weiter, die diese unterstützen.
Ein Data Race entsteht, wenn Goroutines ohne geeignete Synchronisation auf denselben Speicher zugreifen und mindestens ein Zugriff schreibt. Eine Race Condition ist ein Korrektheitsfehler durch eine unkontrollierte Reihenfolge von Ereignissen. Führen Sie go test -race aus, um Data Races in ausgeführten Codepfaden zu erkennen. Testen Sie die fachlich richtige Reihenfolge separat.
Die Übergabe eines Context stoppt die Arbeit nicht automatisch. Datenbanktreiber und Request-Handler müssen Abbruchsignale beachten. Auch kann der Abbruch einer Zahlungsanfrage keine Zahlung rückgängig machen, die ein externer Anbieter bereits angenommen hat.
Ein begrenzter Worker-Pool
Dieses Grundgerüst begrenzt sowohl aktive Worker als auch wartende Jobs. Die Anzahl der Worker und die Puffergröße sind beispielhafte Konfigurationswerte, keine Kapazitätsempfehlungen. Der Handler ist für die Ergebnisse der Jobs verantwortlich und muss Abbruchsignale beachten.
package workers

import (
    "context"
    "sync"
)

type Job struct {
    ID string
}

func Run(
    ctx context.Context,
    input []Job,
    handle func(context.Context, Job),
) error {
    const workers = 8
    jobs := make(chan Job, 16)
    var wg sync.WaitGroup

    for i := 0; i < workers; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            for {
                select {
                case <-ctx.Done():
                    return
                case job, ok := <-jobs:
                    if !ok || ctx.Err() != nil {
                        return
                    }
                    handle(ctx, job)
                }
            }
        }()
    }

enqueue:
    for _, job := range input {
        select {
        case <-ctx.Done():
            break enqueue
        case jobs <- job:
        }
    }

    close(jobs)
    wg.Wait()
    return ctx.Err()
}
Ein voller Channel blockiert den Produzenten und erzeugt innerhalb dieser Funktion Backpressure. Ein HTTP-Dienst benötigt zusätzlich eine Zulassungssteuerung, damit blockierte Request-Handler nicht zu einer unbegrenzten vorgelagerten Warteschlange werden. Dieses Beispiel übernimmt ein vorhandenes Eingabe-Slice. Es begrenzt daher nicht den Speicher, den diese Eingabe belegt.
- Goroutine-Leaks: blockierte Sendevorgänge oder verwaiste Verbindungen halten Aufgaben am Leben, nachdem die Aufrufer nicht mehr warten.
- Deadlocks: Worker warten unbegrenzt auf unvereinbare Sperr- oder Channel-Operationen.
- Starvation: lang laufende Jobs verhindern, dass andere Aufgaben vorankommen.
- Unbegrenzter Fan-out: jede Anfrage startet weitere Aufgaben, bis die nachgelagerte Kapazität erschöpft ist.
Für welche Backend-Systeme eignet sich Go?
Für skalierbare Backend-Systeme eignet sich Go vor allem bei Diensten, die viele unabhängige Vorgänge koordinieren. Das gilt besonders, wenn Anfragen viel Zeit mit dem Warten auf I/O verbringen. Damit ist Go für stark frequentierte Anwendungen ein sinnvoller Kandidat für APIs und Worker. Die Eignung hängt weiterhin vom Verhalten der Abhängigkeiten und den betrieblichen Anforderungen ab.
- HTTP-APIs mit hohem Durchsatz: verarbeiten gleichzeitige Anfragen mit expliziten Fristen und begrenzten Datenbankzugriffen.
- gRPC-Dienste: tauschen typisierte Nachrichten zwischen internen Diensten aus und geben Fristen über Aufrufe hinweg weiter.
- Ereignisgesteuerte Worker: verarbeiten Kafka-Ereignisse mit einer Rate, die zur nachgelagerten Kapazität passt.
- Mandantenfähige SaaS-Backends: setzen Grenzen pro Mandant, damit die Arbeitslast eines Kunden nicht die gemeinsame Kapazität aufbraucht.
- Integrations- und Gateway-Dienste: koordinieren externe APIs mit Zeitlimits und kontrollierten Wiederholungsversuchen.
- FinTech- und Trading-Dienste: unterstützen netzwerkbasierte Abläufe, bei denen gleichmäßige Latenzen wichtig sind. American Express berichtet über den Go-Einsatz in Zahlungs- und Bonusnetzwerken.
Diese Arbeitslasten überschneiden sich mit Webdelos B2B-Plattformen, ERP/CRM-Integrationen und FinTech-Anwendungen. Unsere Architekturdiskussion beginnt beim kritischen Geschäftsvorgang und seinen Abhängigkeiten. Bei harten Echtzeitanforderungen müssen Gos Garbage Collector und die allgemein ausgelegte Laufzeitumgebung gesondert geprüft werden.
Go im Vergleich mit Java, Node.js, Python und PHP
Keine Backend-Sprache gewinnt jeden Vergleich. Go bietet ein kompaktes Nebenläufigkeitsmodell und eine einfache Bereitstellung von Diensten. Andere Stacks können ein stärkeres Ökosystem bieten oder besser zu dem Team passen, das bereits für das Produkt verantwortlich ist.
| Stack | Stärken | Grenzen | Typische Einsatzbereiche | Wann sinnvoll |
|---|---|---|---|---|
| Go | Leichtgewichtige Nebenläufigkeit, native Kompilierung, integrierte Diagnosewerkzeuge. | Zielkonflikte bei der Garbage Collection und expliziter Code zur Verbindung von Anwendungskomponenten. Weniger Spezialbibliotheken in manchen Bereichen. | Netzwerk-APIs, Gateways, Hintergrund-Worker, Infrastrukturdienste. | Wenn nebenläufige Dienste von begrenztem Ressourcenverbrauch und einfacher Bereitstellung profitieren. |
| Java | Ausgereifte Enterprise-Frameworks, JVM-Diagnostik, breite Integrationsunterstützung. | Die Konfiguration von Laufzeitumgebung und Framework kann den Betrieb komplexer machen. | Unternehmensplattformen, transaktionale Systeme, etablierte JVM-Dienste. | Wenn Team und Architektur bereits vom JVM-Ökosystem profitieren. |
| Node.js | Produktive JavaScript/TypeScript-Entwicklung und asynchrones I/O. | CPU-intensive Arbeit kann die Ereignisschleife blockieren, wenn sie nicht ausgelagert wird. | Web-APIs, Backend-for-Frontend-Dienste, Echtzeitintegrationen. | Wenn ein erfahrenes JavaScript-Team ein I/O-lastiges Produkt betreut. |
| Python | Umfangreiche Daten- und ML-Bibliotheken, ausdrucksstarke Anwendungsentwicklung. | CPU-intensive Python-Codepfade benötigen oft native Bibliotheken oder Parallelität auf Prozessebene. | ML-Dienste, Analytik, Automatisierung, Webanwendungen. | Wenn Spezialbibliotheken und Datenworkflows den Produktwert bestimmen. |
| PHP | Ausgereifte Web-Frameworks und etablierte anfrageorientierte Entwicklung. | Langlebige Worker und nebenläufige Dienste erfordern eine gezielte Wahl der Laufzeitumgebung. | Geschäftliche Webanwendungen, E-Commerce, Content-Plattformen. | Wenn bestehende Anwendung und Team im PHP-Ökosystem produktiv arbeiten. |
Dieser Vergleich ist kontextabhängig: Implementierungen, Frameworks und das Verhalten von Abhängigkeiten sind wichtiger als eine Rangliste der Sprachen. Ein ausgereifter Dienst mit durchdachten Datenbankzugriffen kann einen schlecht konzipierten Ersatz unabhängig von dessen Sprache übertreffen.
Beispielarchitektur eines Hochlastsystems mit Go
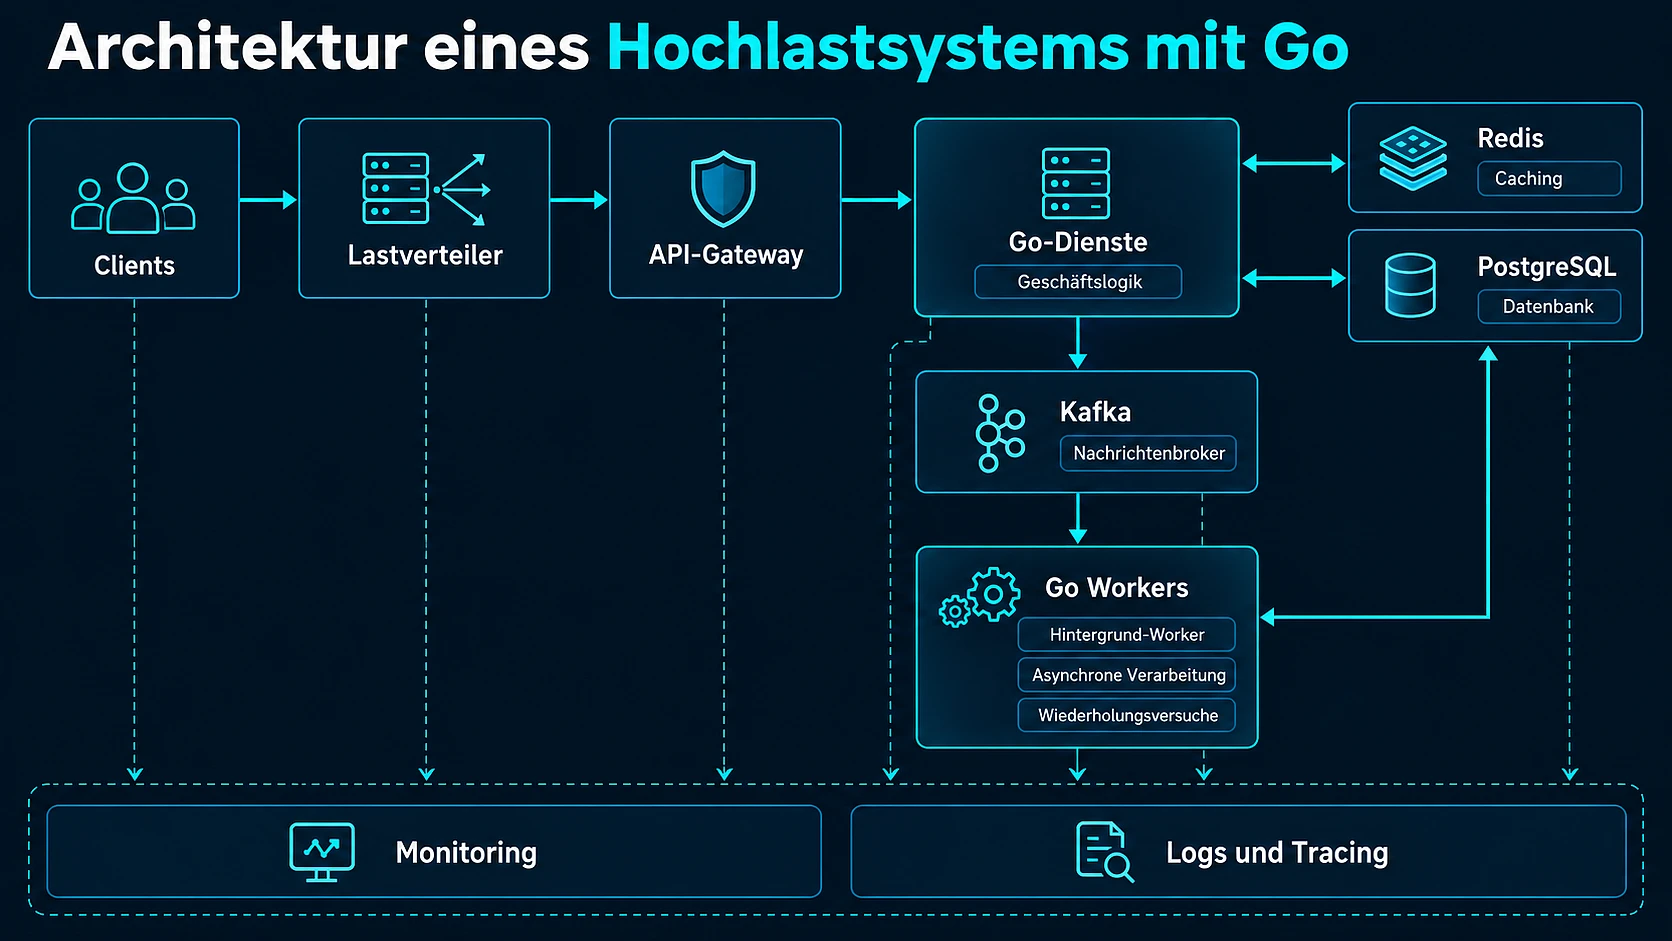
Ein konzeptionelles Bestellverarbeitungssystem leitet Clients über einen Load Balancer und ein API-Gateway zu Go-Diensten. Diese greifen direkt auf Redis und PostgreSQL zu, während Kafka Ereignisse an Go-Worker übermittelt. Das Diagramm zeigt eine mögliche Architektur, keine vermessene Kundenarchitektur.
Das Beispiel zeigt, wo Go für Microservices und Go für verteilte Systeme seine Stärken ausspielt: kleine Dienste mit klarer Zuständigkeit, schneller Start neuer Instanzen und eine einheitliche Toolchain für die Diagnose. Jede neue Dienstgrenze bringt jedoch zusätzliche Netzwerkaufrufe mit sich.
Anfragepfad und Datenspeicherung
Zustandslose Go-API-Instanzen bearbeiten Anfragen hinter dem Gateway. Interne Dienste können über gRPC kommunizieren und Fristen weiterreichen. Horizontale Skalierung erhöht die API-Kapazität nur, solange gemeinsam genutzte Abhängigkeiten weitere Arbeit aufnehmen können.
Redis liefert häufig gelesene Daten aus dem Cache, während PostgreSQL die maßgebliche Datenquelle bleibt. Jeder Client-Pool benötigt eine explizite Verbindungsgrenze. Das Budget für Datenbankverbindungen muss sämtliche Dienstreplikate berücksichtigen, einschließlich vorübergehender Überschneidungen bei Deployments.
Auch das Cache-Verhalten braucht einen Plan für den Fehlerfall. Wenn beliebte Einträge gleichzeitig ablaufen, kann eine Flut von Leseanfragen PostgreSQL erreichen. Das Zusammenfassen gleichartiger Anfragen oder die Auslieferung vertretbar veralteter Daten kann diesen Druck verringern.
Ereignisse und zuverlässige Verarbeitung
Logisch betrachtet veröffentlicht die API Bestellereignisse in Kafka. Damit zwischen Datenbank-Commit und Veröffentlichung kein Ereignis verloren geht, schreibt das Outbox-Pattern Bestellung und Ereignisdatensatz in einer PostgreSQL-Transaktion. Ein Relay veröffentlicht diesen Datensatz anschließend in Kafka.
Worker bearbeiten Zahlungen, Benachrichtigungen und Integrationen. Wiederholte Zustellversuche können Duplikate erzeugen. Deshalb brauchen Konsumenten Idempotenz: Die erneute Verarbeitung desselben Ereignisses darf dessen geschäftliche Wirkung nicht wiederholen. Bei Zahlungen muss dieser Schutz auch die Anfrage an den Zahlungsanbieter abdecken.
Wiederholungsversuche brauchen eine begrenzte Anzahl und Wartezeiten zwischen den Versuchen. Fehlgeschlagene Ereignisse benötigen außerdem eine Ablage zur späteren Wiederverarbeitung und einen betrieblich Verantwortlichen. Eine Warteschlange kann eine vorübergehende Lastspitze abfangen, aber keinen dauerhaften Kapazitätsmangel beheben.
Observability und Herunterfahren
Prometheus-Metriken erfassen die Auslastung der Dienste und Verarbeitungsrückstände in Warteschlangen. Strukturierte Logs erklären einzelne Fehler. OpenTelemetry-Traces verfolgen Anfragen über Dienstgrenzen hinweg. Zusammen zeigen diese Signale, ob Verzögerungen im Anwendungscode oder in Abhängigkeiten entstehen.
In Kubernetes nehmen Readiness-Prüfungen nicht verfügbare Instanzen aus dem Routing. Geordnetes Herunterfahren stoppt die Annahme neuer Arbeit und gibt laufenden Aufgaben ein begrenztes Zeitfenster zum Abschluss. Liveness-Prüfungen sollten gesunde Prozesse nicht allein deshalb neu starten, weil eine gemeinsame Abhängigkeit vorübergehend nicht verfügbar ist.
Warum Go allein keine hohe Performance garantiert
Wer über Golang Performance spricht, meint oft nur die Geschwindigkeit der Sprache. Die Backend-Leistung mit Go hängt jedoch von Datenbankzugriffen, Speicherallokationen und dem Umgang mit Überlast ab. Ein Sprachwechsel beseitigt keine architektonischen Engpässe. Unsere Empfehlung: Ermitteln Sie zuerst, wo Zeit und Ressourcen verbraucht werden, bevor Sie eine Neuentwicklung vorschlagen.
Ein N+1-Abfragemuster lädt eine Liste und führt anschließend für jedes Element eine weitere Abfrage aus. Das vervielfacht die Datenbankzugriffe in Go genauso wie in anderen Sprachen. Gebündelte Abfragen und geeignete Indizes lösen das Problem oft direkt. Dasselbe Prinzip gilt für große Schreibvorgänge; unsere Praxismuster beschreibt der Artikel zu Bulk Inserts in PostgreSQL mit Go.
Codepfade mit vielen Allokationen erhöhen den Aufwand für die Garbage Collection und können die Latenzen am oberen Ende der Verteilung beeinflussen. Die Go-Dokumentation zur Diagnostik beschreibt Profiling- und Tracing-Werkzeuge, mit denen sich diese Kosten lokalisieren lassen. Nutzen Sie CPU- und Allokationsprofile, bevor Sie Puffer wiederverwenden oder sync.Pool einführen. Auch das Datenlayout zählt, wie unser Beitrag zur Speicherausrichtung in Go zeigt.
GOMEMLIMIT setzt eine weiche Grenze für den von der Laufzeitumgebung verwalteten Speicher. Es ist keine feste Obergrenze für den gesamten Prozessspeicher. Native Allokationen und anderer Speicher außerhalb der Laufzeitumgebung benötigen separate Reserven. Ein zu enges Limit kann übermäßig häufige Speicherbereinigung erzwingen.
Auch bei Überlast muss das Verhalten klar definiert sein. Begrenzen Sie Warteschlangen und weisen Sie überschüssige Arbeit ab, bevor sich Zeitüberschreitungen über Abhängigkeiten ausbreiten. Realistische Lasttests sollten langsame Antworten nachgelagerter Dienste und die Erholung nach einer Lastspitze einschließen. Gleichmäßiger Datenverkehr allein macht diese Fehlerbilder nicht sichtbar.
Wann Go nicht die richtige Wahl ist
Go ist weniger geeignet, wenn die Migrationskosten den betrieblichen Nutzen übersteigen oder die zentrale Arbeitslast von einem anderen Ökosystem abhängt. Eine leistungsfähige bestehende Plattform verdient einen auf Messungen gestützten Verbesserungsplan. Eine bevorzugte Programmiersprache reicht als Begründung für einen Ersatz nicht aus.
- Ausgereifte JVM-Architektur: etablierte Spring-Integrationen und erfahrene Betriebsteams können wertvoller sein als eine neue Laufzeitumgebung.
- Python-basierte ML- und Datenworkflows: Spezialbibliotheken bestimmen oft die Architektur. Go kann die umgebenden Netzwerkdienste übernehmen, ohne die Modellentwicklung zu ersetzen.
- Ein überschaubares MVP: das Framework des bestehenden Teams kann validiertes Produktverhalten mit geringerem Implementierungsrisiko liefern.
- Eine nicht ausreichend begründete Neuentwicklung: eine Migration erfordert Funktionsgleichheit, die Umschulung des Betriebsteams und einen risikobehafteten Rollout, bevor ein Nutzen entsteht.
Wenn eine Komponente einen gemessenen Engpass aufweist, prüfen wir bevorzugt eine gezielte Auslagerung, bevor wir alles neu entwickeln. Die Schnittstelle muss stabil genug für unabhängige Tests sein. Andernfalls kann ein weiterer Dienst zusätzliche Netzwerkfehler verursachen, ohne die ursprüngliche Begrenzung zu beseitigen.
Wann sich der Einsatz von Go lohnt
Bei Webdelo beginnt der Go-Einsatz mit Anforderungen und Messergebnissen. Wir strukturieren die Entscheidung anhand einer Ausgangsmessung, eines gezielten Experiments und einer schrittweisen Einführung. So bleiben Architekturdiskussionen an geschäftliche Ergebnisse gebunden.
- Ausgangslage erfassen. Messen Sie Durchsatz, p95/p99-Latenz, Fehler, CPU- und Speicherverbrauch für kritische Vorgänge. Trennen Sie normale Nachfrage vom Verhalten bei Lastspitzen.
- Engpass finden. Unterscheiden Sie mit Profiling und Traces zwischen Berechnungen, Datenbankwartezeiten und Wartezeiten in Warteschlangen.
- Alternativen vergleichen. Beziehen Sie Verbesserungen am bestehenden Stack ein. Eine geänderte Abfrage oder eine Grenze für Nebenläufigkeit kann das Problem ohne Migration lösen.
- Einen gezielten Machbarkeitsnachweis entwickeln. Implementieren Sie einen repräsentativen Ablauf mit realistischer Authentifizierung, Serialisierung und Aufrufen von Abhängigkeiten.
- Realistische Lasttests durchführen. Bilden Sie Lastspitzen, Datenmengen und Ausfälle nachgelagerter Dienste nach. Vergleichen Sie Implementierungen unter gleichen Ressourcengrenzen und Abnahmekriterien.
- Schrittweise einführen. Beobachten Sie geschäftliche Ergebnisse neben technischen Metriken. Halten Sie ein Rollback praktikabel, einschließlich der Kompatibilität von Datenformaten und Schemata.
Ein Machbarkeitsnachweis ist nützlich, wenn er die vorgeschlagene Wahl widerlegen kann. Verbessert Go einen lokalen Benchmark, lässt aber den für Kunden spürbaren Engpass unverändert, hat das Experiment gezeigt, wo Entwicklungsaufwand sinnvoll ist.
Besprechen Sie Ihre Hochlastanforderungen und eine mögliche Go-Architektur mit dem Engineering-Team von Webdelo, um eine gezielte Evaluierung festzulegen. Wie wir solche Projekte umsetzen, beschreibt unsere Seite zur Go-Entwicklung.
Wählen Sie Go, wenn seine Stärken zur Arbeitslast passen
Go ist eine pragmatische Option für nebenläufige APIs und ereignisgesteuerte Worker. Sein Nutzen entsteht aus der Verbindung von Spracheigenschaften, solider Architektur und diszipliniertem Betrieb. Die Entscheidung sollte auf Erkenntnissen über das System beruhen, das Ihr Team betreiben muss.
Definieren Sie Erfolg anhand von Latenz und Zuverlässigkeit unter realistischer Last. Prüfen Sie die Kapazität der Abhängigkeiten und das Wiederherstellungsverhalten, bevor Sie den Rollout ausweiten. Behalten Sie den bestehenden Stack dort bei, wo er dem Produkt weiterhin gute Dienste leistet.
Häufig gestellte Fragen
Eignet sich Go für Anwendungen mit hohem Traffic?
Go eignet sich für viele Workloads mit hohem Traffic, besonders für HTTP- und gRPC-APIs, Gateways und ereignisgesteuerte Worker, deren Anfragen viel Zeit mit I/O-Wartezeiten verbringen. Kompilierter Code, leichtgewichtige Goroutines und eine einfache Bereitstellung helfen diesen Diensten, viele nebenläufige Operationen zu verarbeiten. Ob Go passt, hängt dennoch von der Datenbankkapazität, den nachgelagerten Abhängigkeiten und den betrieblichen Anforderungen ab. Bei harten Echtzeitanforderungen sollten Sie den Garbage Collector und die Laufzeitumgebung gesondert prüfen.
Wie schneidet Go im Vergleich zu Java und Node.js bei Backend-Diensten ab?
Der Vergleich hängt vom Kontext ab und ist keine Rangliste. Go bietet ein kompaktes Nebenläufigkeitsmodell, native Kompilierung und eine einfache Bereitstellung von Diensten. Java bringt ausgereifte Enterprise-Frameworks und JVM-Diagnosewerkzeuge mit, was zählt, wenn Team und Architektur bereits auf der JVM aufbauen. Node.js ermöglicht produktive Entwicklung mit JavaScript/TypeScript und asynchrones I/O, doch rechenintensive Aufgaben können die Event Loop blockieren, wenn sie nicht ausgelagert werden.
Wie begrenzt man die Nebenläufigkeit in einem Go-Dienst unter hoher Last?
Goroutines sind günstig, Datenbanken und externe APIs jedoch nicht. Deshalb braucht laufende Arbeit explizite Grenzen. Ein begrenzter Worker-Pool beschränkt sowohl aktive Worker als auch wartende Jobs, und ein voller Channel blockiert den Producer und erzeugt so Backpressure. HTTP-Dienste benötigen zusätzlich Admission Control, damit blockierte Handler keine unbegrenzte Warteschlange bilden. Geben Sie Deadlines und Abbruchsignale per Context weiter und stellen Sie sicher, dass Treiber und Handler sie tatsächlich berücksichtigen.
Wie verwaltet Go den Speicher in Hochlastdiensten?
Go nutzt eine automatische Garbage Collection, die CPU-Zeit gegen geringeres Heap-Wachstum abwägt: Häufigeres Sammeln spart Speicher, kostet aber mehr CPU. Allokationsintensive Codepfade erhöhen den GC-Aufwand und können die p99-Latenz verschlechtern. Nutzen Sie daher CPU- und Allokationsprofile, bevor Sie Puffer wiederverwenden oder sync.Pool einführen. GOMEMLIMIT setzt eine weiche Grenze für den von der Laufzeit verwalteten Speicher, keine harte Obergrenze für den gesamten Prozess. Native Allokationen, etwa über cgo, brauchen eigenen Spielraum.
Sollten wir ein bestehendes Backend auf Go migrieren?
Nur wenn Messungen zeigen, dass der Nutzen die Migrationskosten übersteigt. Erfassen Sie zunächst eine Baseline aus Durchsatz, p95/p99-Latenz, Fehlern, CPU und Speicher, lokalisieren Sie dann den tatsächlichen Engpass und vergleichen Sie Alternativen, einschließlich Verbesserungen im bestehenden Stack. Hat eine Komponente einen gemessenen Engpass, ist eine gezielte Auslagerung mit Proof of Concept und realistischen Lasttests meist sicherer als ein vollständiger Rewrite. Führen Sie die Änderung schrittweise ein und halten Sie ein Rollback praktikabel, auch bei Schema- und Datenformaten.
Warum verbessert ein Wechsel zu Go die Backend-Performance nicht automatisch?
Ein Sprachwechsel lässt architektonische Engpässe unverändert. N+1-Abfragen vervielfachen die Datenbank-Roundtrips in Go genauso wie in jedem anderen Stack, allokationsintensiver Code erhöht den GC-Druck, und unbegrenzte Warteschlangen verbreiten Timeouts bei Überlast über alle Abhängigkeiten. Erst Profiling und Lasttests mit Lastspitzen, langsamen nachgelagerten Diensten und der Erholung nach einem Peak zeigen, ob die neue Implementierung den Engpass tatsächlich beseitigt.