Mit Nachfrage, Geschäftsrisiken und messbaren Grenzen beginnen
Bei High Load brauchen Systeme technische Entscheidungen, die sich am tatsächlichen Bedarf und an den geschäftlichen Folgen orientieren. Wer skalierbare Systeme entwickelt, muss wissen, welche Ressourcen zuerst knapp werden, wie sich Ausfälle auf Nutzer auswirken und was zusätzliche Kapazität kostet. Die passende Architektur erfüllt diese Anforderungen, ohne eine Komplexität zu schaffen, die das Team nicht beherrschen kann.
Eine langsame Datenbankabfrage kann die Auftragsbearbeitung verzögern. Eine überlastete Integration kann die Einrichtung neuer Kundenkonten stoppen. Diese Probleme brauchen unterschiedliche Lösungen, selbst wenn ihre Dashboards ähnliche Anfrageraten zeigen.
Bei Webdelo reicht unser technischer Blick von der Architektur bis zur langfristigen Betreuung. Seit unserer Gründung im Jahr 2006 entwickeln wir B2B-Plattformen und komplexe Software, darunter ERP-/CRM-Systeme und Dienste für hohe Last. Unsere Arbeit im Bereich web entwicklung verbindet Produktanforderungen mit Umsetzung und Betrieb.
Dieser Leitfaden erklärt, wie wir Entwicklungsentscheidungen für Systeme unter hoher Last einordnen. Er behandelt die Diagnose von Engpässen, Architekturentscheidungen und die Nachweise, die vor einer Investition in Skalierung nötig sind. Die Beispiele dienen der Veranschaulichung. Aussagen über unsere Expertise beschränken sich auf dokumentierte Unternehmensfakten und veröffentlichte technische Beiträge.
Wann wird Nachfrage zum Architekturproblem?
Ein System steht unter hoher Last, wenn die Nachfrage seine praktischen Grenzen erreicht und die erforderliche Leistung oder Korrektheit gefährdet. Einen allgemeingültigen Schwellenwert für Anfragen pro Sekunde gibt es nicht. Entscheidend sind die Arbeit, die jede Anfrage auslöst, und das vom Unternehmen benötigte Serviceniveau.
Warum feste RPS-Schwellenwerte irreführen
Anfragen pro Sekunde, kurz RPS, messen das Verkehrsaufkommen. Sie beschreiben nicht die Komplexität der Transaktionen. Eine beispielhafte Checkout-API mit 200 RPS kann strengere Anforderungen an Konsistenz und Latenz haben als eine statische Website, die über ein Content Delivery Network 20.000 RPS bedient.
Gleichzeitige Verbindungen messen wiederum etwas anderes. Tausende weitgehend inaktive Verbindungen können wenig CPU beanspruchen und trotzdem Verbindungslimits oder den Arbeitsspeicher ausschöpfen. Die Kapazitätsplanung muss sowohl die Ankunftsrate als auch die Ressourcen berücksichtigen, die laufende Vorgänge belegen.
Datenintensive Plattformen verwenden einen großen Teil ihrer Ressourcen darauf, Daten zu speichern, abzurufen oder zu koordinieren. Rechenintensive Plattformen benötigen mehr Ressourcen für Berechnungen. Bei crm-systemen können Berichte und Synchronisierung bereits zu hoher Datenlast führen, lange bevor die Nutzerzahl außergewöhnlich erscheint.
Kennzahlen, die tatsächliche Belastung zeigen
Wir empfehlen, vor der Auswahl der Infrastruktur ein Lastprofil zu erstellen. Es sollte den normalen Bedarf, erwartete Spitzen und die Zusammensetzung der Vorgänge hinter diesen Zahlen beschreiben.
- Durchsatz: eingehende RPS und erfolgreich abgeschlossene Vorgänge, getrennt nach Nutzerablauf.
- Parallelität: aktive Anfragen, Sitzungen, Verbindungen und Hintergrundaufgaben.
- Latenz: p95- und p99-Antwortzeiten für wichtige Vorgänge.
- Fehler: Zeitüberschreitungen, abgewiesene Anfragen und fehlgeschlagene Geschäftstransaktionen.
- Sättigung: Belastung von CPU, Arbeitsspeicher, Datenträgern, Verbindungspools und Verarbeitungskapazität der Worker.
- Datenwachstum: gespeichertes Volumen, Größe des aktiv genutzten Datenbestands und Veränderungen beim Aufwand für Abfragen.
- Queue-Lag: Verarbeitungsrückstand und Alter noch nicht erledigter Aufgaben.
Die geschäftlichen Folgen bestimmen, welche Grenzen besonders wichtig sind. Ein verspäteter Analysebericht kann akzeptabel sein. Eine verzögerte Bestandsreservierung kann dagegen zu Überverkäufen führen. Beide brauchen klare Anforderungen statt einer gemeinsamen, plattformweiten durchschnittlichen Antwortzeit.
Was bricht bei steigendem Datenverkehr zuerst ein?
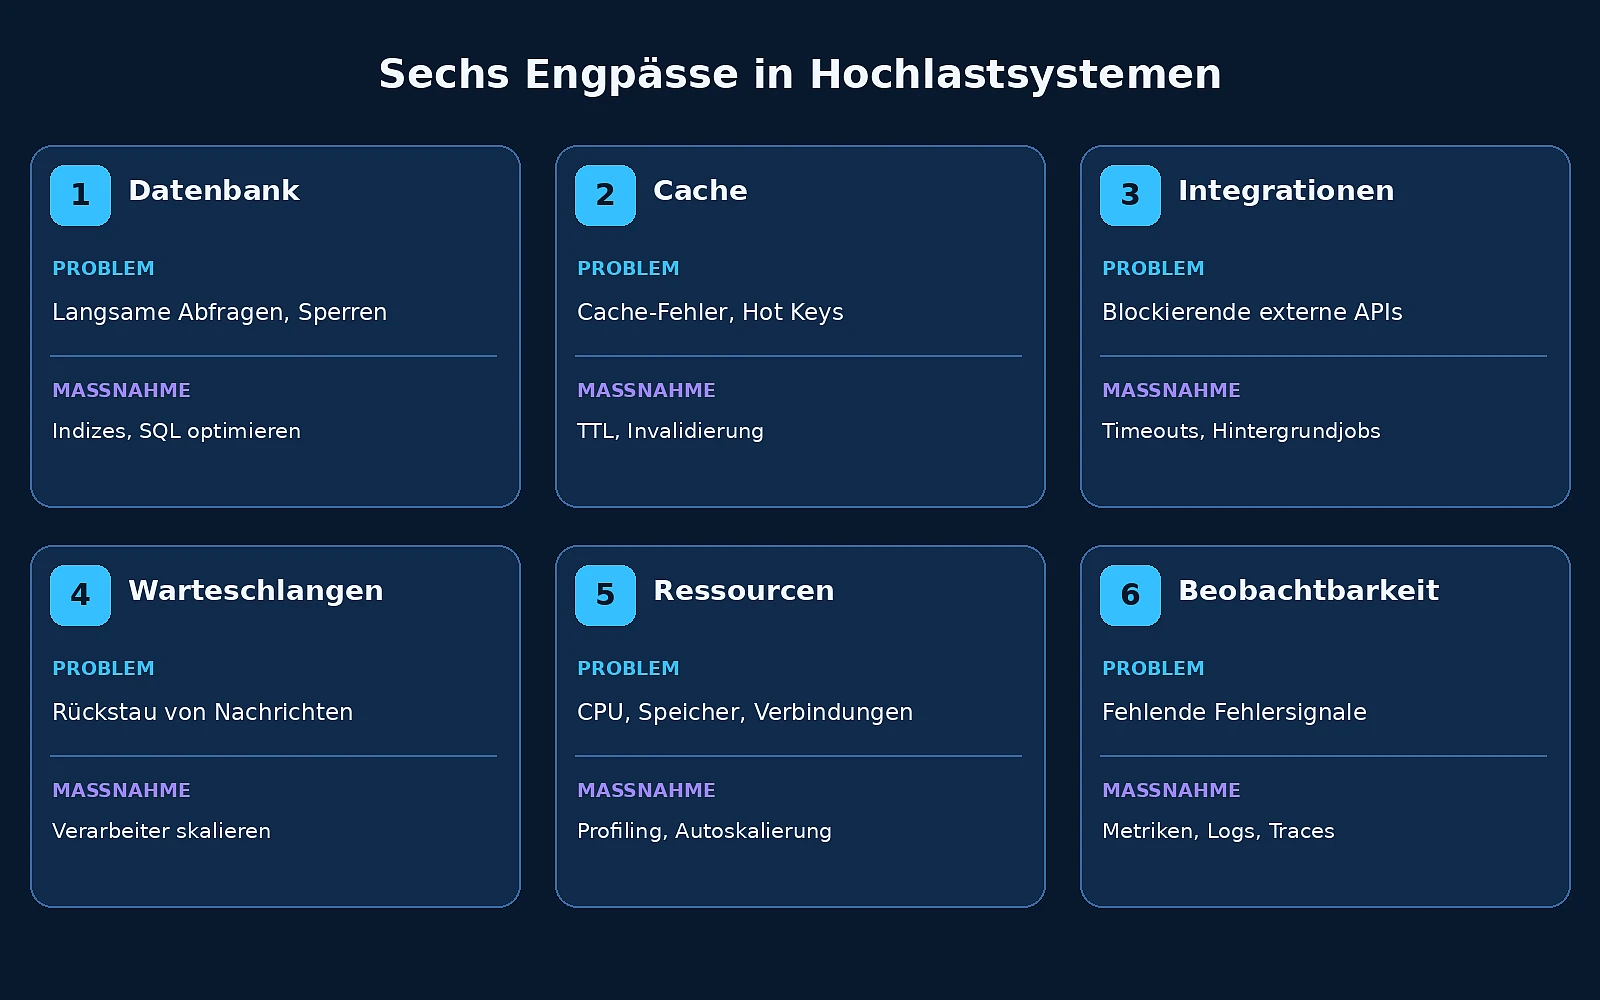
In transaktionsintensiven Systemen ist die Datenbank häufig der erste Engpass. Auch Cache-Ausfälle, synchrone Integrationen und wachsende Warteschlangen können die Kapazität ausschöpfen, bevor die CPU der Anwendung ausgelastet wirkt. Die Diagnose beginnt dort, wo Anfragen warten. Nicht jede Verlangsamung verlangt nach mehr Servern.
Wartezeiten in der Datenbank und knappe Verbindungen
Ein fehlender Index erhöht den Aufwand jeder Abfrage. Konkurrierende Sperren lassen Transaktionen aufeinander warten. Ein N+1-Abfragemuster macht aus einer Anwendungsanfrage viele einzelne Datenbankzugriffe.
Verbindungspools setzen eine weitere Grenze. Sind alle Verbindungen belegt, warten neue Anfragen auf einen freien Platz. Zusätzliche Anwendungsinstanzen können das Problem verschärfen, weil jede Instanz möglicherweise einen weiteren Pool zur selben Datenbank öffnet.
Cache-Fehlzugriffe und langsame Abhängigkeiten
Ein Cache Stampede entsteht, wenn viele Anfragen gleichzeitig denselben abgelaufenen Wert neu berechnen wollen. Die dadurch ausgelöste Datenbanklast kann ein System überfordern, das mit gefülltem Cache noch gesund wirkte.
Synchrone Integrationen halten eine Anfrage auf, bis ein anderer Dienst antwortet. Bei der entwicklung eines online-shops kann ein langsamer Anbieter für Versandtarife die Worker des Checkouts belegen, obwohl die eigene Datenbank des Shops problemlos arbeitet. Die Lösung beginnt mit einer festen Zeitüberschreitung und einem vereinbarten Ersatz- oder Fehlerablauf.
Rückstände, Ressourcengrenzen und blinde Flecken
Eine Warteschlange fängt vorübergehende Lastspitzen ab. Sie kann eine zu geringe Verarbeitungskapazität aber nicht unbegrenzt ausgleichen. Ein wachsender Rückstand verzögert Geschäftsvorgänge und gefährdet irgendwann Aufbewahrungs- oder Speichergrenzen.
Speicherengpässe und volle Datenträger können auch außerhalb des eigentlichen Anfragepfads entstehen. Ohne zusammenhängend auswertbare Telemetrie skalieren Teams möglicherweise Anwendungsserver, während der tatsächliche Engpass weiterhin eine gemeinsam genutzte Datenbank oder eine externe API ist.
Zentrale Bausteine einer skalierbaren Softwarearchitektur für verteilte Systeme
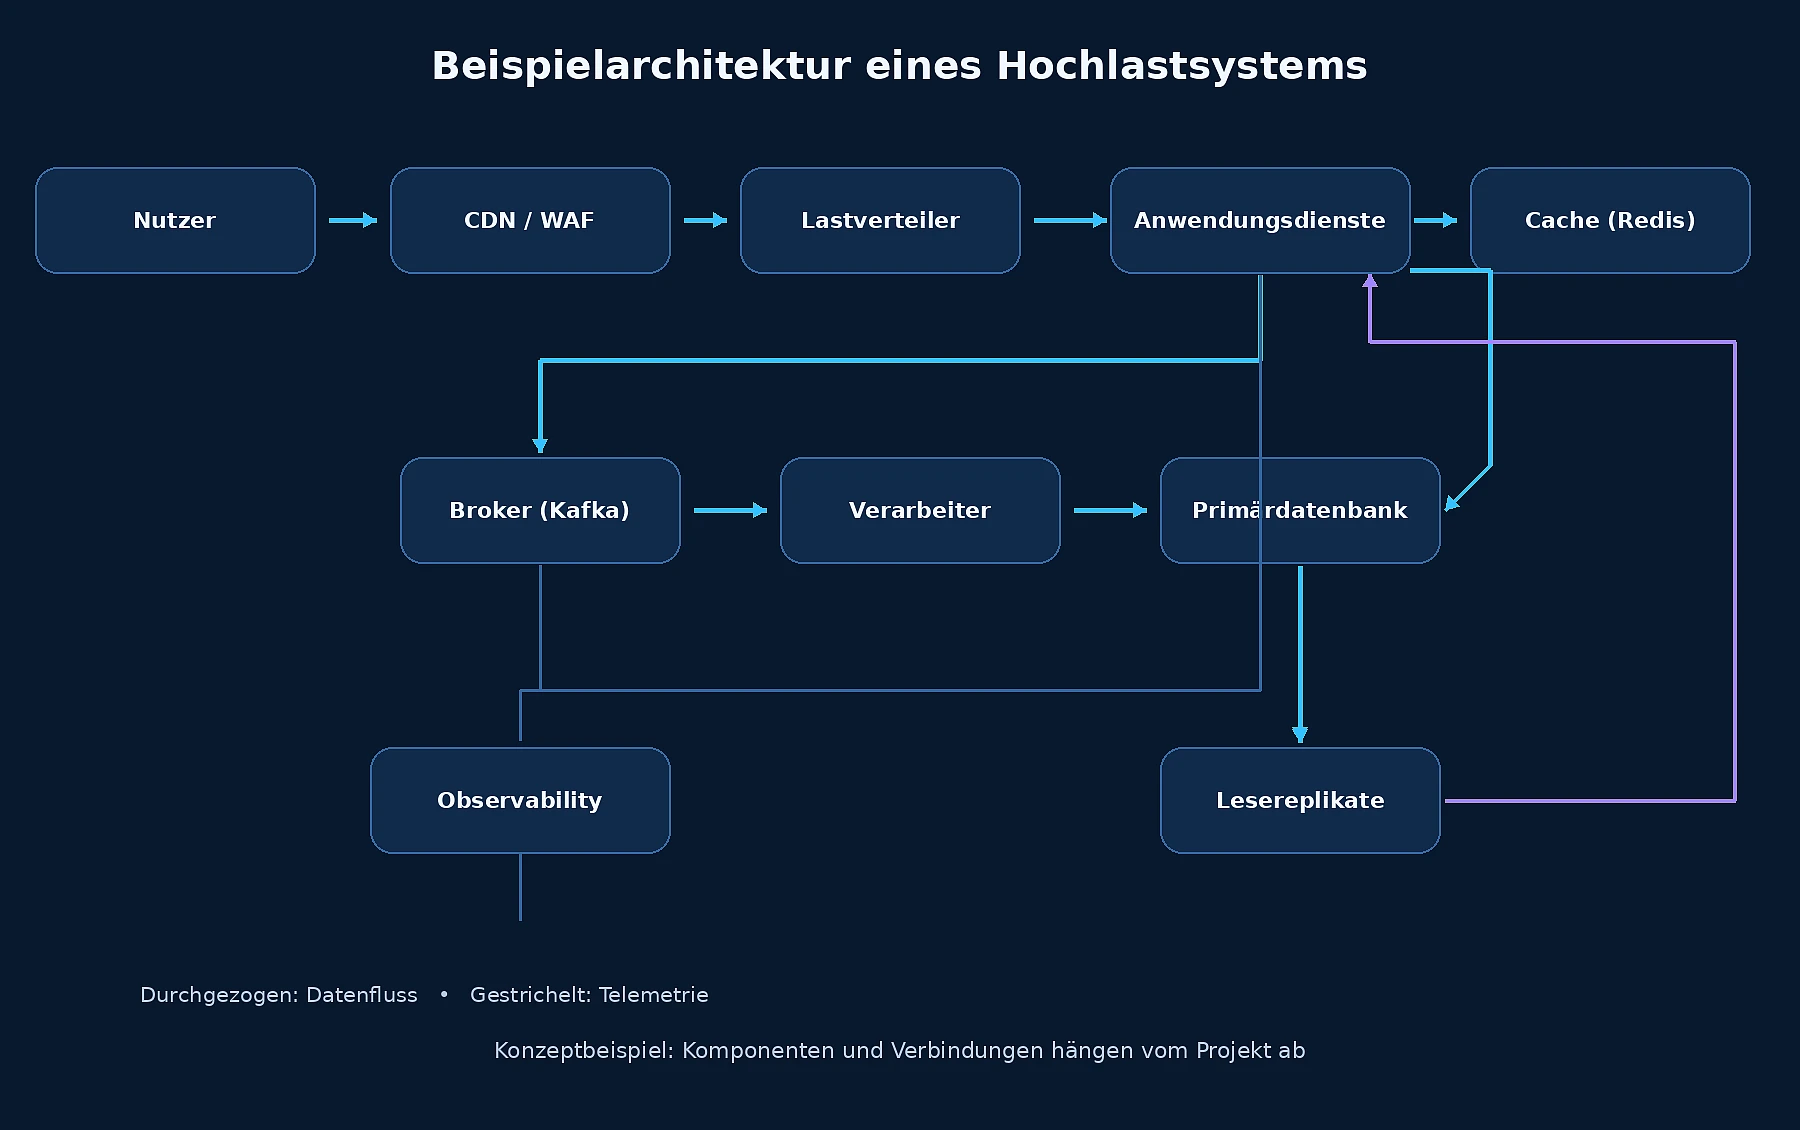
Eine skalierbare Softwarearchitektur verbindet üblicherweise die Steuerung des Datenverkehrs, die Verarbeitung in der Anwendung, die Datenspeicherung und Telemetrie. CDN/WAF, Load Balancer, zustandslose Dienste, Caches und Message Broker sind wiederverwendbare Bausteine. Jeder davon sollte ein konkretes Kapazitäts- oder Zuverlässigkeitsproblem lösen.
Der Kurs der Northwestern University zu skalierbarer Architektur beschreibt eine ähnliche Zusammenstellung von Komponenten hinter großen Internetdiensten. Das bekannte Modell aus Frontend, Backend und Datenbank bleibt ein sinnvoller Ausgangspunkt. Zusätzliche Schichten sollten klar abgegrenzte Aufgaben haben.
Edge, Lastverteilung und zustandslose Dienste
Ein Content Delivery Network, kurz CDN, liefert cachebare Inhalte in der Nähe der Nutzer aus. Eine Web Application Firewall, kurz WAF, filtert Anfragen anhand von Sicherheitsregeln. Beide ersetzen weder die Autorisierung auf Anwendungsebene noch den Schutz vor Missbrauch.
Ein Load Balancer verteilt eingehende Anfragen auf funktionsfähige Instanzen. Zustandslose Anwendungsinstanzen halten dauerhaft benötigte Sitzungsdaten außerhalb ihres lokalen Prozessspeichers. Dadurch kann eine andere Instanz die nächste Anfrage bearbeiten, ohne vom ursprünglichen Server abhängig zu sein.
Bei einer unternehmenswebsite lassen sich öffentliche Inhalte häufig umfassend zwischenspeichern. Kontoseiten für angemeldete Nutzer brauchen andere Cache-Regeln. Ein falscher Cache-Schlüssel kann personalisierte Inhalte offenlegen. Deshalb gehört die Caching-Strategie in die Sicherheitsprüfung.
Daten, Verarbeitung und Telemetrie
PostgreSQL kann transaktionale Schreibzugriffe über eine primäre Datenbank abwickeln. Lesereplikate können geeignete Lesezugriffe übernehmen. Redis kann häufig wiederverwendete Ergebnisse speichern, während Kafka oder RabbitMQ Aufgaben an Hintergrund-Consumer weitergeben.
Metriken, Logs und Traces verbinden diese Schichten im Betrieb. Die Komponentenübersicht sollte auch Verantwortlichkeiten und das Verhalten bei Fehlern festhalten. Dokumentieren Sie für jede Abhängigkeit, was passiert, wenn sie langsam, nicht verfügbar oder inkonsistent wird.
Jede zusätzliche Komponente erzeugt Betriebsaufwand. Klären Sie vor ihrer Einführung, wer sie aktualisiert, überwacht und ihre Daten wiederherstellt. Ein Diagramm, das diese Aufgaben auslässt, stellt die Kosten der Architektur zu niedrig dar.
Monolith, modularer Monolith oder Microservices-Architektur?
Der stärkste Grund für eine Microservices-Architektur ist der Bedarf an unabhängiger Verantwortung, Bereitstellung oder Skalierung. Ein modularer Monolith behält eine gemeinsame Bereitstellung bei und schafft zugleich klare fachliche Grenzen. Wir empfehlen, anhand gemessener Einschränkungen und der Kapazität des Teams zwischen diesen Ansätzen zu wählen.
| Kriterium | Monolith | Modularer Monolith | Microservices |
|---|---|---|---|
| Bereitstellung | Ein gemeinsames Anwendungsrelease | Ein Release mit klaren internen Grenzen | Separate Releases einzelner Dienste |
| Unabhängige Skalierung | Skaliert üblicherweise als Ganzes | Skaliert bis zur Ausgliederung üblicherweise als Ganzes | Dienste können getrennt skalieren |
| Datenverantwortung | Häufig innerhalb der Anwendung geteilt | Je Modul festgelegt, auch innerhalb einer Datenbank | Je Dienst festgelegt, mit kontrolliertem Zugriff |
| Betriebsaufwand | Vergleichsweise gering | Überschaubare Infrastruktur mit Regeln für Modulgrenzen | Höhere Anforderungen an Netzwerk, Bereitstellung und Telemetrie |
| Passende Teamstruktur | Ein abgestimmtes Team | Ein Team oder mehrere eng abgestimmte Teams | Teams, die Dienste bis in den Produktionsbetrieb verantworten können |
| Fehlersuche | Überwiegend innerhalb eines Prozesses | Innerhalb eines Prozesses über klar definierte Schnittstellen | Über Netzwerkgrenzen und asynchrone Übergänge hinweg |
| Änderungsaufwand | Steigt mit interner Kopplung | Bleibt begrenzt, wenn Modulgrenzen eingehalten werden | Gering bei isolierten Änderungen, höher bei dienstübergreifenden Änderungen |
Warum wir zuerst klare Module empfehlen
Wir empfehlen, fachliche Grenzen festzulegen, bevor sie auf getrennte Dienste verteilt werden. Ein Bestellmodul sollte gezielt definierte Operationen bereitstellen, statt fachfremdem Code direkte Änderungen an seinen Tabellen zu erlauben. Das reduziert die Kopplung und erleichtert eine spätere Ausgliederung.
Auch ein modularer Monolith verlangt Disziplin. Gemeinsam genutzte Tabellen, zyklische Abhängigkeiten und uneingeschränkte interne Aufrufe können seine Vorteile zunichtemachen. Prüfungen der Modulgrenzen und Code-Reviews sind genauso wichtig wie die Ordnerstruktur.
Die Ausgliederung eines Dienstes wird attraktiver, wenn ein Modul ein anderes Lastprofil oder einen anderen Release-Rhythmus hat. In die Entscheidung gehören die Kosten für Rufbereitschaft und dienstübergreifende Konsistenz. Code aufzuteilen schafft allein noch keine Unabhängigkeit im Betrieb.
Ereignisgesteuertes Design über Bereitstellungsmodelle hinweg
Ereignisgesteuertes Design ist ein Kommunikationsmuster, kein konkurrierendes Bereitstellungsmodell. Ein Monolith kann Ereignisse an Hintergrund-Worker senden. Microservices können synchrone APIs, asynchrone Ereignisse oder beides nutzen.
Benachrichtigungen und Berichte vertragen häufig einen verzögerten Abschluss. Eine Bestandsbestätigung kann dagegen ein sofortiges Ergebnis verlangen. Wählen Sie das Interaktionsmuster für jeden Geschäftsvorgang einzeln. Legen Sie fest, was Nutzer sehen, solange die asynchrone Verarbeitung noch nicht abgeschlossen ist.
Datenbanken, Redis Cache und zuverlässige Nachrichtenverarbeitung
Die Datenschicht setzt praktische Grenzen für Durchsatz und Korrektheit. PostgreSQL Replikation kann Lesezugriffe auslagern, Redis-Caching wiederholte Arbeit vermeiden und Nachrichtenverarbeitung einzelne Verarbeitungsschritte entkoppeln. Diese Mechanismen bringen zugleich Risiken mit sich: veraltete Daten, verzögerte Abschlüsse und mehrfach zugestellte Nachrichten.
Wir empfehlen, Abfragepläne und den Umfang von Transaktionen zu prüfen, bevor zusätzliche Infrastruktur eingeführt wird. Webdelos veröffentlichter technischer Leitfaden zu Masseneinfügungen in PostgreSQL mit Go liefert ein konkretes Beispiel für die technische Gestaltung von Schreibzugriffen. Er bietet eine Grundlage für die fachliche Diskussion, ohne damit ein unveröffentlichtes Kundenergebnis oder einen Benchmark zu behaupten.
PostgreSQL-Primärdatenbank und Lesereplikate
Lesereplikate können gegenüber der Primärdatenbank zurückliegen. Aktualisiert ein Nutzer sein Konto und lädt es sofort neu, sieht er möglicherweise alte Daten, wenn der Lesezugriff an ein verzögertes Replikat geht. Leiten Sie konsistenzkritische Lesezugriffe an die Primärdatenbank oder verwenden Sie einen ausdrücklich dafür vorgesehenen Konsistenzmechanismus.
Replikate beseitigen den Schreibengpass der Primärdatenbank nicht. Verbindungspooling, effiziente Indizes und kürzere Transaktionen können mehr nutzbare Reserven schaffen. Partitionierung kann bei bestimmten Lastprofilen helfen, aber nur dann, wenn Abfragen und Wartungsvorgänge vom Partitionierungsschlüssel profitieren.
Gebündelte Schreibzugriffe reduzieren wiederholten Zusatzaufwand. Zu große Batches können jedoch Sperren länger halten und nach einem Fehler mehr Wiederherstellungsarbeit verursachen. Bestimmen Sie die Batch-Größe durch Tests mit repräsentativen Datensätzen und Transaktionsgrenzen.
Redis-Caching mit kontrolliertem Fehlerverhalten
Ein Cache braucht klare Regeln zur Aktualität. Legen Sie fest, welche Daten wie lange veraltet sein dürfen und wodurch sie ungültig werden. Für Kontostände und beschreibende Produktinhalte ist selten dieselbe Regel sinnvoll.
Zufällig variierte Ablaufzeiten reduzieren gleichzeitige Aktualisierungen. Durch Request Coalescing berechnet ein Worker einen fehlenden Wert neu, während andere sein Ergebnis mitverwenden. Beide Verfahren verringern die Belastung beim Erneuern von Cache-Einträgen.
Bei einem Cache-Ausfall muss das Fehlerverhalten begrenzt bleiben. Ein uneingeschränkter Rückgriff auf die Datenbank kann aus einem Cache-Problem einen Plattformausfall machen. Ratenbegrenzungen, zulässige veraltete Antworten und kontrollierte Ablehnungen können wichtige Transaktionen schützen.
Kafka, RabbitMQ und Idempotenz
Kafka eignet sich häufig für dauerhaft vorgehaltene Ereignisströme und deren erneute Verarbeitung. RabbitMQ eignet sich häufig für gezielt zugestellte Aufgaben und Arbeitswarteschlangen. Prüfen Sie Reihenfolge, Aufbewahrung und Consumer-Verhalten, bevor Sie allein wegen steigenden Datenverkehrs eine Kafka Message Queue wählen.
Viele praktisch eingesetzte Zustellkonfigurationen können Nachrichten erneut zustellen. Idempotenz bedeutet, denselben Vorgang erneut zu verarbeiten, ohne eine weitere geschäftliche Wirkung auszulösen. Ein Consumer kann dafür eine eindeutige Vorgangskennung in derselben Datenbanktransaktion speichern wie die Änderung, die er absichern soll.
Die AWS Builders' Library behandelt Wiederholungsversuche und robuste verteilte Systeme. Für die Praxis heißt das: Sichere Wiederholungen müssen sich an den geschäftlichen Auswirkungen orientieren. Eine Nachrichtenbestätigung allein beweist nicht, dass eine Zahlung oder Bestellung nur einmal verarbeitet wurde.
Wenn eine Datenbankänderung zugleich ein Ereignis veröffentlichen muss, kommt eine transaktionale Outbox infrage. Die Anwendung speichert die Änderung und einen Datensatz für das ausgehende Ereignis in einer Transaktion. Ein separater Publisher stellt das Ereignis zu. Die Consumer müssen weiterhin mit Duplikaten umgehen können.
Horizontale Skalierung und DevOps brauchen gemeinsame Kapazitätsgrenzen
Horizontale Skalierung ergänzt weitere Verarbeitungsinstanzen. Vertikale Skalierung gibt einer bestehenden Instanz mehr Ressourcen. Beide Ansätze sind sinnvoll. Skalierung funktioniert jedoch nur, wenn gemeinsam genutzte Abhängigkeiten und Bereitstellungsverfahren die zusätzliche Kapazität unterstützen können.
Anwendungsinstanzen können unabhängig skalieren, konkurrieren aber weiterhin um Datenbankverbindungen und Kontingente externer APIs. Legen Sie ein Gesamtbudget für Verbindungen fest, bevor Sie die Anzahl der Replikate erhöhen. Reservieren Sie Kapazität für Wartung und Wiederherstellung ebenso wie für den normalen Datenverkehr.
Die Kubernetes-Dokumentation beschreibt Mechanismen zur automatischen Skalierung von Workloads. Kubernetes beseitigt weder Startverzögerungen noch Grenzen nachgelagerter Systeme. Wählen Sie Skalierungssignale, die zum Lastprofil passen, etwa das Alter wartender Aufgaben bei der Hintergrundverarbeitung.
DevOps und Infrastruktur bei Webdelo sind Teil unserer Leistungen über den gesamten Entwicklungszyklus. Architekturentscheidungen brauchen automatisierte Bereitstellung und Einblick in den Produktionsbetrieb, damit das System auch bei wachsendem Produkt beherrschbar bleibt.
- Releases automatisieren: Erstellen und testen Sie reproduzierbare Artefakte, statt Server manuell zu verändern.
- Rollout-Risiken begrenzen: Führen Sie ein Release schrittweise ein und vergleichen Sie die Betriebssignale.
- Rollbacks absichern: Halten Sie Datenbankänderungen bei Bedarf mit der vorherigen Anwendungsversion kompatibel.
- Laufende Arbeit sicher abschließen: Nehmen Sie keine neuen Anfragen mehr an, bevor eine Instanz beendet wird.
- Reduzierte Kapazität testen: Prüfen Sie das Verhalten, wenn eine Instanz oder eine Ausfalldomäne nicht verfügbar ist.
Zum öffentlichen Datenverkehr gehören auch legitime Crawler. Stimmen Sie Caching und Crawler-Zugriff mit Maßnahmen für google seo ab. So bleiben wichtige Seiten erreichbar, ohne wiederholt aufwendige Backend-Vorgänge auszulösen.
Auch für geo seo, also die Optimierung der Sichtbarkeit in generativen Suchsystemen, müssen nützliche öffentliche Inhalte abrufbar bleiben. Legen Sie gezielte Crawler-Regeln und Ressourcenlimits fest, statt jeder automatisierten Anfrage denselben Wert oder dasselbe Risiko zuzuschreiben.
Lasttest und Observability machen die Kapazitätsgrenze sichtbar
Ein Lasttest misst das Systemverhalten unter kontrollierter Nachfrage. Observability hilft, dieses Verhalten anhand von Telemetrie zu erklären. Betrachten Sie RPS, hohe Latenzperzentile, Fehler und Sättigung gemeinsam. So erkennen Sie den Betriebsbereich, der die Nutzeranforderungen noch erfüllt.
Die Dokumentation zu Grafana k6 behandelt skriptbasierte Lastprofile und Schwellenwerte für bestandene oder fehlgeschlagene Tests. Ein sinnvoller Testablauf bildet echte Vorgänge ab, einschließlich Authentifizierung und realistischer Datenzugriffe. Wiederholte Anfragen an einen einzigen gecachten Endpunkt sagen wenig über die Transaktionskapazität aus.
Verkehrsprognosen sollten Produkteinführungen und Kampagnen im Bereich online marketing berücksichtigen. Eine Kampagne, die Nutzer auf einen einzigen aufwendigen Ablauf konzentriert, kann einen anderen Engpass erzeugen als dasselbe Verkehrsvolumen, das sich über die Plattform verteilt.
p95- und p99-Latenz richtig lesen
Die p95 Latenz ist die Antwortzeit, innerhalb derer 95 % der gemessenen Anfragen abgeschlossen sind. p99 beschreibt die entsprechende Grenze für 99 %. Diese Perzentile beziehen sich auf Anfragen, nicht unbedingt auf einzelne Nutzer. Sie zeigen Verzögerungen, die Durchschnittswerte verbergen können.
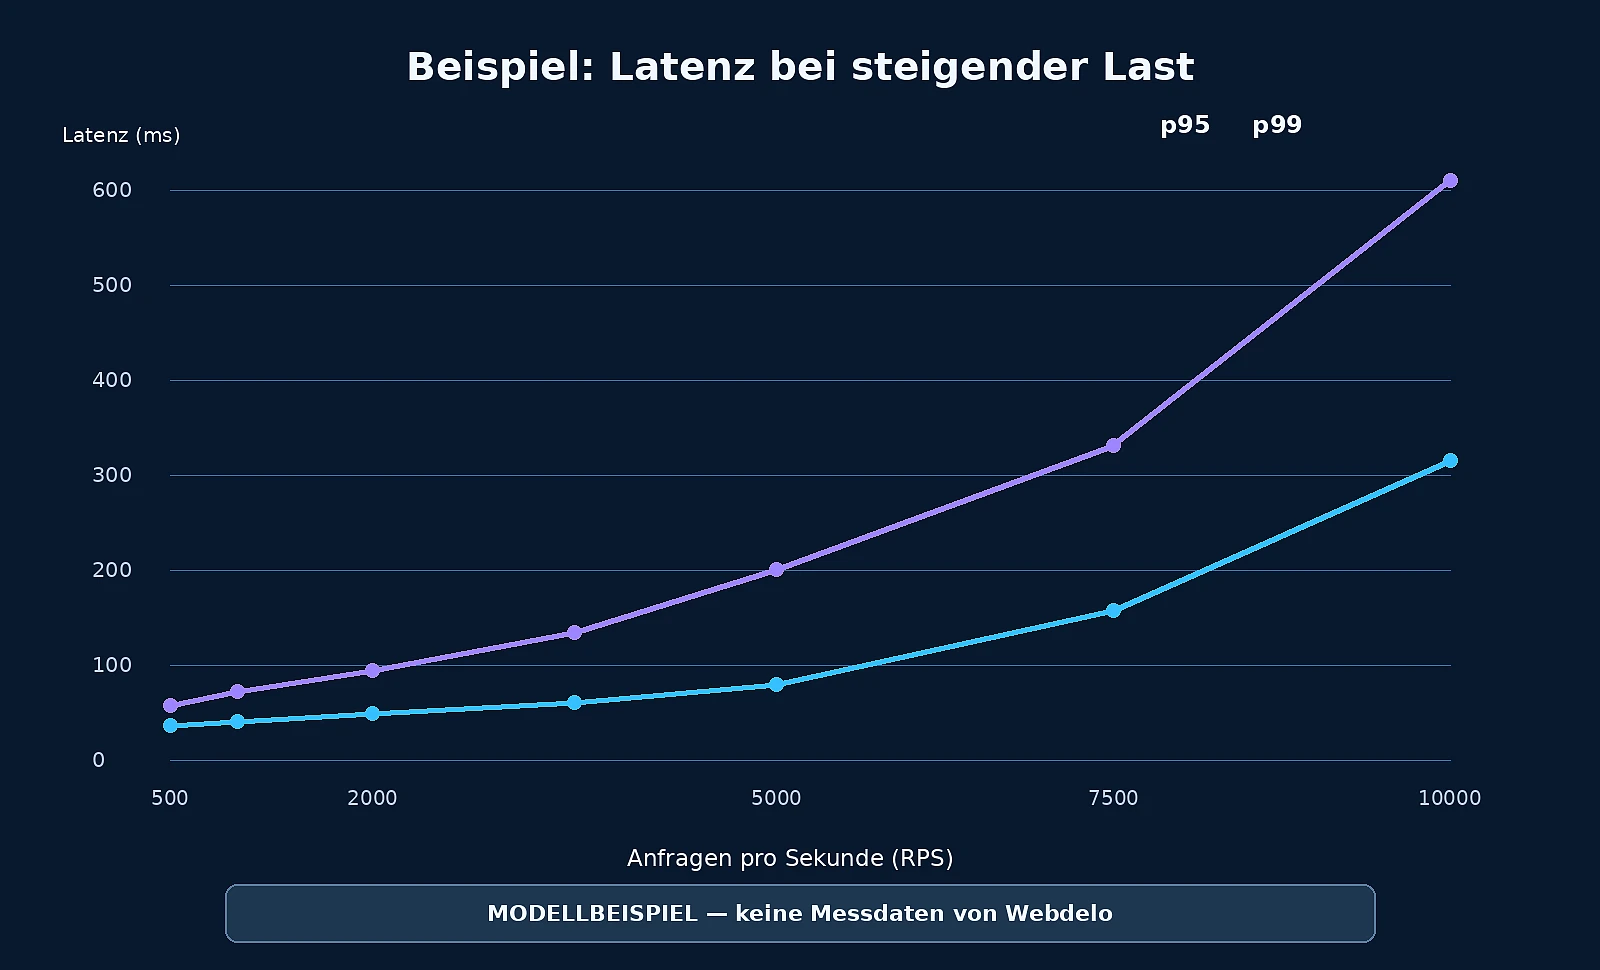
Ein steiler Anstieg der p99-Latenz kann auf wachsende Warteschlangen oder konkurrierende Ressourcenzugriffe hindeuten. Er ist ein Warnsignal, keine allgemeingültige Kapazitätsformel. Die nutzbare Grenze ist das höchste getestete Lastprofil, das die vereinbarten Kriterien erfüllt und genügend Reserve für erwartete Schwankungen und Ausfälle lässt.
Trennen Sie bei der Auswertung der Latenz erfolgreiche und fehlgeschlagene Anfragen. Schnelle Fehlerantworten können die Gesamtwerte besser aussehen lassen, während der nutzbare Durchsatz einbricht. Prüfen Sie außerdem, ob der Lastgenerator die vorgesehene Ankunftsrate tatsächlich erreicht hat.
Ein repräsentatives Testprogramm aufbauen
- Basistests: Ermitteln Sie das Verhalten unter der erwarteten normalen Last.
- Stresstests: Erhöhen Sie die Last, um Grenzen und das Verhalten bei Überlast zu erkennen.
- Lastspitzentests: Prüfen Sie abrupte Änderungen des Datenverkehrs und die Reaktion der Skalierung.
- Dauerlasttests: Halten Sie die Last aufrecht, um Ressourcenlecks, wachsende Rückstände und zunehmenden Speicherbedarf aufzudecken.
Verwenden Sie repräsentative Datenmengen und Zugriffsmuster. Eine Datenbank mit einem kleinen Testdatenbestand kann irreführende Abfragepläne und Cache-Trefferraten liefern. Berücksichtigen Sie aufwendige Nutzerabläufe, statt nur den am häufigsten aufgerufenen Endpunkt zu modellieren.
Der Backend-Durchsatz unterscheidet sich außerdem von der wahrgenommenen Ladegeschwindigkeit einer Seite. Eine webdesign agentur sollte neben den serverseitigen Tests des Entwicklungsteams auch die Größe der Seitenressourcen und deren Ladeverhalten berücksichtigen. Eine schnelle API kann übermäßige Arbeit im Browser nicht ausgleichen.
Metriken, Logs und Traces verknüpfen
OpenTelemetry bietet herstellerneutrale Instrumentierung für Metriken, Logs und Traces. Metriken zeigen Trends, Logs dokumentieren Ereignisse und Traces verfolgen Vorgänge über Komponentengrenzen hinweg.
Instrumentieren Sie wichtige Geschäftsabläufe und führen Sie den Korrelationskontext durch die asynchrone Verarbeitung mit. Erfassen Sie Bereitstellungsversionen, damit sich Verschlechterungen bestimmten Änderungen zuordnen lassen. Halten Sie sensible Kundendaten aus der Telemetrie heraus. Begrenzen Sie außerdem Attribute mit hoher Kardinalität, die das Monitoring teuer machen können.
Fehlertoleranz und Hochverfügbarkeit brauchen getestete Wiederherstellung
Fehlertolerante Systeme bewahren ein festgelegtes Verhalten trotz definierter Fehler. Resilienz umfasst das Abfangen von Störungen und die anschließende Erholung, gegebenenfalls durch einen kontrollierten Betrieb mit eingeschränkten Funktionen. Hochverfügbarkeit hängt von Redundanz, Fehlerisolation und Wiederherstellungsverfahren ab, die auf klare Serviceziele abgestimmt sind.
Festlegen, welche Ausfälle das System verkraften muss
Fehlertoleranz braucht immer ein Fehlermodell. Wenn ein System den Ausfall einer Anwendungsinstanz übersteht, beweist das nicht, dass es auch einen regionalen Ausfall verkraftet. Bestimmen Sie, welche Ausfälle die Architektur abfangen muss und welches Verhalten Nutzer dabei jeweils erleben sollen.
Ein Empfehlungsbereich kann gecachte Inhalte zeigen, wenn seine Abhängigkeit ausfällt. Ein Kontostand muss dagegen seine Korrektheitsanforderungen einhalten. Ein kontrollierter Betrieb mit eingeschränkten Funktionen braucht deshalb eine Produktentscheidung, nicht nur einen Infrastrukturmechanismus.
SLO, SLA und Fehlerbudgets
Ein Service Level Objective, kurz SLO, definiert ein messbares Leistungs- oder Zuverlässigkeitsziel. Ein Service Level Agreement, kurz SLA, ist eine vertragliche Zusage mit festgelegten Konsequenzen. Beides sollte nicht unabhängig von den Mess- und Wiederherstellungsmöglichkeiten festgelegt werden.
Das Google SRE Workbook erläutert SLOs und Fehlerbudgets. Ein Fehlerbudget beschreibt das zulässige Ausmaß an Fehlern innerhalb des Messzeitraums eines Ziels. Es gibt Teams eine Grundlage für die Entscheidung, wann Arbeiten an der Zuverlässigkeit Vorrang vor weiteren Änderungen haben sollten.
Definieren Sie Ziele anhand abgeschlossener Nutzerabläufe. Ein Server, der einen erfolgreichen HTTP-Status zurückgibt, beweist nicht, dass eine Bestellung korrekt angenommen wurde. Die Messung sollte zwischen funktionierender Infrastruktur und erfolgreicher Geschäftsabwicklung unterscheiden.
Zeitüberschreitungen, Wiederholungsversuche und Circuit Breaker
Ausgehende Aufrufe brauchen feste Zeitlimits innerhalb eines durchgängigen Zeitbudgets für die Anfrage. Wiederholungsversuche brauchen Grenzen und Backoff, also wachsende Abstände zwischen den Versuchen. Jitter ergänzt zufällige Schwankungen, damit nicht viele Clients gleichzeitig erneut anfragen.
Ein Circuit Breaker unterbricht vorübergehend Aufrufe an eine fehlerhafte Abhängigkeit. Parallelitätslimits setzen eine weitere Grenze, indem sie einschränken, wie viel Verarbeitungskapazität diese Abhängigkeit belegen kann. Gemeinsam helfen diese Maßnahmen, kaskadierende Ausfälle einzudämmen.
Üben Sie die Wiederherstellung aus Sicherungen und messen Sie das Ergebnis. Definieren Sie akzeptablen Datenverlust und Wiederherstellungszeit vor einem Vorfall. Ein erfolgreicher Sicherungslauf beweist nicht, dass sich die Anwendung mit konsistenten Daten und nutzbaren Zugangsdaten wiederherstellen lässt.
Wie Webdelo technische Entscheidungen für hohe Last einordnet
Unser Ansatz beginnt mit geschäftskritischen Nutzerabläufen und gemessenen Einschränkungen. Wir empfehlen die einfachste Architektur, die die erforderlichen Betriebsziele erfüllt. Öffentlich zugängliche technische Beiträge belegen unsere fachliche Kompetenz, ohne erfundene Kundengeschichten oder nicht verfügbare Leistungszahlen zu benötigen.
Webdelo wurde 2006 gegründet und ist mit Entwicklungsteams in Osteuropa vertreten. Wir entwickeln B2B-Plattformen, ERP-/CRM-Systeme sowie FinTech- und Trading-Werkzeuge. Unser Umfang umfasst auch IoT und Dienste für hohe Last, von der Anforderungsanalyse und Architektur bis zu DevOps und Support.
Zu unserer technischen Führung gehört der Gründer und CTO von Webdelo, Andreas Popov. Sein öffentliches Profil bietet einen Bezugspunkt für die technische Leitung. Webdelo ist außerdem seit 2021 Resident des Moldova IT Park. Das ist eine Unternehmensinformation, keine Leistungszertifizierung.
Was unsere öffentlichen technischen Beiträge zeigen
Der Leitfaden zu Masseneinfügungen mit PostgreSQL und Go dokumentiert Arbeit auf der Datenzugriffsebene. Veröffentlichte Beiträge zum Umgang mit JSON in Go und zu Lasttests im E-Commerce behandeln Codeverhalten und Testgestaltung. Das sind konkrete technische Themen, die die Kapazität einer Plattform beeinflussen.
Eine Veröffentlichung allein belegt keine Kapazitätszahl für eine andere Anwendung. Hardware, Datenbestände und Transaktionssemantik verändern das Ergebnis. Deshalb behandeln wir diese Beiträge als Nachweis fachlicher Arbeit, nicht als übertragbare Benchmark-Aussagen.
Unser Framework für Architekturprüfungen
Eine Architekturprüfung sollte zu Entscheidungen führen, die ein Entwicklungsteam umsetzen kann. Unser vorgeschlagenes Framework verbindet Geschäftsanforderungen mit Nachweisen und daraus abgeleiteten Prioritäten.
- Kritische Nutzerabläufe erfassen. Identifizieren Sie Vorgänge, die Umsatz erzeugen oder das Kundenvertrauen schützen. Halten Sie Anforderungen an Latenz, Korrektheit und Wiederherstellung fest.
- Das Lastprofil bestimmen. Dokumentieren Sie die aktuelle Nachfrage, das erwartete Wachstum und die Eigenschaften der Daten. Trennen Sie beobachtete Fakten von Planungsannahmen.
- Die begrenzende Ressource finden. Lokalisieren Sie mit Telemetrie und kontrollierten Tests Wartezeiten, Ressourcenkonkurrenz und fehlgeschlagene Vorgänge. Berücksichtigen Sie Kontingente von Abhängigkeiten und betriebliche Grenzen.
- Mögliche Maßnahmen vergleichen. Prüfen Sie lokale Verbesserungen, bevor Sie Dienste ausgliedern oder Software neu schreiben. Beschreiben Sie Umsetzungsaufwand, Betriebskosten und Migrationsrisiken.
- Abnahmenachweise definieren. Legen Sie fest, wie das Team Verbesserungen nachweisen und Verschlechterungen erkennen wird. Weisen Sie die Verantwortung für Tests und die Nachverfolgung im Produktionsbetrieb zu.
Zu den Ergebnissen sollten eine Übersicht der Abhängigkeiten und eine nach Priorität geordnete Engpassliste gehören. Architekturoptionen brauchen ausdrückliche Annahmen und Abwägungen. Eine Kapazitätsaussage sollte das getestete Lastprofil und die Umgebung benennen, statt eine einzelne RPS-Zahl ohne Kontext zu präsentieren.
Wo wir gängige Empfehlungen hinterfragen
Wir hinterfragen Microservices-Vorschläge, wenn weiterhin eine ineffiziente Abfrage der begrenzende Faktor ist. Diese Abfrage hinter eine Netzwerkgrenze zu verschieben, ändert nichts an der eigentlichen Arbeit. Es schafft zusätzlich eine weitere Bereitstellungseinheit und eine weitere mögliche Fehlerquelle.
Außerdem empfehlen wir regelmäßige Lasttests statt einer einmaligen Prüfung vor dem Start. Änderungen in der Datenstruktur können auch ohne größeres Code-Release zu Verschlechterungen führen. Zusagen zur Zuverlässigkeit sollten sich aus gemessenen Fähigkeiten und einem vereinbarten Umfang ergeben, ohne bedingungsloses Verfügbarkeitsversprechen.
Architekturfehler, die Kosten ohne zusätzliche Kapazität erhöhen
Die teuersten Fehler entstehen, wenn Infrastrukturentscheidungen von Erkenntnissen über die tatsächliche Last getrennt werden. Eine verfrühte Verteilung und unbegrenzte Parallelität können sowohl die Kosten als auch das Ausfallrisiko erhöhen. Prüfen Sie vor der Freigabe jeder vorgeschlagenen Verbesserung, durch welchen Mechanismus sie wirken soll.
- Die falsche Schicht skalieren: Zusätzliche Anwendungsinstanzen können einen ausgelasteten Datenbank-Schreibpfad nicht entlasten.
- Veränderliche Daten zwischen Diensten teilen: Direkte Zugriffe auf die Tabellen anderer Dienste koppeln Releases und verwässern Verantwortlichkeiten.
- Sitzungen auf einer Instanz halten: Lokaler Zustand erschwert Lastverteilung und Instanzaustausch.
- Synchrone Abhängigkeitsketten aufbauen: Jeder erforderliche Aufruf schafft eine weitere mögliche Quelle für Verzögerungen und Ausfälle.
- Ohne Grenzen erneut versuchen: Wiederholte Versuche können Überlast verstärken und Geschäftsvorgänge mehrfach auslösen.
- Warteschlangen ohne Regeln für Rückstände einsetzen: Verzögerte Aufgaben sammeln sich an, bis Fristen oder Speichergrenzen überschritten werden.
- Nur Durchschnittswerte beobachten: Zusammengefasste Latenzwerte können langsame kritische Abläufe und wachsende Verzögerungen am oberen Rand verbergen.
- Betriebskosten ignorieren: Komponenten brauchen Updates, Wiederherstellungsverfahren und klar verantwortliche Personen.
Eine gemeinsam genutzte Datenbank kann eine bewusste Migrationsstufe sein. Dokumentieren Sie ihre Einschränkungen und die Kriterien für das Ende dieser Phase, statt die Dienste als vollständig unabhängig zu beschreiben. Architekturbezeichnungen sollten die betriebliche Realität widerspiegeln.
Checkliste: Ist Ihre Architektur für den nächsten Wachstumsschritt bereit?
Eine Plattform ist bereit für Wachstum, wenn das Team ihre Kapazität, ihr Fehlerverhalten und ihren Wiederherstellungsweg nachweisen kann. Nutzen Sie diese Checkliste zur Prüfung von Nachweisen, nicht zum Zählen installierter Technologien. Kennzeichnen Sie jeden Punkt als überprüft, ungetestet oder nicht zutreffend.
Nachweise zu Messung und Kapazität
- Für kritische Nutzerabläufe gibt es messbare Latenz- und Erfolgsziele.
- Dashboards zeigen eingehende Last, nutzbaren Durchsatz, p95/p99, Fehler und Sättigung.
- Das Alter wartender Aufgaben und der Verarbeitungsrückstand sind dort sichtbar, wo asynchrone Arbeit wichtig ist.
- Das getestete Lastprofil enthält repräsentative Daten und die erwartete Mischung der Vorgänge bei Spitzenlast.
- Kapazitätsreserven berücksichtigen Wachstum, Skalierungsverzögerungen und relevante Ausfälle.
Nachweise zu Architektur und Daten
- Anwendungsinstanzen lassen sich austauschen, ohne erforderliche Sitzungsdaten zu verlieren.
- Skalierungstests berücksichtigen Verbindungs- und Kontingentgrenzen nachgelagerter Systeme.
- Die Anforderungen an Lesekonsistenz bestimmen, ob Replikate geeignet sind.
- Für abgelaufene Cache-Einträge und einen nicht verfügbaren Cache gibt es getestete Fehlerabläufe.
- Asynchrone Abläufe haben klare Verantwortlichkeiten, Regeln für Wiederholungsversuche und Abschlussfristen.
Nachweise zu Wiederherstellung und Bereitstellung
- Ausgehende Aufrufe haben Zeitlimits und begrenzte Parallelität.
- Wiederholte Vorgänge bleiben durch Idempotenz oder gleichwertige Kontrollen korrekt.
- Die Wiederherstellung aus Sicherungen wurde geübt und die Ergebnisse wurden dokumentiert.
- Stufenweise Releases und Rollback-Verfahren decken Anwendungs- und Datenänderungen ab.
- Lasttests haben klare Bestehens- und Fehlerkriterien und laufen nach relevanten Änderungen.
Priorisieren Sie ungeprüfte Punkte nach ihren geschäftlichen Folgen. Ein ungetesteter Wiederholungsablauf bei Zahlungen kann wichtiger sein als eine verlangsamte Berichtserstellung. Aus der Checkliste sollten konkrete Maßnahmen, Verantwortliche und Abnahmenachweise entstehen.
Eine evidenzbasierte Architekturbewertung anfordern
Eine Architekturbewertung kann Bedenken zum Wachstum in einen priorisierten technischen Plan überführen. Die Prüfung sollte das Lastprofil bestimmen, wahrscheinliche Engpässe identifizieren und Verbesserungsoptionen nach Kosten und Risiken vergleichen. Ihre Schlussfolgerungen sollten getestete Erkenntnisse von Annahmen unterscheiden.
Nützliche Grundlagen sind Architekturdiagramme, aktuelle Telemetrie und erwartete Änderungen der Nachfrage. Aufzeichnungen zu Vorfällen und Einschränkungen bei der Bereitstellung helfen zu erklären, wo theoretische Lösungen praktisch ungeeignet sein können.
Fordern Sie bei Webdelo eine Bewertung Ihrer Architektur und ihrer Eignung für hohe Last an. Bringen Sie Ihre kritischen Nutzerabläufe und Wachstumserwartungen mit. So kann sich das Gespräch auf Kapazität, Zuverlässigkeit und die nächste begründete Investition konzentrieren.
Ein gemeinsames Vokabular für Architekturentscheidungen
Gespräche über hohe Last funktionieren besser, wenn technische und geschäftliche Stakeholder dieselben Definitionen verwenden. Diese Begriffe beschreiben Lastprofile, Betriebsverhalten und Zusagen zur Zuverlässigkeit. Jeder davon muss mit einem konkreten System und Messkontext verbunden werden.
- RPS
- Anfragen pro Sekunde. Unterscheiden Sie eingehende Anfragen von erfolgreich abgeschlossenen Vorgängen.
- p95- und p99-Latenz
- Antwortzeitgrenzen, innerhalb derer 95 % beziehungsweise 99 % der gemessenen Anfragen abgeschlossen sind.
- Sättigung
- Belastung einer begrenzten Ressource, häufig sichtbar durch Wartezeiten oder ausgeschöpfte Kapazität.
- Queue-Lag
- Der Abstand zwischen eingehender und verarbeiteter Arbeit, ausgedrückt als Rückstand, Offset-Differenz oder zeitliche Verzögerung.
- Horizontale Skalierung
- Das Hinzufügen von Instanzen oder Knoten, um Arbeit zu verteilen.
- Lesereplikat
- Eine für Lesezugriffe verwendete Datenbankkopie, die hinter den neuesten Änderungen der Primärdatenbank zurückliegen kann.
- Idempotenz
- Die Eigenschaft, dass die Wiederholung eines Vorgangs keine zusätzliche beabsichtigte geschäftliche Wirkung erzeugt.
- Circuit Breaker
- Ein Mechanismus, der Aufrufe an eine fehlerhafte Abhängigkeit vorübergehend blockiert und später prüft, ob sie wieder funktioniert.
- SLO
- Ein Service Level Objective, das ein messbares Ziel für einen festgelegten Zeitraum definiert.
- SLA
- Ein Service Level Agreement, das vertragliche Zusagen und Konsequenzen festlegt.
- Fehlerbudget
- Das durch ein SLO innerhalb seines Messzeitraums erlaubte Ausmaß an Fehlern.
- Observability
- Die Fähigkeit, Systemverhalten anhand von Signalen wie Metriken, Logs und Traces zu verstehen.
Gemessene Grenzen sollen die nächste Architekturentscheidung leiten
Hohe Last ist eine Frage des Lastprofils und des Geschäftsrisikos. Eine tragfähige Architektur beginnt mit klaren Servicezielen und Nachweisen über die aktuelle Grenze. Zusätzliche Infrastruktur ist dann gerechtfertigt, wenn sie diese Grenze zu Betriebskosten beseitigt, die das Team tragen kann.
Ein modularer Monolith kann eine starke Grundlage bieten. Ereignisgesteuerte Muster lassen sich mit jedem Bereitstellungsmodell kombinieren. Zuverlässigkeit entsteht durch kontrollierte Abhängigkeiten und getestete Wiederherstellung. Die nächste sinnvolle Entscheidung ist die kleinste Änderung, deren Nutzen Sie unter repräsentativer Last nachweisen können.
Häufig gestellte Fragen
Wann braucht ein System tatsächlich eine Architektur für High Load?
Eine solche Architektur brauchen Sie, wenn die Nachfrage die praktischen Grenzen des Systems erreicht und die geforderte Leistung oder Korrektheit gefährdet. Einen allgemeingültigen RPS-Schwellenwert gibt es nicht. Eine Checkout-API mit 200 RPS kann schwerer zu skalieren sein als eine statische Website mit 20.000 RPS hinter einem CDN. Erstellen Sie zuerst ein Lastprofil mit Durchsatz, Parallelität, p95/p99-Latenz, Fehlern, Auslastung, Datenwachstum und Queue-Rückstand für jede kritische User Journey.
Was bricht bei wachsendem Datenverkehr meist zuerst ein?
In transaktionsintensiven Systemen ist die Datenbank oft der erste Engpass: fehlende Indizes, Sperrkonflikte, N+1-Abfragen und erschöpfte Connection Pools. Auch Cache-Stampedes, langsame synchrone Integrationen und wachsende Queues können an ihre Grenzen stoßen, während die CPU der Anwendung noch frei wirkt. Finden Sie zuerst heraus, wo Anfragen warten, bevor Sie Server hinzufügen. Zusätzliche Instanzen können das Problem sogar verschärfen, weil jede einen weiteren Pool zur selben Datenbank öffnet.
Sollten wir für mehr Last vom Monolithen auf Microservices umsteigen?
Nur wenn Sie unabhängige Verantwortung, Bereitstellung oder Skalierung brauchen und Ihre Teams Dienste im Betrieb verantworten können. Webdelo empfiehlt meist zuerst einen modularen Monolithen: eine Bereitstellung mit klaren fachlichen Grenzen und geregelter Datenhoheit. Ein Dienst lohnt sich, wenn ein Modul ein anderes Lastprofil oder einen anderen Release-Rhythmus hat. Ist eine langsame Abfrage der Engpass, löst eine Netzwerkgrenze das Problem nicht und schafft eine weitere Fehlerquelle.
Ist eine ereignisgesteuerte Architektur eine Alternative zu Microservices?
Nein. Ereignisgesteuertes Design ist ein Kommunikationsmuster, kein konkurrierendes Bereitstellungsmodell. Ein Monolith kann Ereignisse an Hintergrund-Worker senden, und Microservices können synchrone APIs, Ereignisse oder beides nutzen. Wählen Sie das Muster je Geschäftsvorgang: Benachrichtigungen und Berichte dürfen warten, eine Lagerreservierung braucht dagegen oft sofort ein Ergebnis.
Warum sollte man im Lasttest p95- und p99-Latenz statt Durchschnittswerten betrachten?
Durchschnittswerte verbergen die langsamen Ausreißer, die Nutzer kritischer Abläufe tatsächlich spüren. Ein starker Anstieg bei p99 zeigt oft wachsende Warteschlangen oder Ressourcenkonflikte, bevor sich der Durchschnitt ändert. Lesen Sie Perzentile zusammen mit RPS, Fehlern und Auslastung und trennen Sie erfolgreiche von fehlgeschlagenen Anfragen, denn schnelle Fehler lassen die Latenz besser aussehen. Die nutzbare Kapazität ist die höchste getestete Last, die Ihre Kriterien mit ausreichend Reserve erfüllt.
Wie machen Sie Wiederholungsversuche und erneute Nachrichtenzustellung sicher?
Setzen Sie auf Idempotenz: Wird derselbe Vorgang zweimal verarbeitet, darf kein zweiter geschäftlicher Effekt entstehen. Üblich ist, eine eindeutige Vorgangs-ID in derselben Datenbanktransaktion zu speichern wie die geschützte Änderung. Muss eine Datenbankänderung auch ein Ereignis veröffentlichen, hält ein Transactional Outbox beides konsistent. Begrenzte Timeouts, Backoff mit Jitter und Obergrenzen für Wiederholungen verhindern, dass Retries die Überlast verstärken.
Was liefert eine Architekturbewertung für High Load von Webdelo?
Sie macht aus Wachstumssorgen einen priorisierten technischen Plan. Typische Ergebnisse sind eine Abhängigkeitskarte, eine priorisierte Liste der Engpässe, Architekturoptionen mit klaren Abwägungen und eine Kapazitätsaussage, die sich auf die getestete Last und Umgebung bezieht. Hilfreich sind Architekturdiagramme, aktuelle Telemetrie, erwartete Nachfrageänderungen, Incident-Berichte und Einschränkungen bei der Bereitstellung. Die Ergebnisse trennen getestete Nachweise von Annahmen.